
Todo mundo tem backup de banco. Pouca gente tem backup que já foi restaurado. O Databasus ataca justamente essa diferença: é uma ferramenta self-hosted, com interface web, que agenda dumps de PostgreSQL, MySQL, MariaDB e MongoDB, comprime, criptografa, manda para S3, Google Drive, SFTP ou disco local, avisa no Telegram ou no Slack e, para PostgreSQL, ainda sobe um container descartável, restaura o backup e conta as linhas de cada tabela para provar que ele funciona.
O projeto é open source sob licença Apache 2.0, escrito em Go (backend) e TypeScript (frontend), e roda em Docker. Neste post a gente vê como ele funciona por dentro, instala, configura um backup de MariaDB/MySQL, entende o PITR do PostgreSQL 17 e monta o agente de verificação de restore.
De Postgresus a Databasus
O projeto nasceu como Postgresus, criado por Rostislav Dugin, e era só para PostgreSQL. Quando ganhou suporte a MySQL, MariaDB e MongoDB, o nome deixou de fazer sentido e virou Databasus, no fim de 2025 (as issues de migração “Upgrade path from Postgresus to Databasus” são de dezembro de 2025). O repositório antigo RostislavDugin/postgresus hoje redireciona para databasus/databasus.
Em setembro de 2026 o repositório passa de 8.600 estrelas, a imagem no Docker Hub tem mais de 1,9 milhão de pulls e a versão mais recente é a v3.60.0, de 22/09/2026. O ritmo de releases é alto, então confira a página de releases antes de fixar uma versão.
Faz backup de MySQL e MariaDB? Sim, mas só lógico
Essa é a pergunta que mais importa para quem roda LAMP. A resposta curta: sim, com uma limitação que precisa ficar clara.
| Banco | Versões | Tipo de backup | Ferramenta usada |
|---|---|---|---|
| PostgreSQL | 14, 15, 16, 17 e 18 | lógico e físico (físico só no 17+) | pg_dump, pg_basebackup, pg_receivewal |
| MySQL | 5.7, 8.0, 8.4, 9 e 26 | só lógico | mysqldump |
| MariaDB | 5.5, 10, 11, 12 e 13 | só lógico | mariadb-dump |
| MongoDB | 4.2+, 5, 6, 7 e 8 | só lógico | dump nativo |
Para MySQL, o Databasus chama o mysqldump oficial; para MariaDB, usa o mariadb-dump nativo, e não o dump do MySQL, o que evita incompatibilidades com recursos específicos do MariaDB. Os binários de cada versão vêm embutidos na imagem, então você não instala cliente nenhum. Olhando o código do backend, os parâmetros passados ao dump são estes:
--single-transaction: snapshot consistente em InnoDB, sem travar as tabelas;--routines,--triggerse--events: procedures, functions, triggers e eventos agendados entram no backup;--quicke--max-allowed-packet=1G: linhas em streaming, sem carregar tabelas inteiras na memória;--no-tablespaces: dispensa o privilégioPROCESS;- compressão de rede zstd no MySQL 8.0+ (no 5.7 cai para a compressão antiga).
Tem um cuidado com MariaDB Galera: no restore, o Databasus desliga a replicação só naquela sessão (wsrep_on), para que o dump não seja replicado linha a linha pelo cluster. Isso pode ser desativado na configuração do banco. Quem roda o cluster Galera vai gostar desse detalhe.
A senha vai num .my.cnf temporário com permissão 0600, nunca na linha de comando, então não aparece no ps nem nos logs.
O que você não tem em MySQL/MariaDB: backup físico, incremental ou PITR com binlog. Para bancos grandes (o próprio site do projeto fala em algo acima de 100 GB) ou quando você precisa voltar ao segundo exato antes de um DELETE errado, continue com mariabackup/XtraBackup e binlog, como mostrei no post do cluster MariaDB Galera com mariabackup. A verificação automática de restore, descrita mais abaixo, também é só para PostgreSQL por enquanto. Para o banco de um WordPress, um GLPI ou um Nextcloud de porte médio, o dump diário com retenção GFS resolve bem.
Como ele funciona por dentro
O Databasus roda longe do banco. Ele se conecta pela rede, como qualquer cliente, e puxa o dump em streaming, bloco a bloco. Nada é instalado no servidor de banco. Se o banco estiver numa rede fechada, ele alcança por túnel SSH através de um bastion. Isso também significa que funciona com bancos gerenciados (RDS, Cloud SQL, Azure Database), que não deixam instalar nada no host.
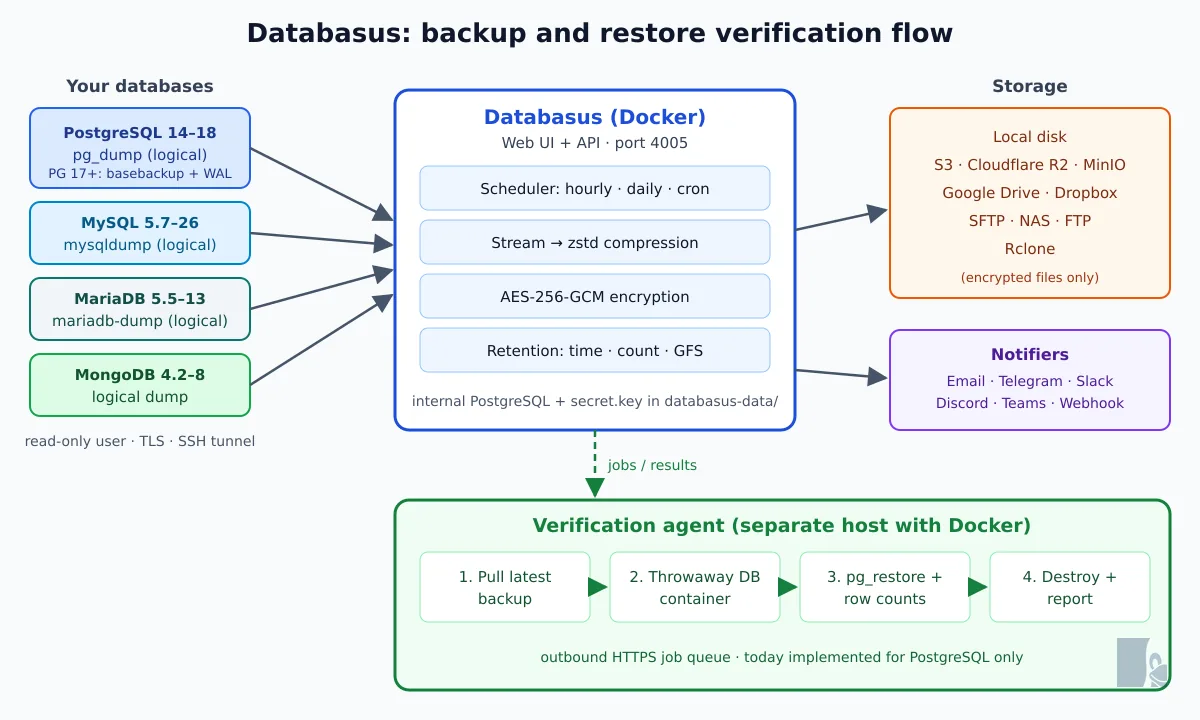
O fluxo de cada backup:
- o agendador dispara no horário (a cada hora, diário, semanal, mensal ou cron);
- o dump sai do banco em streaming e é comprimido com zstd (no PostgreSQL, formato custom do
pg_dumpcom zstd nível 5); - cada arquivo é criptografado com AES-256-GCM, com chave própria derivada da chave mestra, do ID do backup e de um salt aleatório;
- o arquivo vai para o storage escolhido, que só enxerga dado cifrado;
- a política de retenção apaga os antigos: por tempo, por quantidade, por tamanho ou no esquema GFS (avô-pai-filho, com cópias por hora, dia, semana, mês e ano);
- o notificador avisa sucesso ou falha.
O estado interno (agendamentos, usuários, histórico) fica num PostgreSQL embutido na própria imagem, em databasus-data/pgdata, e as credenciais dos bancos ficam cifradas com a chave databasus-data/secret.key. Guarde essa chave em outro lugar: sem ela, os backups criptografados viram lixo.
Instalação
São quatro caminhos: script automático, docker run, Docker Compose e Helm. Se Docker ainda é novidade, o post A história do Docker dá o contexto.
Script (Debian/Ubuntu)
Instala Docker e Compose se faltarem, coloca tudo em /opt/databasus/ e configura o início automático no boot:
sudo apt-get install -y curl
curl -sSL https://raw.githubusercontent.com/databasus/databasus/refs/heads/main/install-databasus.sh -o install-databasus.sh
less install-databasus.sh     # leia antes de rodar como root
sudo bash install-databasus.sh
Docker Compose
É o caminho que eu prefiro, porque fica versionado junto com o resto da infraestrutura:
services:
  databasus:
    container_name: databasus
    image: databasus/databasus:latest
    ports:
      - "127.0.0.1:4005:4005"
    volumes:
      - ./databasus-data:/databasus-data
    restart: unless-stopped
    healthcheck:
      test: ["CMD", "databasus", "healthcheck"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 60s
mkdir -p /opt/databasus && cd /opt/databasus
# salve o docker-compose.yml acima aqui
docker compose up -d
docker compose psPubliquei a porta só em 127.0.0.1 de propósito: a interface guarda credenciais de todos os seus bancos, então ela fica atrás de um proxy reverso com TLS, não exposta crua na internet. Se o Docker Hub limitar o pull, a mesma imagem está em ghcr.io/databasus/databasus:latest. Em produção, troque latest por uma tag fixa.
Kubernetes com Helm
helm install databasus oci://ghcr.io/databasus/charts/databasus \
  -n databasus --create-namespace \
  --set ingress.enabled=true \
  --set ingress.hosts[0].host=backup.exemplo.com.br
O chart também aceita service.type=LoadBalancer, NodePort e HTTPRoute do Gateway API. Em bare metal, o MetalLB entrega o IP do LoadBalancer.
Compilando a imagem a partir do código
Se a sua política exige imagem construída em casa (auditoria, registry interno, sem pull do Docker Hub), o Dockerfile na raiz do repositório faz tudo em estágios: frontend com Node 24 e pnpm, backend e agente de verificação com Go 1.26, e imagem final em debian:bookworm-slim com os clientes de banco já embutidos no repositório (assets/tools, uns 320 MB de binários de pg_dump, mysqldump e mariadb-dump por versão). Use sempre uma tag de release, não a main:
git clone --depth 1 --branch v3.60.0 https://github.com/databasus/databasus.git
cd databasus
docker build --build-arg APP_VERSION=v3.60.0 -t registry.exemplo.com.br/databasus:v3.60.0 .
docker push registry.exemplo.com.br/databasus:v3.60.0
No meu teste, numa máquina com cache vazio, o build levou cerca de 2 minutos e 15 segundos e gerou uma imagem de 800 MB, o mesmo tamanho da oficial. O APP_VERSION aparece na interface e em /api/v1/system/version. No docker-compose.yml, basta trocar a linha image: pela sua tag.
Proxy reverso com nginx
server {
    listen 443 ssl http2;
    server_name backup.exemplo.com.br;

    ssl_certificate     /etc/letsencrypt/live/backup.exemplo.com.br/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/backup.exemplo.com.br/privkey.pem;

    client_max_body_size 0;

    location / {
        proxy_pass http://127.0.0.1:4005;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
    }
}
Abra https://backup.exemplo.com.br e crie a primeira conta: ela vira a administradora da instância, então faça isso logo depois de subir, antes de qualquer outra pessoa chegar na tela.
Backup de MariaDB e MySQL passo a passo
1. Usuário só de leitura
O Databasus trabalha por padrão com usuário somente leitura e checa os privilégios antes de rodar. Pelo código, SELECT e SHOW VIEW são obrigatórios; sem TRIGGER e EVENT o backup não falha, mas deixa triggers e eventos de fora. Então dê os quatro:
CREATE USER 'databasus'@'10.0.0.50' IDENTIFIED BY 'troque-esta-senha';
GRANT SELECT, SHOW VIEW, TRIGGER, EVENT ON wordpress.* TO 'databasus'@'10.0.0.50';
FLUSH PRIVILEGES;
Troque 10.0.0.50 pelo IP do servidor do Databasus e wordpress pelo seu schema. Se o MariaDB escuta só em 127.0.0.1, não abra a porta 3306: use o túnel SSH embutido.
2. Cadastrar o banco
- New Database → escolha MySQL ou MariaDB;
- host, porta, usuário, senha e banco (ou túnel SSH e TLS);
- agenda: por exemplo diário às 03:00, fora do horário de pico;
- storage: disco local, S3 (AWS, MinIO, Backblaze B2), Cloudflare R2, Google Drive, Dropbox, SFTP, FTP ou qualquer destino do rclone;
- retenção: GFS é o padrão sensato, por exemplo 7 diários, 4 semanais, 12 mensais;
- notificação: Telegram, Slack, Discord, Teams, Mattermost, e-mail ou webhook.
Salvando, ele valida conexão e privilégios, detecta a versão do servidor sozinho e já aponta se falta algum grant. Dois detalhes que vi no teste: ao ligar os backups, ele dispara o primeiro backup na hora, então confira antes se a opção Encryption está em Encrypted (é o padrão da interface para backup lógico). Sem criptografia, o arquivo no storage é um .zst legível por qualquer um com acesso ao bucket.
Um bom macete da FAQ do projeto: se você tem réplica, aponte o backup para ela. O --single-transaction não para a replicação e tira a carga do primário.
3. Restaurar
O dump é um mysqldump padrão, comprimido com zstd. Baixe o backup pela interface (ele sai já descriptografado, como .sql.zst) e restaure em qualquer MySQL/MariaDB, em outra versão ou outro provedor. A interface mostra o comando exato de cada backup; o formato é este:
zstd -dc wp-lab_backup_2026-09-24_10-23-28.sql.zst | mariadb -h 127.0.0.1 -u root -p wordpress_restoreFaça isso pelo menos uma vez, num banco de teste, antes de precisar. É o único jeito de saber quanto tempo o restore leva de verdade.
PostgreSQL: físico, incremental e PITR
Aqui o Databasus vai bem além do dump. A partir do PostgreSQL 17, que trouxe backup incremental nativo em nível de bloco (desenvolvido por Robert Haas, com ajuda de David Steele, autor do pgBackRest), ele faz:
- full com
pg_basebackup, transmitido direto para o Databasus; - incremental com
pg_basebackup --incremental: o servidor, comsummarize_wal = on, sabe quais blocos mudaram e só eles trafegam; - WAL streaming contínuo com
pg_receivewal, que fecha a corrente entre um backup e outro.
No restore, o pg_combinebackup junta o full com os incrementais num diretório de dados e o PostgreSQL reaplica o WAL até o instante que você escolher. É PITR de verdade, com RPO perto de zero. Tudo pelo protocolo de replicação, remoto, sem instalar nada no servidor do banco.
No servidor PostgreSQL, habilite o resumo de WAL e libere replicação para o usuário do backup:
sudo -u postgres psql -c "ALTER SYSTEM SET summarize_wal = on;"
sudo -u postgres psql -c "SELECT pg_reload_conf();"
sudo -u postgres psql -c "CREATE ROLE databasus WITH LOGIN REPLICATION PASSWORD 'troque-esta-senha';"
# pg_hba.conf: host replication databasus 10.0.0.50/32 scram-sha-256
Nas versões 14 a 16, só o backup lógico com pg_dump está disponível.
Uma nota de histórico: versões antigas usavam um agente de backup instalado no host do banco. O projeto admite na FAQ que foi um erro (RTO longo, duas coisas para configurar, não roda em RDS) e removeu. Quem ainda tem backups desse tipo pode ficar na v3.42.0, a última que os suporta; a atualização avisa antes de mexer. O raciocínio está no ADR-0009.
Verificação de restore: o backup testado de verdade
Um backup que terminou sem erro não é um backup que restaura. Checksum pega bit podre no arquivo, mas não diz se o dump está completo. O código de saída diz que o comando rodou, mas não pega um usuário sem permissão num objeto, uma extensão ausente ou um tablespace diferente, casos em que objetos somem do dump em silêncio.
A verificação de restore resolve isso restaurando de fato. Um agente de verificação, um binário Go pequeno que roda numa máquina sua com Docker:
- pega o backup mais recente na fila do Databasus (conexão HTTPS de saída, nada precisa ser aberto para dentro);
- sobe um container de banco descartável na mesma versão major;
- roda o restore com a ferramenta nativa e confere o tamanho restaurado;
- conta as linhas de cada tabela;
- destrói o container e manda o relatório.
Limite atual: no código do agente, o restore só está implementado para PostgreSQL (pg_restore, com imagem Docker só de Postgres). Para MySQL e MariaDB, o teste de restore continua sendo manual, como na seção anterior.
Subindo o agente
Em Settings → Verification agents → Create verification agent, dê um nome (verificador-01) e copie o token, que só aparece uma vez. Na máquina de verificação:
curl -L -o verification-agent \
  "https://backup.exemplo.com.br/api/v1/system/verification-agent?arch=amd64" \
  && chmod +x verification-agent

./verification-agent start \
  --databasus-host=https://backup.exemplo.com.br \
  --agent-id=<AGENT_ID> \
  --token=<TOKEN> \
  --max-cpu=2 \
  --max-ram-mb=2048 \
  --max-disk-gb=20 \
  --max-concurrent-jobs=1
Troque amd64 por arm64 em ARM. Os --max-* são orçamentos totais, divididos entre os jobs simultâneos, com piso de 1 CPU e 512 MB por job. O disco é o que mais erra: cada job precisa do tamanho do backup, mais o tamanho do banco restaurado, mais uma folga de até 5 GB. O Databasus precisa estar em https://; HTTP puro só com --allow-insecure-http, para laboratório.
O start vira daemon e grava as flags em databasus-verification.json. Para rodar sob systemd, use run, que fica em primeiro plano e lê as mesmas flags salvas. Faça o primeiro start dentro de /opt/databasus-agent, para o JSON ficar lá:
# /etc/systemd/system/databasus-verification.service
[Unit]
Description=Databasus verification agent
After=docker.service network-online.target
Requires=docker.service

[Service]
WorkingDirectory=/opt/databasus-agent
ExecStart=/opt/databasus-agent/verification-agent run
Restart=on-failure

[Install]
WantedBy=multi-user.target
cd /opt/databasus-agent
./verification-agent stop # para o daemon criado pelo start
sudo systemctl daemon-reload
sudo systemctl enable --now databasus-verification
./verification-agent statusSe o systemd ainda é território estranho, o post dedicado ajuda.
Agendando
Nas configurações de cada banco, ligue Scheduled verification e escolha:
- After backup: todo backup bem-sucedido é verificado em seguida. A garantia mais forte. Se chega backup novo antes de terminar a verificação anterior, a pendente é cancelada e só o mais recente espera na fila;
- hourly, daily, weekly, monthly com horário;
- cron em UTC, por exemplo
0 4 * * 0(domingo às 04:00 UTC).
As notificações de sucesso e de falha são independentes. Ligue só a de falha para não criar ruído. Cada verificação mostra linha do tempo, código de saída, tamanho restaurado, número de schemas e tabelas e a contagem de linhas por tabela.
Testei no laboratório
Antes de escrever, subi a v3.60.0 em containers locais: a imagem oficial e a compilada a partir do Dockerfile, apontando para um MariaDB 11.8 e um MySQL 8.4 com tabela, view, trigger e evento, usando o usuário com só SELECT, SHOW VIEW, TRIGGER, EVENT. O resultado:
- a versão do servidor foi detectada sozinha e os privilégios foram registrados como
EVENT,SELECT,SHOW VIEW,TRIGGER; - backups de MariaDB e MySQL concluídos em menos de um segundo, com status
COMPLETED; - no storage local, o backup criptografado é um blob opaco, acompanhado de um
.metadatacom salt e IV; sem criptografia, é um.zstcom o SQL legível; - o download pela interface já sai descriptografado (
.sql.zst); restaurado comzstd -dcnum banco novo, voltaram as linhas, a view, o trigger no MariaDB e o evento no MySQL; - a imagem compilada localmente se comportou igual à oficial.
Segurança
- AES-256-GCM nos arquivos de backup e nos segredos guardados (senhas, tokens, strings de conexão), que não aparecem nem em mensagens de erro;
- storage “zero trust”: o bucket só recebe arquivo cifrado, então um vazamento do S3 não entrega seus dados;
- usuário somente leitura por padrão;
- workspaces com papéis viewer, member, admin e owner, e log de auditoria, exportável via OpenTelemetry;
- 2FA por código enviado por e-mail no login com senha; login com Google ou GitHub também é aceito.
No lado do código, o pipeline roda CodeQL, gitleaks, semgrep, Dependabot, Trivy na imagem e no Dockerfile, e cada PR faz ciclos completos de backup e restore contra containers reais de todas as versões suportadas. O README também é franco sobre IA: o projeto entrou nos programas Claude for Open Source e Codex for Open Source em março de 2026, usa IA para revisão e busca de falhas e rejeita PRs “vibe code”.
Não esqueça do backup do próprio Databasus
Parece óbvio, mas é o ponto que derruba a estratégia inteira. Em /opt/databasus/databasus-data/ (ou onde você montou o volume):
secret.key: obrigatório. Só com ele já dá para recuperar os backups sem o Databasus;pgdata/: configurações, agendamentos e histórico, necessário para reconstruir a interface;backups/: se você usa storage local.
cd /opt/databasus
docker compose stop
tar czf /root/databasus-data-$(date +%F).tar.gz databasus-data/
docker compose start
Guarde o secret.key num cofre de senhas, como o Vaultwarden, fora do servidor. Para migrar de máquina, basta recriar a pasta databasus-data com esses arquivos e subir o container. Se a senha de admin se perder:
docker exec -it databasus ./main --list-admins
docker exec -it databasus ./main --new-password="NovaSenhaForte123" --email="admin@exemplo.com.br"
Quando usar, quando não usar
Vale a pena se você tem vários bancos pequenos e médios espalhados (WordPress, GLPI, Zabbix, sistemas internos) e hoje eles dependem de scripts com cron que ninguém monitora. O Databasus troca isso por uma tela com agenda, retenção, criptografia, alerta e histórico, e no PostgreSQL ainda entrega restore testado automaticamente e, a partir do 17, PITR.
Não substitui o mariabackup/XtraBackup com binlog em MySQL/MariaDB grandes nem quando o RPO precisa ser de segundos nesses bancos. Também não é ferramenta de backup de arquivos: para diretórios e volumes, continue com restic, borg ou similares. E, como toda peça de backup, monitore o próprio Databasus: o healthcheck do container entra fácil no Uptime Kuma ou no Gatus.
O resumo: backup que nunca foi restaurado é esperança, não backup. O Databasus não resolve tudo, mas deixa o restore testado barato o suficiente para virar rotina.
Links: GitHub · instalação · MySQL e MariaDB · verificação de restore · FAQ · segurança