
Crie um Service do tipo LoadBalancer num cluster Kubernetes na AWS ou no Google Cloud e, em segundos, ele ganha um IP externo. Faça o mesmo num cluster em servidores próprios e o EXTERNAL-IP fica em <pending> para sempre. O Kubernetes não traz um balanceador de carga de rede para bare metal: as implementações que acompanham o projeto só conversam com as nuvens. O MetalLB preenche esse buraco. Ele distribui IPs de um pool que você define e anuncia esses IPs na rede com protocolos padrão, ARP/NDP ou BGP. Neste guia, você vai entender como ele funciona, instalar a versão 0.16.1, configurar os modos Layer 2 e BGP e resolver os problemas mais comuns. Todos os comandos foram testados num laboratório com kind e um roteador FRR.
O problema: LoadBalancer em <pending>
Num cluster bare metal sem MetalLB, o sintoma é este:
kubectl create deployment nginx --image=nginx:1.29 --replicas=2
kubectl expose deployment nginx --type=LoadBalancer --port=80
kubectl get svc nginx
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
nginx LoadBalancer 10.96.187.200 <pending> 80:32251/TCP 5sSem um balanceador, sobram duas saídas ruins. NodePort expõe o serviço numa porta alta (30000 a 32767) de todos os nós, e o cliente precisa saber o IP de um nó que esteja de pé. externalIPs depende de você rotear o IP manualmente até algum nó. A documentação do MetalLB resume: essas opções transformam o bare metal em cidadão de segunda classe no Kubernetes.
O que é o MetalLB
O MetalLB é uma implementação de balanceador de carga de rede para clusters Kubernetes bare metal, escrita em Go, sob licença Apache 2.0. O repositório existe desde 2017, tem cerca de 8,4 mil estrelas e o projeto é sandbox da Cloud Native Computing Foundation. A API ainda é marcada como beta, mas a própria documentação afirma que o MetalLB é estável e confiável em produção. Se você quer entender de onde vem o modelo de Services e controladores, veja a história do Kubernetes.
Ele faz duas coisas que trabalham juntas:
- Atribuição de endereços: o
controller, um Deployment único no cluster, pega um IP livre de umIPAddressPoole grava no Service. Ele não inventa IPs: só entrega os que você colocou nos pools, sejam públicos alugados do seu datacenter ou privados da sua LAN. - Anúncio externo: o
speaker, um DaemonSet que roda em cada nó, faz a rede fora do cluster saber que aquele IP “mora” no cluster. Em modo Layer 2 ele responde ARP (IPv4) e NDP (IPv6); em modo BGP ele fecha sessões com seus roteadores e anuncia rotas.
Depois que o pacote chega ao nó, o trabalho do MetalLB acabou. Dali em diante quem encaminha até o pod é o kube-proxy e o plugin de rede (CNI) do cluster.
Requisitos
- Kubernetes 1.13 ou mais novo, sem outro balanceador de rede instalado.
- Um plugin de rede compatível; a página de compatibilidade marca Cilium, Flannel, Antrea e Canal como compatíveis, e Calico e kube-router como compatíveis com ressalvas.
- Alguns endereços IPv4 livres para o MetalLB distribuir.
- No modo BGP, um ou mais roteadores que falem BGP.
- No modo Layer 2, a porta 7946 TCP e UDP liberada entre os nós, usada pelo memberlist para detectar nós fora do ar.
Em nuvem pública, a maioria dos provedores não funciona com o MetalLB, porque a rede virtual não aceita IPs anunciados pela VM. A página de compatibilidade com nuvens detalha cada caso. No OpenStack funciona, desde que você libere os IPs na proteção antispoofing da porta.
Modo Layer 2: simples e universal
No modo Layer 2, um único nó do cluster é eleito “dono” de cada IP de serviço. Quando alguém na rede pergunta via ARP quem tem aquele IP, o speaker desse nó responde com o MAC da própria interface. Para a LAN, parece apenas que a máquina tem vários IPs. Funciona em qualquer rede Ethernet, sem equipamento especial.
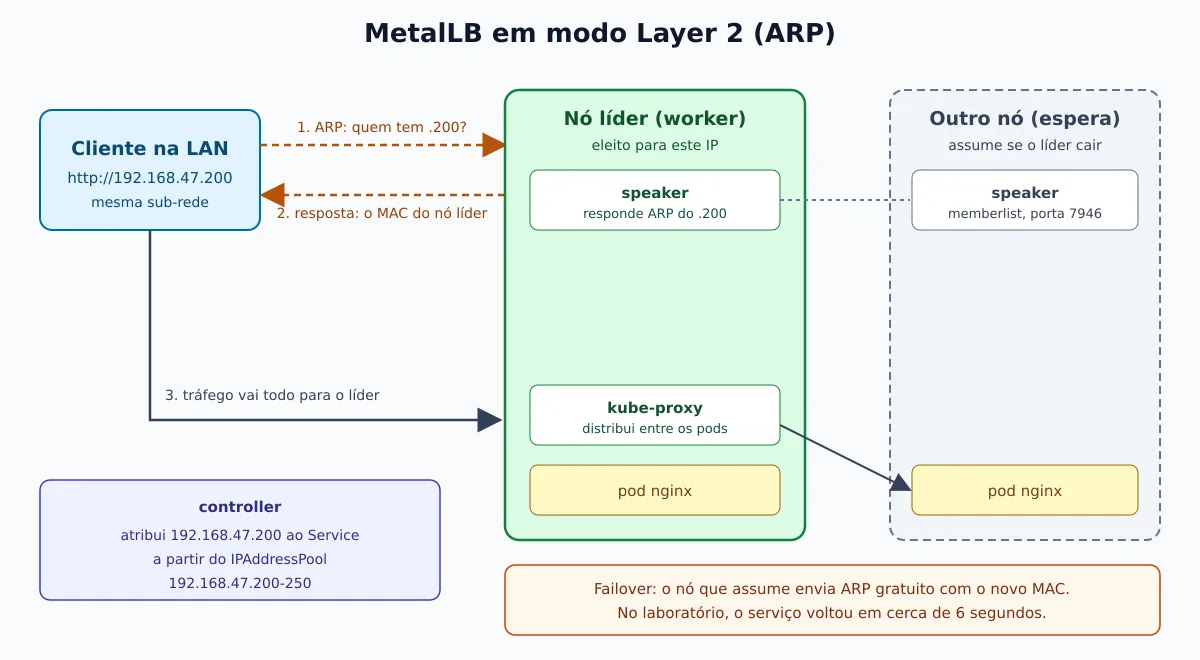
Isso tem duas consequências que você precisa conhecer:
- Não é balanceamento entre nós. Todo o tráfego de um IP entra por um nó só, e a banda de entrada fica limitada à interface dele. O que o modo L2 oferece é failover: se o líder cair, outro nó assume o IP.
- O failover depende dos clientes. O nó que assume envia pacotes ARP “gratuitos” avisando o novo MAC. Sistemas modernos (Linux, Windows, macOS) atualizam o cache na hora, e a troca leva poucos segundos. Equipamentos antigos ou com implementação ruim podem demorar mais.
A eleição do líder não guarda estado: cada speaker calcula, para cada IP, uma lista ordenada pelo hash de “nó + IP” entre os nós elegíveis, e quem estiver em primeiro anuncia. Adicionar um nó só muda o líder se o novo nó cair no topo da lista; remover um nó que não é líder não muda nada.
Quem conhece o Keepalived vai achar familiar: do ponto de vista do cliente, o IP “pula” de uma máquina para outra. A diferença é que o MetalLB não usa VRRP, e sim o memberlist. Por isso não existe o limite de 255 roteadores virtuais por rede nem IDs de roteador virtual para configurar. Em compensação, ele não conversa com equipamentos VRRP de terceiros.
Modo BGP: balanceamento de verdade
No modo BGP, cada nó fecha uma sessão BGP com os roteadores da sua rede e anuncia o IP de cada serviço como uma rota /32. Se o roteador estiver configurado para múltiplos caminhos (ECMP), ele trata todos os nós como próximos saltos equivalentes e divide as conexões entre eles.
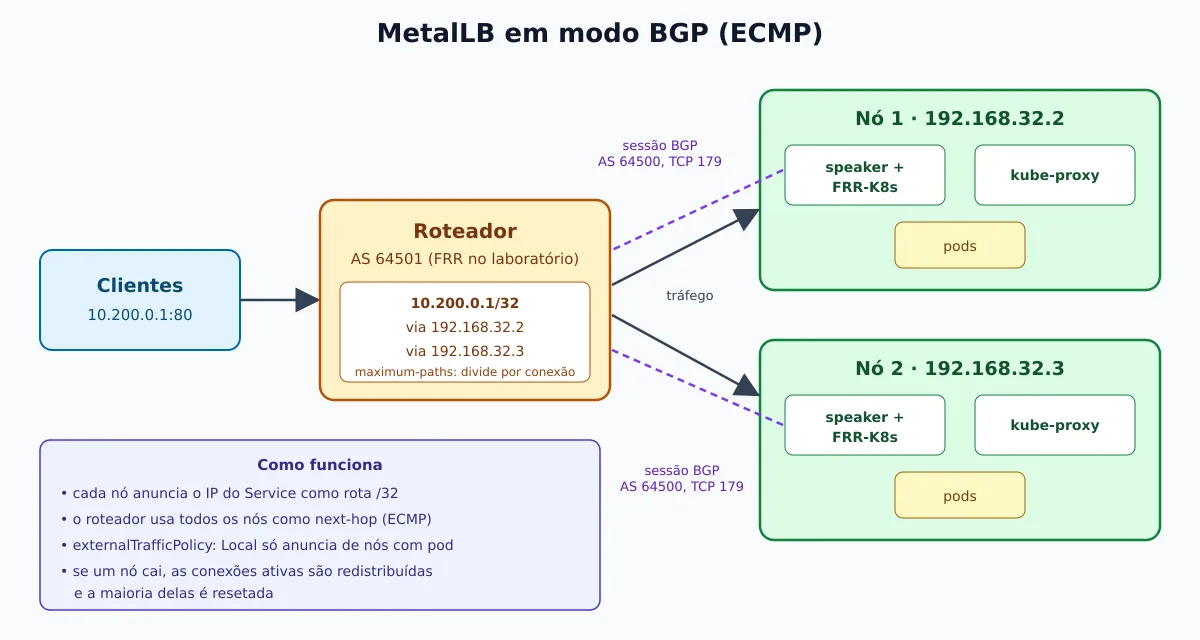
A divisão é por conexão, com hash de campos do pacote: todos os pacotes de uma conexão TCP vão para o mesmo nó. Hash de 5 campos (protocolo, IPs e portas de origem e destino) espalha melhor do que o de 3, porque separa conexões diferentes do mesmo cliente.
A limitação principal: quando o conjunto de nós muda, por exemplo porque um nó caiu, o roteador recalcula o hash e a maioria das conexões ativas vai parar em outro nó, que não conhece aquela conexão. O cliente recebe connection reset. É um corte único, não perda contínua. Para suavizar, a documentação sugere ECMP “resiliente” no roteador, deixar um Ingress Controller entre o BGP e os serviços, e fazer mudanças em horário de pouco tráfego.
Os três backends de BGP
O MetalLB tem três implementações de BGP, e a v0.16.0, de 20 de maio de 2026, mudou qual delas é a padrão:
- FRR-K8s (padrão e recomendado): usa o FRR por meio do FRR-K8s, que roda como DaemonSet próprio. Traz BFD, BGP sobre IPv6 e permite somar configuração FRR extra às mesmas sessões. Novos recursos de BGP só entram aqui.
- Nativo: implementação própria, mais leve, sem BFD e sem BGP sobre IPv6. Boa para quem só usa Layer 2 ou BGP simples.
- FRR (obsoleto): configura o FRR direto, sem a camada FRR-K8s. Será removido numa versão futura.
Laboratório: kind com três nós
Para reproduzir tudo sem mexer em produção, usamos o kind, que sobe nós Kubernetes como contêineres Docker. As versões do teste foram kind 0.33.0, Kubernetes 1.37.0 e MetalLB 0.16.1.
cat > kind.yaml <<'EOF'
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: metallb-lab
nodes:
- role: control-plane
- role: worker
- role: worker
EOF
kind create cluster --config kind.yaml
docker network inspect kind -f '{{range .IPAM.Config}}{{.Subnet}} {{end}}'
O último comando mostra a sub-rede da rede kind no Docker, que faz o papel da sua LAN. No nosso caso foi 192.168.32.0/20, e reservamos o trecho 192.168.47.200-192.168.47.250 para o MetalLB. Na sua rede real, escolha uma faixa fora do DHCP e que nenhum equipamento use.
Armadilha do kind: se algum pod entrar em CrashLoopBackOff com too many open files no log, o problema é o limite de inotify do host, não o MetalLB. Aumente com sudo sysctl fs.inotify.max_user_instances=512, como recomenda a documentação do kind. Aconteceu no nosso teste com três nós num host que já rodava vários contêineres.
Instalação
Preparação: kube-proxy em modo IPVS
Se o seu kube-proxy roda em modo IPVS, ative o strictARP; sem ele, os nós respondem ARP de IPs que não deveriam. Em modo iptables (o padrão do kubeadm e do kind), pule este passo.
kubectl get configmap kube-proxy -n kube-system -o yaml | \
  sed -e "s/strictARP: false/strictARP: true/" | \
  kubectl apply -f - -n kube-system
Por manifesto
O manifesto recomendado inclui o backend FRR-K8s:
kubectl apply -f https://raw.githubusercontent.com/metallb/metallb/v0.16.1/config/manifests/metallb-frr-k8s.yaml
kubectl wait -n metallb-system --for=condition=ready pod --all --timeout=240s
kubectl get pods -n metallb-system
NAME READY STATUS RESTARTS AGE
controller-75db68c68f-69tsz 1/1 Running 0 2m
frr-k8s-daemon-fvd4w 5/5 Running 0 2m
frr-k8s-daemon-rdc2p 5/5 Running 0 2m
frr-k8s-statuscleaner-867ddf64df-h9rzt 1/1 Running 0 2m
speaker-kqhsl 1/1 Running 0 2m
speaker-mk2jq 1/1 Running 0 2mPara uma instalação mais enxuta, sem FRR, troque por metallb-native.yaml na mesma URL. O manifesto já cria o namespace metallb-system com os rótulos pod-security.kubernetes.io/*: privileged, necessários porque o speaker precisa de privilégios de rede. Recém-instalado, o MetalLB fica parado: nada acontece até você criar a configuração.
Por Helm
kubectl create namespace metallb-system
kubectl label namespace metallb-system \
  pod-security.kubernetes.io/enforce=privileged \
  pod-security.kubernetes.io/audit=privileged \
  pod-security.kubernetes.io/warn=privileged
helm repo add metallb https://metallb.github.io/metallb
helm install metallb metallb/metallb --namespace metallb-system
O chart 0.16.1 também instala o FRR-K8s por padrão. Para usar o backend nativo, passe --set speaker.frr.enabled=false --set frrk8s.enabled=false. Com Helm, os recursos de configuração precisam ficar no mesmo namespace em que o MetalLB foi instalado.
Quem vem de versões antigas: até a v0.12 a configuração era um ConfigMap. Desde a v0.13 só existem os recursos customizados (CRDs) mostrados abaixo, e há uma ferramenta de conversão.
Configurando o modo Layer 2
São dois recursos: o pool de endereços e o anúncio em Layer 2 que aponta para ele.
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: lan
  namespace: metallb-system
spec:
  addresses:
  - 192.168.47.200-192.168.47.250
---
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: lan
  namespace: metallb-system
spec:
  ipAddressPools:
  - lan
Os endereços aceitam faixas (inicio-fim), CIDR (192.168.10.0/24) e IPv6, e você pode ter quantos pools quiser. Um L2Advertisement sem ipAddressPools vale para todos os pools. Sem nenhum L2Advertisement, o IP é atribuído mas não é anunciado, e o serviço não responde; é o erro mais comum de quem vem das versões com ConfigMap.
kubectl apply -f l2.yaml
kubectl get svc nginx
curl -s -o /dev/null -w '%{http_code}\n' http://192.168.47.200/
kubectl describe svc nginx | sed -n '/Events/,$p'
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
nginx LoadBalancer 10.96.187.200 192.168.47.200 80:32251/TCP 4m45s
200
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal IPAllocated 5s metallb-controller Assigned IP ["192.168.47.200"]
Normal nodeAssigned 5s metallb-speaker announcing from node "metallb-lab-worker2" with protocol "layer2"O Service que estava em <pending> ganhou o IP na hora. Os eventos mostram as duas etapas: o controller atribuiu o IP e o speaker do worker2 passou a anunciá-lo. Para ver qual nó anuncia cada serviço sem ler eventos:
kubectl get servicel2statuses -n metallb-systemNAME ALLOCATED NODE SERVICE NAME SERVICE NAMESPACE
l2-vc27l metallb-lab-worker2 nginx defaultTestando o failover
No laboratório, derrubamos o nó líder com docker stop enquanto um laço de curl batia no IP a cada meio segundo. O serviço voltou a responder em cerca de 6,3 segundos, e a tabela ARP do host trocou sozinha para o MAC do outro worker:
ip neigh show 192.168.47.200# antes: MAC do worker2
192.168.47.200 dev br-a312a0b87cf9 lladdr a2:7a:02:df:0c:57 REACHABLE
# depois: MAC do worker
192.168.47.200 dev br-a312a0b87cf9 lladdr c2:00:6c:c6:41:63 DELAYUm detalhe de teste: docker pause não serve para simular a queda, porque o kernel do nó pausado continua encaminhando pacotes e o serviço nem pisca. Use docker stop, ou desligue a máquina de verdade.
Limitando nós, interfaces e serviços
Por padrão, qualquer nó com speaker pode ser eleito, e o anúncio sai por todas as interfaces. Quando só alguns nós estão ligados a uma rede, restrinja:
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: dmz
  namespace: metallb-system
spec:
  ipAddressPools:
  - dmz
  nodeSelectors:
  - matchLabels:
      rede: dmz
  interfaces:
  - eth1
  serviceSelectors:
  - matchLabels:
      tier: frontend
serviceSelectors chegou na v0.16.0 e limita o anúncio aos Services com aqueles rótulos. Cuidado com interfaces: ele não influencia a eleição do líder. Se o nó eleito não tiver a interface, o serviço não é anunciado; combine sempre com nodeSelectors.
Configurando o modo BGP
Para o teste de BGP, recriamos o cluster com dois nós (o control-plane, 192.168.32.2, e um worker, 192.168.32.3) e subimos um roteador FRR 10.7.1 em contêiner, na mesma rede do kind, com o AS 64501:
docker run -d --name metallb-lab-router --network kind --ip 192.168.40.10 \
  --privileged -v "$PWD/router:/etc/frr" quay.io/frrouting/frr:10.7.1
No diretório router/ ficam o arquivo daemons, com bgpd=yes, e o frr.conf com a configuração do roteador:
router bgp 64501
 bgp router-id 192.168.40.10
 no bgp ebgp-requires-policy
 neighbor 192.168.32.2 remote-as 64500
 neighbor 192.168.32.3 remote-as 64500
 !
 address-family ipv4 unicast
  maximum-paths 8
 exit-address-family
maximum-paths é o que liga o ECMP: sem ele, o roteador escolhe um único nó. no bgp ebgp-requires-policy é necessário no FRR para aceitar rotas eBGP sem política explícita; num roteador de produção, prefira filtros de prefixo que aceitem só o seu pool.
Do lado do MetalLB, são três recursos: o par BGP, o pool e o anúncio.
apiVersion: metallb.io/v1beta2
kind: BGPPeer
metadata:
  name: roteador
  namespace: metallb-system
spec:
  myASN: 64500
  peerASN: 64501
  peerAddress: 192.168.40.10
---
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: bgp
  namespace: metallb-system
spec:
  addresses:
  - 10.200.0.0/24
  avoidBuggyIPs: true
---
apiVersion: metallb.io/v1beta1
kind: BGPAdvertisement
metadata:
  name: bgp
  namespace: metallb-system
spec:
  ipAddressPools:
  - bgp
Use metallb.io/v1beta2 no BGPPeer; a v1beta1 está obsoleta. O avoidBuggyIPs não está aí por acaso: sem ele, o primeiro Service do nosso teste recebeu 10.200.0.0, e alguns equipamentos antigos descartam endereços terminados em .0 e .255. Com a opção ligada, o Service passou a receber 10.200.0.1.
No roteador, as sessões sobem e a rota aparece com dois próximos saltos:
docker exec metallb-lab-router vtysh -c "show bgp summary"
docker exec metallb-lab-router vtysh -c "show ip route bgp"
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt
192.168.32.2 4 64500 4 6 1 0 0 00:00:15 1 1
192.168.32.3 4 64500 7 6 1 0 0 00:00:15 1 1
B>* 10.200.0.1/32 [20/0] via 192.168.32.2, eth0, weight 1, 00:00:09
* via 192.168.32.3, eth0, weight 1, 00:00:09Para ver o que cada nó pretende anunciar, sem entrar no roteador:
kubectl get servicebgpstatuses -n metallb-systemBFD para detectar falhas mais rápido
O BGP sozinho pode levar dezenas de segundos para perceber um vizinho morto. Nos backends FRR, dá para acoplar uma sessão BFD ao par:
apiVersion: metallb.io/v1beta1
kind: BFDProfile
metadata:
  name: rapido
  namespace: metallb-system
spec:
  receiveInterval: 380
  transmitInterval: 270
---
apiVersion: metallb.io/v1beta2
kind: BGPPeer
metadata:
  name: roteador
  namespace: metallb-system
spec:
  myASN: 64500
  peerASN: 64501
  peerAddress: 192.168.40.10
  bfdProfile: rapido
O roteador também precisa ter BFD ativo para esse vizinho. O BGPPeer aceita ainda senha da sessão (password ou passwordSecret), ebgpMultiHop, VRF e graceful restart, e a configuração avançada de BGP mostra agregação de rotas, local preference e comunidades. E um mesmo pool pode ser anunciado por L2 e BGP ao mesmo tempo: basta um L2Advertisement e um BGPAdvertisement apontando para ele.
Usando nos Services
Com o MetalLB configurado, basta type: LoadBalancer. As anotações abaixo dão controle fino; todas foram testadas no laboratório.
IP fixo
apiVersion: v1
kind: Service
metadata:
  name: nginx-fixo
  annotations:
    metallb.io/loadBalancerIPs: 192.168.47.210
spec:
  type: LoadBalancer
  selector:
    app: nginx
  ports:
  - port: 80
O campo spec.loadBalancerIP também funciona, mas está obsoleto no Kubernetes e não aceita dois IPs. A anotação aceita uma lista separada por vírgula, necessária para serviços dual stack. Se o IP não pertencer a nenhum pool, ou já estiver em uso, o Service fica em <pending> e o motivo aparece em kubectl describe svc.
Pool específico e IPs “caros”
Um cenário comum: um pool grande de IPs privados e poucos IPs públicos alugados. Marque o pool caro com autoAssign: false, e ele só será usado por quem pedir explicitamente:
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: publico
  namespace: metallb-system
spec:
  addresses:
  - 203.0.113.10/32
  autoAssign: false
---
apiVersion: v1
kind: Service
metadata:
  name: site
  annotations:
    metallb.io/address-pool: publico
spec:
  type: LoadBalancer
  selector:
    app: site
  ports:
  - port: 443
Lembre de incluir o pool num L2Advertisement ou BGPAdvertisement. No nosso teste, um pool esquecido fora do anúncio entregou o IP ao Service, mas o curl falhou e o ARP ficou INCOMPLETE no host. Para ambientes com vários times, o pool também aceita serviceAllocation, que o restringe a namespaces ou Services por rótulo e define prioridade entre pools.
Compartilhando um IP entre Services
Por padrão, cada Service ganha seu IP. Para colocar dois Services no mesmo endereço, por exemplo DNS em TCP e UDP ou aplicações em portas diferentes, use a mesma chave de compartilhamento:
apiVersion: v1
kind: Service
metadata:
  name: web-http
  annotations:
    metallb.io/allow-shared-ip: "web"
    metallb.io/loadBalancerIPs: 192.168.47.220
spec:
  type: LoadBalancer
  selector:
    app: nginx
  ports:
  - port: 80
---
apiVersion: v1
kind: Service
metadata:
  name: web-alt
  annotations:
    metallb.io/allow-shared-ip: "web"
    metallb.io/loadBalancerIPs: 192.168.47.220
spec:
  type: LoadBalancer
  selector:
    app: nginx
  ports:
  - port: 8080
    targetPort: 80
As condições: mesma chave, portas diferentes, e os dois com externalTrafficPolicy: Cluster (ou exatamente o mesmo seletor de pods). No laboratório, 192.168.47.220:80 e 192.168.47.220:8080 responderam os dois.
externalTrafficPolicy: Cluster ou Local
Essa opção do Service muda o comportamento do MetalLB:
- Cluster (padrão): o nó que recebe o tráfego repassa para qualquer pod do serviço, inclusive em outro nó. A distribuição entre pods é uniforme, mas o pod vê como origem o IP do nó, não o do cliente.
- Local: o tráfego só vai para pods do próprio nó, e o pod vê o IP real do cliente. Em BGP, só os nós que têm pods anunciam a rota. Em L2, só nós com pods podem ser eleitos.
No teste com BGP, com os dois pods no mesmo worker, bastou mudar para Local e a rota encolheu para um próximo salto:
kubectl patch svc web -p '{"spec":{"externalTrafficPolicy":"Local"}}'
docker exec metallb-lab-router vtysh -c "show ip route bgp"
B>* 10.200.0.1/32 [20/0] via 192.168.32.3, eth0, weight 1, 00:00:04O custo do Local em BGP é o desequilíbrio: o roteador divide por nó, não por pod. Com dois pods no nó A e um no nó B, cada pod do nó A recebe 25% do tráfego e o do nó B recebe 50%. Use anti-affinity para espalhar os pods um por nó.
Troubleshooting
A página de troubleshooting parte de uma divisão simples: se o Service não ganha IP, o problema está no controller; se ganha IP mas não responde, está nos speakers (ou na rede). Os comandos que mais usamos:
kubectl describe svc <servico>                           # eventos IPAllocated e nodeAssigned
kubectl logs -n metallb-system deploy/controller           # atribuição de IPs
kubectl logs -n metallb-system -l component=speaker        # anúncios
kubectl get servicel2statuses,servicebgpstatuses -n metallb-system
kubectl get configurationstates -n metallb-system          # configuração válida por componente
Configuração inválida
Os webhooks recusam boa parte dos erros na hora. No laboratório, um segundo pool com a mesma faixa foi barrado:
admission webhook "ipaddresspoolvalidationwebhook.metallb.io" denied the request:
CIDR "10.200.0.0/24" in pool "errado" overlaps with already defined CIDR "10.200.0.0/24"
Nem tudo é pego pelo webhook, porque a configuração é a soma de vários recursos. Quando a soma é inválida, o MetalLB ignora a mudança e continua com a última configuração válida. O recurso ConfigurationState, desde a v0.15.3, mostra o resultado por componente, e os logs trazem failed to parse the configuration.
O control-plane não anuncia
Nós com o rótulo node.kubernetes.io/exclude-from-external-load-balancers são ignorados, e o kubeadm e o kind colocam esse rótulo no control-plane. No nosso teste de BGP, o control-plane fechou a sessão mas enviou zero prefixos, e o log do speaker dizia exatamente o motivo:
"event":"skipping should announce bgp","ips":["10.200.0.0"],"protocol":"bgp",
"reason":"speaker's node has labeled 'node.kubernetes.io/exclude-from-external-load-balancers'"
Em cluster de nó único ou quando você quer mesmo anunciar pelo control-plane, remova o rótulo (kubectl label node <no> node.kubernetes.io/exclude-from-external-load-balancers-) ou passe --ignore-exclude-lb aos speakers.
Anuncia, mas não responde
- Não teste com ping. O IP do serviço não responde ICMP; teste a porta da aplicação.
- Testar de dentro de um nó não prova nada. Um nó alcança o IP pelo CNI mesmo que o anúncio esteja quebrado. Teste de uma máquina fora do cluster.
- Em L2, use
arpingde um host na mesma sub-rede:arping -I eth0 192.168.47.200deve mostrar um único MAC, o do nó líder. Dois MACs indicam dois speakers brigando, um IP duplicado na rede ou o CNI respondendo ARP. Nenhuma resposta costuma ser proteção antispoofing de MAC no switch ou no hypervisor; confirme comtcpdump -n -i eth0 arpno nó eleito. - Wi-Fi: alguns dispositivos, como o Raspberry Pi, param de responder ARP pela interface sem fio. O contorno citado na doc é o modo promíscuo (
ip link set wlan0 promisc on). - Em BGP, confira a sessão e a rota:
vtysh -c "show bgp neighbor"no roteador ou no contêiner FRR do nó, e a métricafrrk8s_bgp_session_up. - Retorno assimétrico: se o cliente está em outra sub-rede e o pacote entra por uma interface que não é a do gateway padrão, o
rp_filterdo Linux descarta a resposta. Resolva com rotas estáticas nos nós ou roteamento por origem.
Para abrir um bug, a doc pede os logs em nível debug e o resultado do script collect.sh, que junta logs e recursos. As imagens do MetalLB não têm shell; para depurar dentro do pod, use kubectl debug com um contêiner efêmero.
Monitoramento e atualização
MetalLB e FRR-K8s expõem métricas Prometheus. Desde a v0.16.0, o endpoint é só HTTPS, com certificado autoassinado ou fornecido por você, e o chart 0.16.1 corrigiu as anotações de coleta para esse esquema. As mais úteis são frrk8s_bgp_session_up para as sessões BGP e metallb_k8s_client_config_stale_bool para configuração parada. O guia de monitoramento com Prometheus mostra como coletar e alertar; e o Go Uptime pode vigiar o IP do serviço de fora do cluster, que é o teste que realmente importa.
Para atualizar, leia as notas de versão e reaplique o manifesto da nova versão ou rode helm upgrade; o chart atualiza os CRDs sozinho. Atenção a quem instalou por Helm com os valores padrão antes da 0.16: o backend mudou de FRR para FRR-K8s, o que troca a topologia dos pods e o prefixo das métricas de metallb_ para frrk8s_. Para manter o FRR antigo durante a transição, fixe speaker.frr.enabled=true e frrk8s.enabled=false. E lembre das limitações de failover: em L2 o IP muda de nó, em BGP as conexões ativas são resetadas; faça a atualização em horário de pouco tráfego.
Para desmontar o laboratório: kind delete cluster --name metallb-lab e docker rm -f metallb-lab-router.
L2 ou BGP?
- Layer 2 se você tem uma LAN simples, não controla o roteador ou quer resolver em cinco minutos. Aceite que um nó recebe todo o tráfego de cada IP e que o failover leva alguns segundos.
- BGP se você tem roteadores com BGP e precisa de balanceamento real entre nós, mais banda do que uma interface aguenta, ou já roda uma rede roteada no datacenter. Planeje as mudanças de nó por causa dos resets.
O MetalLB faz um trabalho pequeno e bem definido: dar um IP ao Service e levar o tráfego até algum nó. Isso basta para tirar o bare metal da condição de segunda classe, e é a base sobre a qual você coloca um Ingress Controller, um Gateway API ou os seus próprios serviços TCP e UDP. Código e documentação completa estão em metallb.io.