
O KeyDB nasceu com uma promessa simples: pegar o Redis, que executa os comandos numa única thread, e fazê-lo usar todos os núcleos da máquina. Funcionou, virou produto, foi comprado pela Snap e ganhou recursos que o Redis nunca teve, como replicação ativa entre dois mestres e expiração de membros dentro de um conjunto. Só que em setembro de 2026 a última versão do KeyDB tem quase três anos. Antes de colocar o KeyDB em produção, vale saber o que ele faz bem, o que quebra e em que pé o projeto está. Este post instala, configura, replica e mede o KeyDB em contêineres, e termina com uma recomendação.
De onde veio o KeyDB
O KeyDB começou no início de 2019 como um experimento de John Sully e Ben Schermel, em Toronto, para adicionar multithreading ao Redis. O projeto cresceu, passou pela Y Combinator (turma do verão de 2020) e virou a empresa EQ Alpha Technology, que mantinha duas edições: a aberta e a KeyDB Pro, fechada e paga.
Em 12 de maio de 2022 o KeyDB anunciou que passava a fazer parte da Snap, dona do Snapchat. Com a compra, o código da edição Pro foi aberto e a versão 6.3.0 juntou tudo num único projeto sob licença BSD-3-Clause. O repositório mudou de EQ-Alpha/KeyDB para Snapchat/KeyDB, e a Snap passou a usar o KeyDB em parte da sua própria camada de cache.
O motivo declarado do fork está no README: os autores achavam que o Redis priorizava a simplicidade do código em detrimento da simplicidade para o usuário, que acabava precisando de componentes externos (Sentinel, proxies, scripts) para resolver problemas comuns. O KeyDB quis ser o Redis “com pilhas incluídas”, mantendo compatibilidade com o protocolo, os módulos e os scripts Lua.
Como funciona a arquitetura multithread
O Redis clássico executa todos os comandos numa thread principal. Desde a versão 6 ele pode usar io-threads para ler e escrever nos sockets em paralelo, mas a execução dos comandos continua serializada. O KeyDB foi por outro caminho: roda o event loop inteiro em várias threads. Cada conexão é atribuída a uma thread no accept(), e o parsing e o I/O de rede acontecem em paralelo. O acesso à tabela de chaves é protegido por um spinlock, e transações seguram esse lock durante todo o EXEC, o que preserva a atomicidade que as aplicações esperam do Redis (explicação dos autores).
Na prática, isso é controlado por duas diretivas no keydb.conf:
server-threads 4              # threads que atendem clientes (padrão do pacote: 2)
server-thread-affinity true   # fixa cada thread num núcleo
O README recomenda relacionar server-threads ao número de filas da placa de rede, não ao número de núcleos, e sugere 4 como ponto de partida: como o KeyDB usa spinlocks, threads demais aumentam a disputa pelo lock. No benchmark mais abaixo, 8 threads ainda renderam mais que 4 com 6 núcleos dedicados ao servidor, então meça no seu hardware.
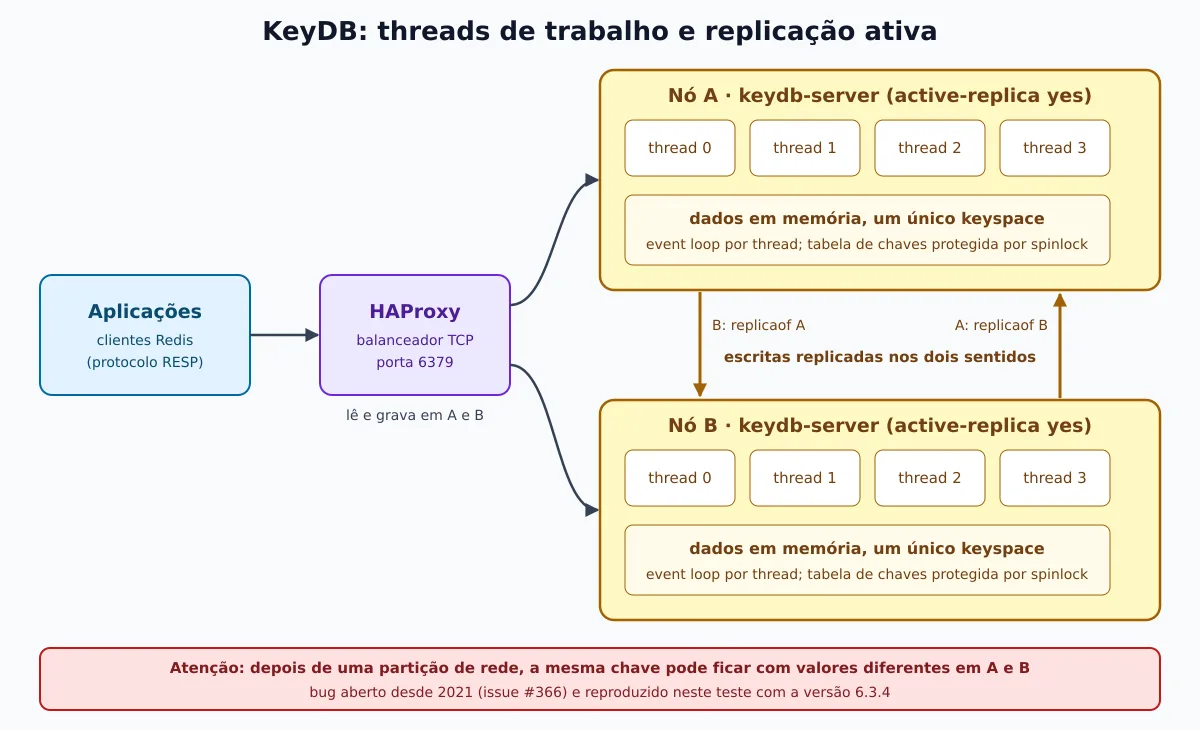
O diagrama mostra os dois nós usados no laboratório deste post, cada um com quatro threads, e a replicação ativa entre eles:
Recursos que o Redis não tem
Segundo a documentação oficial, o KeyDB acrescenta ao conjunto de recursos do Redis:
- Replicação ativa (active-replica): dois ou mais nós são réplicas uns dos outros e aceitam leitura e escrita ao mesmo tempo. Não há promoção de réplica nem Sentinel no failover; basta um balanceador TCP apontando para os nós saudáveis. Com vários nós em malha, o recurso vira multi-master. A documentação promete que, após uma divisão de rede, “a escrita mais nova vence” (last write wins). Nos testes abaixo, isso não aconteceu.
- Subkey expires: o comando
EXPIREMEMBERdá TTL a um membro de set, hash ou sorted set, não à chave inteira. No Redis, esse recurso só chegou na versão 7.4, e apenas para campos de hash. - MVCC: a documentação descreve snapshots que permitem executar
KEYSeSCANsem bloquear o banco, e um background save semfork(), que evita a duplicação de páginas de memória durante o snapshot. - FLASH storage: com
storage-provider flash /caminho, o KeyDB grava tudo num RocksDB em SSD/NVMe e mantém em RAM só os dados quentes. A própria documentação classifica o recurso como beta/experimental. - Backup direto para S3 com
db-s3-object, e ModJS, um módulo para escrever comandos em JavaScript sobre o V8.
A situação do projeto em setembro de 2026
Consultei o GitHub, o Docker Hub e o repositório APT do projeto em 23 de setembro de 2026:
| Indicador | Situação |
|---|---|
| Última release | v6.3.4, publicada em 30/10/2023 |
Último commit no branch main |
abril de 2024 (ajustes de build) |
Imagem Docker eqalpha/keydb:latest |
6.3.4 de 30/10/2023, base Ubuntu 20.04 |
| Repositório APT | Ubuntu 20.04/22.04 e Debian 11/12; sem Ubuntu 24.04 nem Debian 13 |
| Issues abertas | 292 |
| Base de código | Redis 6.2 (o próprio servidor se anuncia como redis_version:6.3.4) |
Em 31 de janeiro de 2025, John Sully, autor principal do KeyDB, publicou uma issue de despedida: era seu último dia na Snap, ele não sabia o que a empresa faria com o projeto e sugeriu que o esforço de desenvolvimento migrasse para o Valkey, que, nos testes dele, já tinha alcançado o desempenho do KeyDB. Desde então, a issue “Is KeyDB abandoned by Snap Inc?” segue sem resposta de algum mantenedor.
O dado mais grave é de segurança. A CVE-2025-49844 (CVSS 9.9 no NVD) é um use-after-free no Lua que permite execução remota de código por um usuário autenticado, e segundo o NVD afeta “todas as versões do Redis com scripting Lua”. O KeyDB herdou esse código. A PR que porta a correção está aberta desde outubro de 2025: recebeu aprovações de usuários da comunidade, mas nenhum mantenedor fez o merge.
Conclusão honesta: o KeyDB está parado. O repositório não foi arquivado e a Snap pode continuar usando uma versão interna, mas o projeto público não recebe releases, correções de segurança nem pacotes para as distribuições atuais.
Instalação no Ubuntu e no Debian
O projeto mantém um repositório APT próprio. Testei o procedimento em contêineres com systemd, e ele funcionou no Ubuntu 22.04 e no Debian 12:
echo "deb https://download.keydb.dev/open-source-dist $(lsb_release -sc) main" \
  | sudo tee /etc/apt/sources.list.d/keydb.list
sudo wget -O /etc/apt/trusted.gpg.d/keydb.gpg \
  https://download.keydb.dev/open-source-dist/keyring.gpg
sudo apt update
sudo apt install keydb
sudo systemctl enable --now keydb-server
O pacote keydb instala o keydb-server (serviço systemd rodando como usuário keydb, configuração em /etc/keydb/keydb.conf) e o keydb-tools (keydb-cli, keydb-benchmark, keydb-check-aof e keydb-check-rdb). Para rever os comandos de serviço, veja Dominando o systemd.
systemctl is-active keydb-server
# active
keydb-cli ping
# PONG
keydb-cli set curso linuxpro && keydb-cli get curso
# OK
# "linuxpro"
No Ubuntu 24.04 e no Debian 13, o apt update falha porque o repositório não tem as suítes noble e trixie. No Ubuntu 24.04, trocar $(lsb_release -sc) por jammy instalou e subiu o serviço sem erro no meu teste. Isso é um contorno, não suporte oficial, e o Debian 13 continua sem pacote (há uma issue pedindo, sem resposta).
Rodando com Docker
A imagem oficial é eqalpha/keydb. Ela traz protected-mode no e nenhuma senha no keydb.conf padrão, então nunca publique a porta sem configurar autenticação. Uma instância mínima, só em localhost e com senha:
docker run -d --name keydb \
  -p 127.0.0.1:6379:6379 \
  -v keydb-data:/data \
  eqalpha/keydb:x86_64_v6.3.4 \
  keydb-server /etc/keydb/keydb.conf \
    --requirepass 'TroqueEstaSenha' \
    --server-threads 4 \
    --appendonly yes

docker exec -it keydb keydb-cli -a 'TroqueEstaSenha' ping
Qualquer cliente Redis funciona sem mudança, inclusive o redis-cli e as bibliotecas das linguagens, porque o protocolo é o mesmo. Se você ainda não usa contêineres no dia a dia, a história do Docker explica de onde vem a ferramenta.
Replicação ativa entre dois nós
O laboratório usa dois contêineres, keydb-lab-a e keydb-lab-b, numa rede Docker. Cada nó aponta para o outro com replicaof e liga active-replica:
# keydb-a.conf  (no keydb-b.conf, troque para: replicaof keydb-lab-a 6379)
port 6379
bind 0.0.0.0
protected-mode yes
requirepass SenhaForte123
masterauth SenhaForte123
server-threads 4
active-replica yes
replicaof keydb-lab-b 6379
appendonly yes
dir /data
docker network create keydb-lab-net
for n in a b; do
docker run -d --name keydb-lab-$n --network keydb-lab-net \
-v $PWD/keydb-$n.conf:/etc/keydb/keydb.conf:ro \
eqalpha/keydb:x86_64_v6.3.4 keydb-server /etc/keydb/keydb.conf
done
A="docker exec keydb-lab-a keydb-cli -a SenhaForte123 --no-auth-warning"
B="docker exec keydb-lab-b keydb-cli -a SenhaForte123 --no-auth-warning"
$A info replication | grep -E 'role|link_status'
# role:active-replica
# master_global_link_status:up
# master_link_status:up
$A set site linuxpro.com.br ; $B get site # "linuxpro.com.br"
$B set autor nilton ; $A get autor # "nilton"O log confirma as quatro threads (Thread 0 alive até Thread 3 alive) e o aviso de que active-replica yes implica replica-read-only no. Escritas feitas em qualquer nó apareceram no outro em menos de um segundo.
Também funcionou o cenário que a documentação destaca: com o nó B parado, gravei um valor novo em A. Ao religar B, ele sincronizou e passou a mostrar o valor novo, sem sobrescrever A com o dado antigo do seu AOF.
O teste de partição de rede
Depois simulei uma divisão de rede. Baixei o repl-timeout para 5 segundos, desconectei o nó B da rede Docker e esperei o master_link_status ir para down. Com os nós isolados, gravei a mesma chave nos dois e reconectei B:
$A config set repl-timeout 5 ; $B config set repl-timeout 5
docker network disconnect keydb-lab-net keydb-lab-b
# ... aguarda master_link_status:down em B ...
$B set k6 azul-antigo      # escrita mais velha, em B
$A set k6 verde-novo       # escrita mais nova, em A (2 s depois)
docker network connect keydb-lab-net keydb-lab-b
# ... aguarda master_link_status:up ...
$A get k6    # "azul-antigo"
$B get k6    # "verde-novo"
Em vez de convergir para a escrita mais nova, os nós trocaram os valores e ficaram divergentes. O log mostrou uma ressincronização parcial (Successful partial resynchronization), e cada nó aplicou por cima a escrita do outro. Repeti o teste sete vezes, com partições de 3 a 15 segundos, tanto com o link de replicação caindo quanto sem ele chegar a cair, e o resultado foi sempre o mesmo. A divergência continuou até que um docker restart keydb-lab-b forçou uma sincronização completa, e aí os dois nós ficaram com azul-antigo: a escrita mais nova foi perdida.
O comportamento é conhecido. A issue #366 relata o mesmo problema desde setembro de 2021, e em dezembro de 2023 outro usuário confirmou que ele continuava na 6.3.4. Como a replicação ativa é o principal motivo para escolher o KeyDB, isso pesa: não use active-replica onde uma divergência silenciosa de dados é inaceitável.
Expiração de membros com EXPIREMEMBER
Este recurso funcionou como documentado, inclusive replicado para o outro nó:
$A sadd sessoes u1 u2 u3
$A expiremember sessoes u1 3          # u1 expira em 3 s
$A ttl sessoes                        # -1: a chave em si não expira
sleep 4
$A smembers sessoes                   # u2, u3
$B smembers sessoes                   # u2, u3

$A hset carrinho item1 a item2 b
$A expiremember carrinho item1 2000 ms   # unidade opcional: s ou ms
Para caches com tags ou listas de sessões, isso evita o truque de manter um sorted set paralelo só para controlar a validade de cada membro.
Benchmark simples: KeyDB, Valkey e Redis
O README do KeyDB avisa que o keydb-benchmark e o redis-benchmark são lentos demais para saturar um servidor multithread e recomenda o memtier_benchmark. Foi o que usei, em contêineres na mesma máquina.
Ambiente: AMD Ryzen 9 9900X (12 núcleos/24 threads), 186 GB de RAM, Docker em rede bridge. O servidor ficou preso a 6 núcleos físicos (--cpuset-cpus 0-5,12-17) e o memtier aos outros 6 (6-11,18-23), sem compartilhar núcleo. Sem persistência (--save "" --appendonly no), 200 mil chaves de 100 bytes pré-carregadas, 8 threads × 50 conexões no memtier, 1 SET para 10 GETs, chaves aleatórias, 20 segundos por rodada. Fiz três rodadas por configuração, e a tabela mostra a mediana. A máquina rodava outros contêineres ao mesmo tempo, então compare as linhas entre si, não com números de outros ambientes.
docker run --rm --network keydb-lab-net --cpuset-cpus 6-11,18-23 \
  redislabs/memtier_benchmark:latest -s keydb-lab-srv -p 6379 \
  --protocol=redis --threads=8 --clients=50 --ratio=1:10 \
  --data-size=100 --key-maximum=200000 --key-pattern=R:R \
--test-time=20 --hide-histogram| Servidor e configuração | ops/s (mediana) | latência média | p99 |
|---|---|---|---|
KeyDB 6.3.4, server-threads 1 |
213 mil | 1,88 ms | 2,78 ms |
Valkey 9.1.2, io-threads 1 |
214 mil | 1,86 ms | 3,81 ms |
KeyDB 6.3.4, server-threads 4 |
833 mil | 0,48 ms | 1,01 ms |
Valkey 9.1.2, io-threads 4 |
633 mil | 0,63 ms | 1,01 ms |
KeyDB 6.3.4, server-threads 8 |
1,30 milhão | 0,31 ms | 0,81 ms |
Valkey 9.1.2, io-threads 8 |
1,25 milhão | 0,32 ms | 0,58 ms |
Redis 8.10.2, io-threads 8 |
1,28 milhão | 0,31 ms | 0,65 ms |
O que os números mostram:
- Com uma thread, KeyDB e Valkey empatam, o que faz sentido: é essencialmente o mesmo motor herdado do Redis.
- Com 4 threads, o KeyDB fica cerca de 30% à frente do Valkey. Executar comandos em várias threads ainda rende mais quando há poucas threads.
- Com 8 threads, os três ficam a menos de 4% um do outro, e o Valkey e o Redis têm o p99 mais baixo. Nesse ponto, o limite provavelmente é o próprio memtier ou a pilha de rede do Docker, e não mais o servidor.
Em resumo, a vantagem de desempenho que justificava o KeyDB em 2019 hoje é pequena, e só aparece com poucas threads. Isso bate com o que o próprio John Sully escreveu ao sair da Snap.
Redis x Valkey x KeyDB
Dados conferidos nos repositórios oficiais em 23/09/2026:
| Redis | Valkey | KeyDB | |
|---|---|---|---|
| Licença | tripla desde a 8.0: RSALv2, SSPLv1 ou AGPLv3 (7.4 era só RSALv2/SSPL) | BSD-3-Clause | BSD-3-Clause |
| Quem mantém | Redis Ltd. | comunidade, sob a Linux Foundation | Snap (sem atividade pública) |
| Última versão estável | 8.10.2 (17/09/2026) | 9.1.2 (01/09/2026) | 6.3.4 (30/10/2023) |
| Base de código | própria | fork do último Redis BSD (série 7.2) | fork do Redis 6.2 |
| Multithread | threads de I/O; comandos numa thread | threads de I/O; comandos numa thread | event loop e comandos em várias threads |
| Cluster com sharding | sim | sim | sim (modo cluster do Redis 6.2) |
| Replicação multi-master | não na edição open source | não | sim, com o bug de divergência acima |
| Expiração por membro | campos de hash (desde a 7.4) | campos de hash (desde a 9.0) | set, hash e sorted set |
| Correção da CVE-2025-49844 | sim (8.2.2 e backports) | sim | não |
A mudança de licença do Redis foi anunciada em 20 de março de 2024. A Linux Foundation lançou o Valkey em 28 de março de 2024 a partir do último código BSD, e em 1º de maio de 2025 o Redis 8 acrescentou a AGPLv3 como terceira opção, voltando a ter uma licença aprovada pela OSI.
Um cuidado com as comparações que circulam na internet: há artigos que atribuem ao KeyDB a licença Apache 2.0 (a licença é BSD-3-Clause) e tabelas de desempenho sem ambiente nem método descritos. Confira sempre no repositório e meça no seu hardware.
Qual escolher
- Projeto novo: use o Valkey. É BSD, tem releases frequentes, correções de segurança, pacotes nas distribuições atuais e é a alternativa recomendada pelo próprio autor do KeyDB. Com
io-threadsele já aproveita vários núcleos. - Precisa do ecossistema da Redis Ltd. (módulos integrados do Redis 8, suporte comercial)? Use o Redis, sabendo que a licença é AGPLv3 ou source-available.
- Já tem KeyDB em produção? Planeje a migração para o Valkey. Enquanto ela não acontece, bloqueie scripts Lua para quem não precisa deles (
ACL SETUSER <usuario> -@scripting, que testei na 6.3.4), não exponha a porta fora da rede interna e trate a replicação ativa como sujeita a divergência.EXPIREMEMBERe replicação ativa não existem no Valkey, então revise o código que usa esses recursos. - KeyDB em projeto novo: não recomendo. O desempenho que o justificava ficou para trás, e a falta de manutenção pesa mais.
Conclusão
O KeyDB provou uma tese: um cache compatível com Redis podia usar todos os núcleos, e essa pressão ajudou a empurrar o Redis e o Valkey para o multithreading de I/O. Mas um banco de dados sem mantenedor, sem correção para uma RCE crítica e com replicação ativa que perde escritas após uma partição não deve receber dados novos em 2026. Para quem precisa de alta disponibilidade, o caminho é o Valkey, e o post Valkey em cluster mostra como montar três primários e três réplicas, com failover testado. Se o cache vai para produção, monitore-o de verdade, com Prometheus e Node Exporter ou com um verificador simples como o Go Uptime. E se a sua aplicação em Go já usa Redis para filas, o post sobre Asynq funciona do mesmo jeito com o Valkey.