Você encontra uma função interessante em um aplicativo, um formato de arquivo sem documentação ou um programa antigo que precisa entender. O problema não é pedir à IA para “adivinhar como funciona”: é dar a ela meios de examinar o alvo e exigir evidências. O REA — Reverse Engineer Anything conecta agentes de programação a ferramentas de engenharia reversa por MCP e oferece os mesmos fluxos por uma CLI.
Este artigo complementa “Engenharia Reversa com IA: a Adobe morreu?”, de Fábio Akita, publicado em 13 de outubro de 2026. A discussão dele separa o entusiasmo com reconstruções assistidas por IA do trabalho necessário para entender e reproduzir software. Aqui, o foco é operacional: quais ferramentas o REA integra, que perguntas elas ajudam a responder e como começar com um alvo controlado no Linux.
3b79af28e80785afce9f5998d8f03289402a1847, e o pacote npm correspondente. A documentação da branch principal pode mostrar capacidades posteriores. Os testes locais usaram um pequeno aplicativo criado para este artigo; não executamos alvos de terceiros nem instalamos Ghidra, Hopper ou IDA.O REA não é um botão para clonar qualquer software
REA é uma camada de integração, investigação e evidência. O agente formula uma pergunta, chama uma ferramenta, recebe observações e decide qual será o próximo passo. A decompilação continua sendo trabalho de um motor como Ghidra, Hopper ou IDA; análise de JavaScript usa outros caminhos; observar um processo em execução é uma operação diferente de ler um arquivo.
O próprio nome “Reverse Engineer Anything” precisa ser lido como proposta ampla, não garantia. A ferramenta não recupera automaticamente os nomes, comentários, intenções e testes que o compilador descartou. Também não entrega o backend de um SaaS só porque você abriu sua interface no navegador.
Isso não diminui sua utilidade. Automatizar inventários, encontrar referências, relacionar módulos e manter a origem dos resultados pode poupar bastante trabalho repetitivo. Mas pseudocódigo legível, código que compila e comportamento equivalente são três coisas diferentes.
Como funciona: agente, ferramentas e evidências
O projeto é escrito em TypeScript, distribuído como rea-agents e oferece o comando rea. O REA é publicado sob licença MIT; isso não altera as licenças próprias de Hopper, IDA ou de outros provedores externos. CLI e MCP usam fluxos compartilhados. Conforme a tarefa, o REA trabalha com um parser próprio, uma instalação externa de ferramenta ou uma conexão com um runtime que você selecionou.
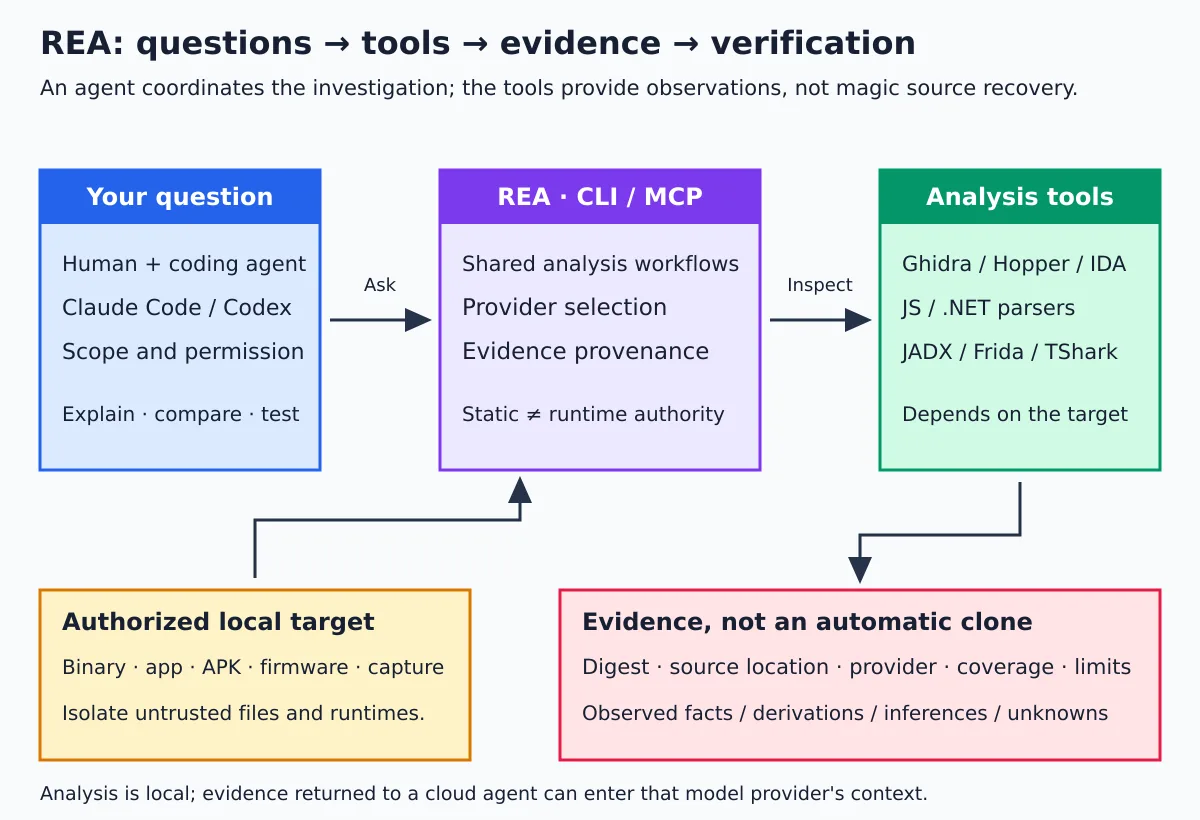
Os resultados usam um contrato de Evidence, com campos para identificar o alvo, operação, provedor, parâmetros, origem e limitações. Dependendo do fluxo, também há hashes, localizações no artefato e informações de cobertura. Isso ajuda a distinguir:
- Observação: uma string, instrução, import ou declaração encontrada no arquivo.
- Derivação: uma relação obtida a partir de fatos observados e regras explícitas.
- Inferência: uma hipótese sobre finalidade ou comportamento.
- Desconhecido: algo que a análise não conseguiu estabelecer.
Um endereço parecido com uma API em um bundle não prova que aquele endpoint foi chamado. Duas funções com texto semelhante não provam equivalência de comportamento. Essa disciplina é mais importante que o número de ferramentas expostas ao agente. Os contratos estão na documentação MCP.
As ferramentas, organizadas por pergunta
Não é preciso instalar tudo. Escolha primeiro o alvo e a pergunta; depois veja a ferramenta exigida. Algumas capacidades já estão no pacote, outras dependem de programas fornecidos por você. Plataformas e versões suportadas variam por adaptador.
| Tipo de análise | Ferramentas ou mecanismo | O que ajuda a descobrir | Limite importante |
|---|---|---|---|
| Binário nativo | Ghidra, Hopper ou IDA. | Assembly, pseudocódigo, funções, strings, chamadas e referências. | Formato e arquitetura dependem do provedor; saída não é o fonte original. |
| Inspeção nativa auxiliar | GNU objdump e Rizin fornecidos pelo usuário. | Headers, seções, símbolos, relocations e instruções. | Nem todo comando equivale a decompilação; capacidades dependem da instalação. |
| JavaScript/Electron estático | Analisadores do REA; Wakaru opcional para recuperação de fontes. | Módulos, imports, exports, candidatos a rotas e relações entre main, preload e renderer. | Expressões dinâmicas e ofuscação podem deixar relações desconhecidas. |
| Navegador e aplicações web | CDP em navegador compatível; fluxos de cenários com Playwright. | Estrutura da página, scripts, recursos, observações de rede e diferenças entre execuções. | Observação passiva e cenário que dirige o navegador têm autoridades distintas. |
| Android | JADX e JDK; adb e Apktool para tarefas específicas; JEB por integração própria. | Manifesto, classes, métodos, recursos e informações de dispositivo autorizado. | APK descompilado não é um projeto Android pronto para recompilar. |
| .NET | Inspeção estática de metadados PE/CLI e CIL. | Identidade, tipos, membros, instruções e dependências nativas declaradas. | NativeAOT e outras formas de distribuição exigem tratamento diferente. |
| Runtime e instrumentação | Frida, GDB e integrações de captura conforme o host. | Eventos, chamadas, saída e comportamento de um processo selecionado. | Pode executar código, alterar estado ou afetar o alvo; exige autorização adicional. |
| Firmware | Binwalk e Unblob no Linux. | Regiões, conteúdos extraídos e artefatos para análise posterior. | Extrair arquivos não significa compreender toda a lógica ou conseguir atualizar o dispositivo. |
| Tráfego gravado | HAR/SAZ; TShark/capinfos; mitmdump em fluxo específico. | Requisições, respostas, endpoints, protocolos e campos selecionados. | Capturas podem conter credenciais e dados pessoais; criptografia limita o conteúdo visível. |
| Sinais lógicos gravados | sigrok-cli e limites de processo no Linux. | Anotações de decodificadores e faixas de amostras. | Depende do sinal registrado e do decodificador adequado. |
| Metadados de Go/Rust | Inspeção estática embutida para formatos suportados. | Build info de Go e dependências Rust quando há metadados cargo-auditable. | Metadado ausente não prova ausência de dependências. |
| WASM, EVM e SQLite | Fluxos específicos; WABT externo para WASM, requisitos próprios para SQLite. | Seções e imports/exports, estrutura de bytecode ou esquema e amostras de tabelas. | São análises diferentes; uma não substitui testes de execução da outra. |
Os pontos de partida são os guias de binários nativos, JavaScript, Android, .NET e ferramentas auxiliares.
Ghidra, Hopper e IDA: qual é o papel de cada um?
Para uma investigação nativa profunda, você precisa de um provedor compatível instalado e configurado. REA não substitui esses motores: fornece acesso organizado a suas operações e preserva a proveniência dos resultados.
- Ghidra: um caminho aberto para análise nativa. O REA importa o alvo para um projeto temporário de análise; não é simplesmente um robô clicando na sua GUI.
- Hopper: integração com ferramenta comercial; o setup pode oferecer instalação, mediante aprovação. Demo e licença têm condições próprias.
- IDA: usa uma instalação e os componentes compatíveis que você já possui; não fornece licença de IDA ou Hex-Rays.
REA não baixa nem atualiza Ghidra ou Java para você. Configure os caminhos conforme o guia do provedor e verifique a compatibilidade daquela versão. Para diagnóstico direcionado:
rea providers --json
rea capabilities --json
rea doctor --provider ghidra --json
Escolher explicitamente um provedor evita ambiguidades quando há mais de um disponível. Não use um endereço de função inventado: descubra o endereço ou nome no inventário do alvo antes de solicitar uma operação.
# Somente em um binário próprio ou cuja análise foi autorizada:
rea analyze /caminho/absoluto/programa --provider ghidra --json
rea function /caminho/absoluto/programa main --provider ghidra --json
Esses exemplos são condicionais: um binário sem símbolo main exige outro identificador, e a análise precisa de um Ghidra configurado. Não executamos esse fluxo nativo no laboratório deste artigo.
Instalação rápida e setup sem surpresas
Na 6.5.0, o pacote declara estas faixas de Node.js: 22.x a partir de 22.19, 24.x a partir de 24.11 ou 26 e posteriores, além do npm. Não simplifique isso para “qualquer Node mais novo que 22”: outras linhas intermediárias não aparecem na declaração de compatibilidade.
Há requisitos específicos: a inspeção de SQLite na versão analisada pede Node 24.x a partir de 24.15 ou 26+. O Node 24.13.1 usado em nosso teste JavaScript atende ao requisito geral, mas não a esse fluxo de SQLite.
No Linux, alguns fluxos precisam de um ps compatível com procps para conferir identidade e propriedade dos processos. Em uma distribuição mínima, verifique antes de começar:
node --version
npm --version
command -v ps

# CLI sem instalação global, fixando a versão examinada
npx --yes rea-agents@6.5.0 --version
npx --yes rea-agents@6.5.0 --help

# Planejamento somente leitura: não altera o Codex nem instala a skill
npx --yes rea-agents@6.5.0 setup \
  --client codex --skill=false --dry-run --json
npx --yes aprova o download/execução do pacote pelo npm; não é a mesma autorização que aplicar mudanças de configuração do REA. Leia o plano, faça backup das configurações e então execute o setup interativo para escolher os clientes e aprovar exatamente o que será alterado:
npx rea-agents@6.5.0 setupO setup pode registrar MCP e instalar instruções de investigação compatíveis com aquela versão. Reinicie os clientes depois. Instalar apenas uma skill não equivale a configurar o servidor e os motores de análise. Para uso frequente, o projeto também documenta a instalação global de rea-agents; prefira um prefixo de usuário ou gerenciador de Node em vez de instalar com sudo npm.
A fonte oficial é morluto/rea, o site rea.tools e os metadados oficiais do pacote npm rea-agents. Um nome parecido no GitHub não comprova que o download é oficial.
Primeiro exercício: um pequeno aplicativo JavaScript seu
Você não precisa começar por um binário comercial gigante. Um projeto controlado permite comparar a análise com algo que conhece. Os comandos abaixo criam um exemplo simples e analisam seus arquivos como texto, sem precisar de Ghidra.
mkdir -p rea-lab-app/lib
cd rea-lab-app

cat > package.json <<'JSON'
{"name":"rea-lab-app","version":"1.0.0","main":"main.cjs"}
JSON

cat > lib/labels.cjs <<'JS'
exports.normalizeLabel = (value) => String(value).trim().toLowerCase();
JS

cat > main.cjs <<'JS'
const { normalizeLabel } = require('./lib/labels.cjs');
module.exports = { normalizeLabel };
JS

npx --yes rea-agents@6.5.0 analyze-javascript-application \
  "$PWD" --json > ../rea-lab-evidence.json
O resultado não é apenas uma explicação em linguagem natural. Há uma estrutura de evidência e relações entre artefatos e módulos. Para inspecioná-la, use um visualizador JSON ou produza uma visão resumida a partir do arquivo salvo. O exemplo seguinte usa jq, que precisa estar instalado:
cd ..
jq -c '{source: {kind: "inline", evidence: .}, view: {kind: "summary"}}' \
  rea-lab-evidence.json > rea-lab-summary-request.json

npx --yes rea-agents@6.5.0 inspect-analysis-view \
  rea-lab-summary-request.json --json > rea-lab-summary.json
No laboratório, usamos uma variação controlada desse aplicativo e acrescentamos um marcador que seria gravado caso o entrypoint fosse executado. A análise terminou com sucesso e o marcador não foi criado. Isso é consistente com o caminho de análise estática declarado pelo projeto; não demonstra segurança universal para qualquer arquivo ou parser.
O que testamos e o que ficou fora
| Verificação | Resultado observado |
|---|---|
| Pacote npm e tag | Versão 6.5.0 confirmada; testes com Node 24.13.1. |
| CLI | --version e --help funcionaram. |
| Setup somente leitura | Plano para Codex retornou planned, sem ações aplicadas, em um HOME isolado. |
| Análise estática JavaScript | Retornou Evidence com alvo, digest, relações e limitações, sem executar o entrypoint de teste. |
| Visão resumida | inspect-analysis-view processou a evidência salva. |
| Volume de saída deste exemplo | 124.682 bytes de Evidence e 10.032 bytes na resposta da visão resumida. |
| Provedores externos e runtime | Não testados: Ghidra, Hopper, IDA, JADX, Frida, dispositivos e cenários de navegador. |
Instalamos o pacote em um diretório de laboratório, sem instalação global e com scripts de instalação desativados. Isso bastou para os fluxos estáticos examinados, mas não valida integrações nativas opcionais. Não aplicamos o setup aos agentes reais do usuário.
Os tamanhos acima são bytes de JSON, não tokens, nem uma estimativa de custo de API. Também não são benchmark de escala: o alvo era pequeno. A lição prática é que preservar a evidência completa em disco e consultar uma projeção pode ser melhor do que despejar tudo no contexto do modelo.
Casos de uso: onde o REA realmente ajuda
1. Documentar um sistema legado
Imagine um utilitário interno cujo fonte se perdeu, mas cujo uso e análise foram autorizados. Você pode levantar strings, parâmetros, formatos reconhecidos e funções candidatas, depois confrontar as hipóteses com entradas e saídas controladas. O objetivo inicial é uma especificação testável, não reescrever tudo no primeiro prompt.
2. Entender um fluxo em JavaScript ou Electron
Uma função de exportação pode atravessar renderer, preload, IPC e processo principal. O grafo estático ajuda a mapear essas fronteiras; observação de runtime autorizada pode mostrar quais caminhos realmente ocorreram. Imports encontrados e código alcançável não significam, sozinhos, execução comprovada.
3. Interoperabilidade e migração
Uma integração pode precisar entender um formato ou contrato observado para construir uma implementação própria. Trabalhe com amostras permitidas, registre casos de teste, falhas e ambiguidades, e valide os resultados. Não presuma que conseguir decompilar um arquivo concede direitos para copiar sua implementação ou redistribuí-lo.
4. Preservação de software e jogos antigos
Alvos estáveis, algoritmos pequenos e entradas reproduzíveis são bons candidatos a investigação. Assembly e comparações de comportamento podem ajudar a recuperar um cálculo específico. Isso não é o mesmo que reconstruir assets, ferramentas, servidores ou um jogo inteiro automaticamente.
5. Comparar versões e investigar regressões
O REA tem fluxos de comparação para diferentes tipos de artefato. Eles podem localizar mudanças de estrutura, texto ou observações de execução. Uma diferença de pseudocódigo não demonstra, por si só, regressão funcional; organize testes para a hipótese concreta.
6. Auditoria autorizada de aplicações
Inventários de permissões, bibliotecas, recursos e candidatos a endpoints ajudam a formular perguntas de segurança e privacidade. Combine análise estática e observação autorizada, sem transformar “não encontrei” em “não existe”. Não use essa atividade para coletar dados de contas ou dispositivos de terceiros sem permissão.
7. Firmware, protocolos e equipamentos
Firmwares e capturas gravadas podem revelar componentes, layouts e mensagens. Em hardware próprio ou laboratório autorizado, isso ajuda na documentação e interoperabilidade. Extração, emulação, execução e gravação de firmware são atividades distintas, com riscos e permissões diferentes.
Análise estática, observação passiva e execução não são sinônimos
Essa é uma das distinções mais importantes do REA. No caminho estático de JavaScript e .NET, os arquivos são lidos sem executar a aplicação. Uma captura de processo, uma sessão Frida ou um cenário Playwright podem executar ou interagir com o alvo, com os privilégios do usuário.
O adaptador de observação CDP se conecta a um navegador selecionado para coletar evidências passivas; os provedores de cenário que dirigem um navegador são outra superfície. Não trate todo recurso relacionado a browser como equivalente a um simples screenshot.
Frida também não é apenas um visualizador: scripts de instrumentação executam dentro do processo selecionado. GDB pode alterar estado e executar comandos. Antes de usar recursos dinâmicos, estabeleça o alvo, a finalidade, os efeitos permitidos e a limpeza esperada. O guia de Frida documenta seus limites e ciclo de vida.
“Local” não significa sandbox nem sigilo absoluto
- Parser é código. Abrir um arquivo desconhecido entrega bytes a um parser ou ferramenta; análise estática não torna um artefato automaticamente seguro.
- REA não é sandbox. Use uma VM ou ambiente isolado adequado para alvos não confiáveis. Não monte sua pasta pessoal inteira dentro do laboratório.
- Autoridade é específica. Permissão para ler um arquivo não implica permissão para executá-lo, interceptar tráfego ou modificar um dispositivo.
- Provedor de modelo: resultados locais entregues a um agente em nuvem podem entrar no contexto enviado ao provedor.
- Evidência é sensível. Capturas, strings, nomes internos, caminhos, código e payloads podem conter dados privados. Revise antes de compartilhar.
- Conteúdo não é instrução. Um binário, documento ou resposta de ferramenta pode conter texto malicioso; não deixe a memória ou o resultado de análise autorizar novos comandos.
O modelo de segurança descreve as proteções de transporte e também o que elas não fazem. O disclaimer delimita a finalidade do projeto e as responsabilidades de uso. Este artigo não é orientação jurídica: autorização, contratos, privacidade e direitos sobre os resultados precisam ser avaliados no contexto concreto.
Como pedir uma investigação útil ao agente
Uma solicitação vaga como “clone esse programa” convida a inferências sem teste e expansões de escopo. Um pedido melhor explicita a pergunta, o material autorizado e o resultado esperado:
Analise somente esta cópia local do aplicativo de laboratório.
Objetivo: entender o fluxo de normalização de nomes antes da exportação.
Comece por análise estática; não execute o alvo nem abra conexões de rede.
Para cada conclusão, indique o arquivo ou função de origem e a evidência.
Separe observações, inferências e o que continua desconhecido.
Não proponha equivalência funcional sem testes para as entradas escolhidas.
Se uma etapa dinâmica for necessária, apresente o motivo e peça aprovação.
Para uma implementação nova, peça primeiro uma especificação de comportamento com entradas, saídas, erros e casos extremos. Depois, faça o código candidato passar por testes independentes. Um processo realmente separado de sala limpa exige controles de acesso e separação efetiva; não é garantido por escrever “clean-room” no prompt ou trocar o nome do agente.
Tokens, maturidade e manutenção
Catálogos MCP e relatórios extensos podem ocupar muito contexto. Comece por uma pergunta pequena, salve Evidence em disco e use resumos ou páginas quando o fluxo suportar. Alguns inventários nativos retornam coleções completas; não presuma que um parâmetro de paginação exista em toda operação.
A versão analisada documenta opções como REA_MCP_INPUT_SCHEMA_PROFILE=compact para compatibilidade com clientes que limitam schemas. Isso muda a apresentação do contrato, não cria uma garantia universal de menos tokens ou respostas pequenas. Consulte os perfis de schema antes de alterar a configuração.
O projeto tem testes e verificações específicas por ferramenta, mas suporte declarado e testes simulados não substituem execução com o provedor real. O guia de testes deixa essa distinção explícita. Não usamos estrelas ou número de commits como certificado de maturidade.
REA evolui rápido. Fixar uma versão ajuda a reproduzir uma investigação; para atualizar, confira as notas, requisitos e mudanças de contrato, atualize a CLI e revise também o setup e as instruções do agente. Não misture silenciosamente documentação de main, pacote npm antigo e skill de outra release.
Então, a Adobe morreu?
Não é isso que o REA demonstra. Entender um algoritmo ou fluxo de um aplicativo não reproduz automaticamente o produto inteiro, suas integrações, dados, infraestrutura, formatos e critérios de qualidade. A distinção discutida pelo Akita é um bom antídoto contra transformar uma demonstração interessante em promessa universal.
O ganho real está em investigar melhor: perguntas menores, ferramentas adequadas, evidência rastreável e testes que enfrentam a hipótese. Para quem usa agentes no terminal Linux, REA acrescenta uma bancada especializada — diferente de ferramentas que guardam memória das sessões ou mapeiam a estrutura do próprio repositório.
Comece por algo seu e pequeno. O exercício JavaScript já permite aprender o contrato de evidência sem instalar um decompilador. Depois, escolha um provedor e um caso autorizado. REA é uma caixa de ferramentas poderosa; o que torna o resultado confiável continua sendo escopo, método e verificação.