
Todo sistema web llega al punto en que el usuario no puede esperar: el correo de bienvenida, la miniatura de la foto, el informe que tarda dos minutos en generarse. Si eso se ejecuta dentro de la petición HTTP, la página se queda colgada, salta el tiempo de espera y un fallo en el SMTP se convierte en un error 500 en la cara del cliente. La salida es una cola de tareas: la API registra el trabajo y responde al instante, y procesos separados ejecutan el servicio en segundo plano, con reintentos cuando algo falla. En el mundo Go, la biblioteca más usada para esto es Asynq, que utiliza Redis como broker y viene con un panel web, el Asynqmon. Esta guía monta un ejemplo completo, probado de verdad contra Redis y Valkey en contenedores, y termina con despliegue en systemd y métricas en Prometheus.
Qué es Asynq
O Asynq es una biblioteca Go, licencia MIT, creada por Ken Hibino. El modelo es sencillo:
- o cliente (
asynq.Client) pone la tarea en una cola en Redis; - o servidor (
asynq.Server) extrae tareas de las colas y abre una goroutine por tarea, hasta el límite deConcurrency; - un ServeMux dirige cada tarea por el tipo (
email:boas-vindas,imagem:miniatura), igual que elnet/httpdirige URLs.
Una tarea es solo un tipo (cadena) más un payload en bytes, normalmente JSON. Como el estado completo queda en Redis, escalas ejecutando más copias del worker en otras máquinas, sin coordinación adicional. Si estás empezando con el lenguaje, vale la pena leer la historia del lenguaje Go y la guía de instalación de Go en Linux.
Arquitectura y funcionalidades
Lo que Asynq ofrece listo para usar, con el nombre de la opción en la API:
- Entrega al menos una vez (at-least-once) : si el worker muere a mitad de la operación, la tarea vuelve a la cola. Por eso el handler debe ser idempotente.
- Colas con prioridad:
Queues: map[string]int{"critical": 6, "default": 3, "low": 1}divide el tiempo en 60/30/10% cuando todas tienen trabajo (prioridad ponderada). ConStrictPriority: true, la cola de menor prioridad solo avanza cuando las de arriba están vacías. - Reintentos con backoff: el patrón es
MaxRetry25 y retraso exponencial (la fórmula de Sidekiq, n4 + 15 s + un valor aleatorio). Todo ajustable por tarea y porRetryDelayFunc(wiki: Reintento de tareas). Un error envuelto conasynq.SkipRetrysalta los reintentos. - Tareas programadas:
ProcessIn(30*time.Second)oProcessAt(t)dejan la tarea en el estadoscheduledhasta la hora. - Tareas periódicas: el
asynq.Schedulerencola tareas por expresión cron o@every(wiki: Tareas periódicas). - Desduplicación:
Unique(ttl)rechaza una segunda tarea con el mismo tipo, payload y cola mientras la primera no se procese con éxito o el TTL no expire, y devuelveErrDuplicateTask.TaskID("...")asigna un ID fijo a la tarea y rechaza la repetición conErrTaskIDConflict(wiki: Tareas únicas). - Agrupación en grupos: tareas encoladas con
Group("nome")quedan enaggregatingy unGroupAggregatorse unen en una sola, controlado porGroupGracePeriod,GroupMaxDelayeGroupMaxSize. Sirve, por ejemplo, para enviar un único correo electrónico con diez notificaciones (wiki: Agregación de tareas). - Timeout y deadline:
Timeout(d)(por defecto de 30 minutos) yDeadline(t)cancelan elcontext.Contextdel handler (wiki: Tiempo de espera y cancelación). - Tareas archivadas: quien agota los intentos o devuelve
SkipRetryva aarchived, donde queda disponible para inspección y reprocesamiento manual desde la CLI o el panel. - Retención:
Retention(24*time.Hour)guarda la tarea completada comocompleted, útil para auditoría.
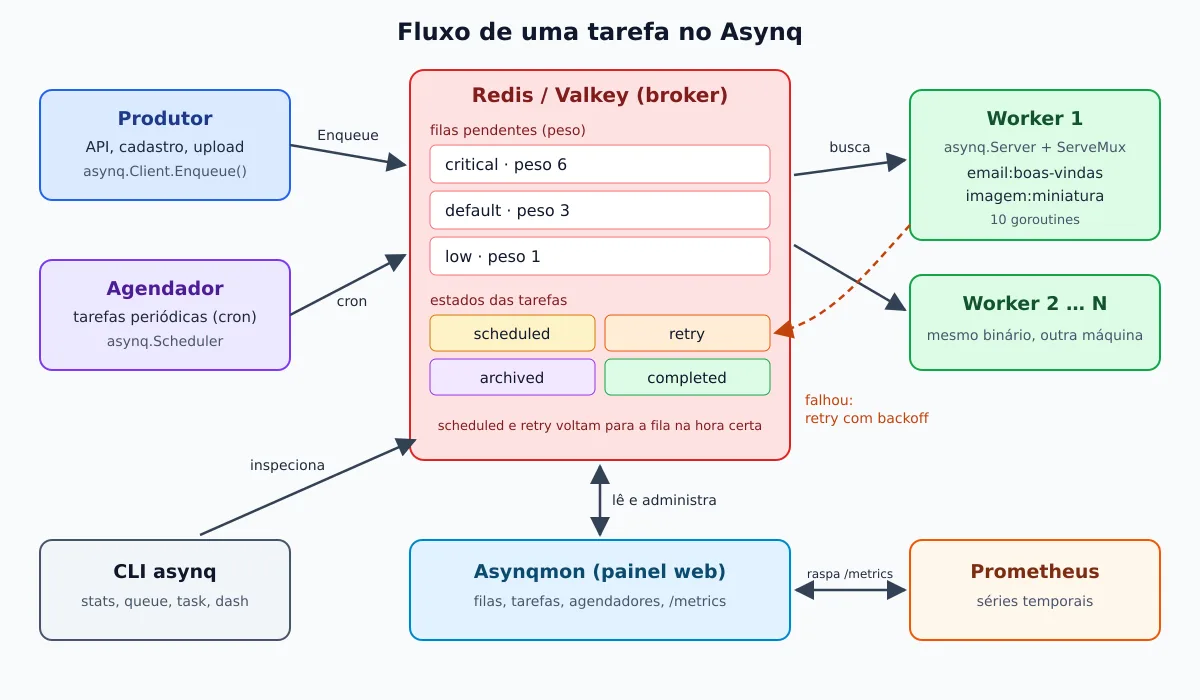
El recorrido de una tarea, desde el productor hasta el panel:
Estado actual de los proyectos
Antes de poner una dependencia en producción, mírela. Revisado en GitHub el 23 de septiembre de 2026:
- Asynq: última versión v0.26.0, del 3 de febrero de 2026. Subió el mínimo a Go 1.24 y trajo cabeceras en las tareas,
--tlsnoasynq dash, usuario de ACL de Redis en la CLI (--username) yUpdateTaskPayloaden el Inspector. La ramamastertiene 25 commits más allá de la etiqueta, con el último en 12 de junio de 2026 (entre ellos unBatchEnqueueaún sin release). El repositorio tiene cerca de 13,7 mil estrellas y más de 290 issues abiertas. El README dice que el proyecto es “relativamente estable” y sigue en versiónv0.x: la API pública aún puede romperse entre versiones menores. - Go: el README promete soporte a las dos últimas versiones de Go, y la CI prueba 1.24.x y 1.25.x contra
redis:7. Compilé con Go 1.27.1 sin ningún ajuste. - Redis: el README exige Redis 4.0 o superior y avisa de que algunos scripts Lua pueden no ser compatibles con Redis Cluster. Redis Sentinel es compatible.
- Valkey: no hay declaración oficial de compatibilidad. El issue #981 reúne testimonios de uso en producción con Valkey (y con Dragonfly, usando
--default_lua_flags=allow-undeclared-keys) y la solicitud de documentación (#985) sigue abierta. En mi prueba de abajo, el ejemplo completo se ejecutó igual en Valkey 8.1. - Asynqmon: aquí la situación es peor. La última versión es la v0.7.1, de mayo de 2022. El último commit es de julio de 2023, y la imagen
hibiken/asynqmon:0.7.2(tambiénlatest) en Docker Hub se publicó el mismo día, sin versión correspondiente en GitHub. El código depende de Asynq v0.24.1, y la tabla de compatibilidad del README para en “Asynq 0.23.x ↔ Asynqmon 0.7.x”. En la práctica, leyó y administró sin error las colas creadas por Asynq v0.26.0 en mi prueba, pero trátelo como una herramienta detenida en el tiempo, no como un producto mantenido.
Laboratorio: Redis y Valkey en contenedores
Para la prueba, levanté un Redis 8 y un Valkey 8 en una red Docker propia, además del Asynqmon apuntando al Redis. Si Docker aún te resulta nuevo, empieza por la historia de Docker.
docker network create filas
docker run -d --name redis  --network filas -p 127.0.0.1:6379:6379 redis:8-alpine
docker run -d --name valkey --network filas -p 127.0.0.1:6380:6379 valkey/valkey:8-alpine

docker exec redis redis-server --version
docker exec valkey valkey-server --version
Redis server v=8.10.2 sha=00000000:1 malloc=jemalloc-5.3.0 bits=64 build=6583f6419e33bdeb
Valkey server v=8.1.8 sha=00000000:0 malloc=jemalloc-5.3.0 bits=64 build=288c3332651d2a23Las puertas quedan atascadas en 127.0.0.1: un Redis sin contraseña expuesto en internet es una intrusión garantizada.
El ejemplo: módulo Go con productor, worker y programador
El módulo tiene tres binarios y un paquete compartido:
filas/
├── go.mod
├── tarefas/tarefas.go      # tipos, payloads e handlers
└── cmd/
    ├── produtor/main.go    # enfileira as tarefas
    ├── worker/main.go      # asynq.Server + ServeMux
    └── agendador/main.go   # tarefas periódicas
mkdir filas && cd filas
go mod init exemplo.com/filas
go get github.com/hibiken/asynq@v0.26.0Tipos de tarea y handlers
Cada tipo obtiene una función que crea la tarea y un handler que la ejecuta. El handler de la miniatura simula un almacenamiento inestable: falla en los dos primeros intentos y solo funciona en el tercero. Un archivo .bmp es un error permanente y va directo al archivo, sin reintentos.
// Package tarefas define os tipos de tarefa, os payloads e os handlers.
package tarefas

import (
	"context"
	"encoding/json"
	"fmt"
	"log"
	"os"
	"strings"
	"time"

	"github.com/hibiken/asynq"
)

// Tipos de tarefa: o ServeMux roteia pelo prefixo, como rotas HTTP.
const (
	TipoEmailBoasVindas = "email:boas-vindas"
	TipoMiniatura       = "imagem:miniatura"
	TipoRelatorio       = "relatorio:diario"
)

// RedisAddr lê o endereço do Redis/Valkey do ambiente.
func RedisAddr() string {
	if a := os.Getenv("REDIS_ADDR"); a != "" {
		return a
	}
	return "127.0.0.1:6379"
}

type EmailPayload struct {
	UsuarioID int    `json:"usuario_id"`
	Email     string `json:"email"`
}

type MiniaturaPayload struct {
	Origem  string `json:"origem"`
	Largura int    `json:"largura"`
}

func NovaTarefaEmail(id int, email string) (*asynq.Task, error) {
	p, err := json.Marshal(EmailPayload{UsuarioID: id, Email: email})
	if err != nil {
		return nil, err
	}
	// Opções padrão da tarefa; podem ser sobrescritas no Enqueue.
	return asynq.NewTask(TipoEmailBoasVindas, p,
		asynq.Queue("critical"), asynq.MaxRetry(5), asynq.Timeout(30*time.Second)), nil
}

func NovaTarefaMiniatura(origem string, largura int) (*asynq.Task, error) {
	p, err := json.Marshal(MiniaturaPayload{Origem: origem, Largura: largura})
	if err != nil {
		return nil, err
	}
	return asynq.NewTask(TipoMiniatura, p, asynq.MaxRetry(3), asynq.Timeout(2*time.Minute)), nil
}

func HandleEmail(ctx context.Context, t *asynq.Task) error {
	var p EmailPayload
	if err := json.Unmarshal(t.Payload(), &p); err != nil {
		// Payload inválido nunca vai dar certo: não adianta tentar de novo.
		return fmt.Errorf("payload inválido: %v: %w", err, asynq.SkipRetry)
	}
	id, _ := asynq.GetTaskID(ctx)
	log.Printf("e-mail de boas-vindas para %s (usuário %d, tarefa %s)", p.Email, p.UsuarioID, id)
	return nil
}

func HandleMiniatura(ctx context.Context, t *asynq.Task) error {
	var p MiniaturaPayload
	if err := json.Unmarshal(t.Payload(), &p); err != nil {
		return fmt.Errorf("payload inválido: %v: %w", err, asynq.SkipRetry)
	}
	if strings.HasSuffix(p.Origem, ".bmp") {
		// Erro permanente: vai direto para "archived", sem retry.
		return fmt.Errorf("formato não suportado: %s: %w", p.Origem, asynq.SkipRetry)
	}
	tentativa, _ := asynq.GetRetryCount(ctx)
	if tentativa < 2 {
		// Simula falha transitória (storage fora do ar) nas duas primeiras tentativas.
		return fmt.Errorf("storage indisponível ao ler %s (tentativa %d)", p.Origem, tentativa+1)
	}
	select {
	case <-time.After(3 * time.Second): // "trabalho" pesado
	case <-ctx.Done(): // timeout, deadline ou desligamento
		return ctx.Err()
	}
	log.Printf("miniatura %dpx gerada para %s na tentativa %d", p.Largura, p.Origem, tentativa+1)
	return nil
}

func HandleRelatorio(ctx context.Context, t *asynq.Task) error {
	log.Printf("relatório diário gerado às %s", time.Now().Format("15:04:05"))
	return nil
}
Productor: encolar, deduplicar y programar
El productor hace el papel de tu API: graba cuatro tareas. El correo se encola dos veces con Unique para mostrar la deduplicación. El banner se programa para 30 segundos después, con su propio ID y una retención de 24 horas.
package main

import (
	"errors"
	"log"
	"time"

	"exemplo.com/filas/tarefas"
	"github.com/hibiken/asynq"
)

func main() {
	client := asynq.NewClient(asynq.RedisClientOpt{Addr: tarefas.RedisAddr()})
	defer client.Close()

	// 1) E-mail imediato na fila "critical". Unique evita duplicar o envio
	//    se o cadastro for reprocessado dentro de 1 hora.
	for i := 0; i < 2; i++ {
		t, _ := tarefas.NovaTarefaEmail(42, "ana@exemplo.com.br")
		info, err := client.Enqueue(t, asynq.Unique(time.Hour))
		if errors.Is(err, asynq.ErrDuplicateTask) {
			log.Printf("duplicada, ignorada: %v", err)
			continue
		}
		if err != nil {
			log.Fatal(err)
		}
		log.Printf("enfileirada: id=%s fila=%s tipo=%s", info.ID, info.Queue, info.Type)
	}

	// 2) Miniatura na fila "default" (falha 2x e é reprocessada).
	t, _ := tarefas.NovaTarefaMiniatura("uploads/foto-42.jpg", 320)
	info, err := client.Enqueue(t)
	if err != nil {
		log.Fatal(err)
	}
	log.Printf("enfileirada: id=%s fila=%s tipo=%s", info.ID, info.Queue, info.Type)

	// 3) Miniatura agendada para daqui a 30 s, na fila "low", com ID próprio.
	t, _ = tarefas.NovaTarefaMiniatura("uploads/banner.png", 1200)
	info, err = client.Enqueue(t, asynq.ProcessIn(30*time.Second),
		asynq.Queue("low"), asynq.TaskID("miniatura-banner"), asynq.Retention(24*time.Hour))
	if err != nil {
		log.Fatal(err)
	}
	log.Printf("agendada: id=%s fila=%s estado=%s para=%s",
		info.ID, info.Queue, info.State, info.NextProcessAt.Format("15:04:05"))

	// 4) Erro permanente: termina em "archived" sem retry.
	t, _ = tarefas.NovaTarefaMiniatura("uploads/antiga.bmp", 320)
	info, err = client.Enqueue(t)
	if err != nil {
		log.Fatal(err)
	}
	log.Printf("enfileirada: id=%s fila=%s tipo=%s", info.ID, info.Queue, info.Type)
}
Worker con ServeMux, reintentos y apagado limpio
O RetryDelayFunc aquí es corto a propósito, para que la demostración quepa en un minuto. En producción, omite el campo y quédate con el backoff exponencial por defecto. El srv.Run se encarga solo de las señales: SIGTERM o SIGINT cierran con calma, y SIGTSTP deja de tomar tareas nuevas sin tirar el proceso.
package main

import (
	"context"
	"log"
	"time"

	"exemplo.com/filas/tarefas"
	"github.com/hibiken/asynq"
)

func main() {
	srv := asynq.NewServer(
		asynq.RedisClientOpt{Addr: tarefas.RedisAddr()},
		asynq.Config{
			Concurrency: 10,
			// Prioridade ponderada: 60% critical, 30% default, 10% low.
			Queues: map[string]int{"critical": 6, "default": 3, "low": 1},
			// Backoff curto só para a demonstração: 5 s, 10 s, 15 s...
			// Em produção, omita e use o exponencial padrão.
			RetryDelayFunc: func(n int, err error, t *asynq.Task) time.Duration {
				return time.Duration(n+1) * 5 * time.Second
			},
			ErrorHandler: asynq.ErrorHandlerFunc(func(ctx context.Context, t *asynq.Task, err error) {
				n, _ := asynq.GetRetryCount(ctx)
				max, _ := asynq.GetMaxRetry(ctx)
				log.Printf("ERRO %s (retry %d/%d): %v", t.Type(), n, max, err)
			}),
			// No SIGTERM, espera até 20 s as tarefas em andamento terminarem.
			ShutdownTimeout: 20 * time.Second,
		},
	)

	mux := asynq.NewServeMux()
	mux.HandleFunc(tarefas.TipoEmailBoasVindas, tarefas.HandleEmail)
	mux.HandleFunc(tarefas.TipoMiniatura, tarefas.HandleMiniatura)
	mux.HandleFunc(tarefas.TipoRelatorio, tarefas.HandleRelatorio)

	// Run bloqueia até receber SIGTERM/SIGINT e então desliga com calma.
	if err := srv.Run(mux); err != nil {
		log.Fatal(err)
	}
}
Programador de tareas periódicas
package main

import (
	"log"
	"time"

	"exemplo.com/filas/tarefas"
	"github.com/hibiken/asynq"
)

func main() {
	// Sem Location, o Scheduler interpreta o cron em UTC.
	fuso, err := time.LoadLocation("America/Sao_Paulo")
	if err != nil {
		log.Fatal(err)
	}
	s := asynq.NewScheduler(asynq.RedisClientOpt{Addr: tarefas.RedisAddr()}, &asynq.SchedulerOpts{
		Location: fuso,
		PostEnqueueFunc: func(info *asynq.TaskInfo, err error) {
			if err != nil {
				log.Printf("falha ao enfileirar periódica: %v", err)
				return
			}
			log.Printf("periódica enfileirada: %s id=%s", info.Type, info.ID)
		},
	})

	// Sintaxe cron (robfig/cron): todo dia às 03:00...
	if _, err := s.Register("0 3 * * *", asynq.NewTask(tarefas.TipoRelatorio, nil), asynq.Queue("low")); err != nil {
		log.Fatal(err)
	}
	// ...ou intervalo fixo, útil para testar.
	id, err := s.Register("@every 20s", asynq.NewTask(tarefas.TipoRelatorio, []byte(`{"teste":true}`)), asynq.Queue("low"))
	if err != nil {
		log.Fatal(err)
	}
	log.Printf("entrada registrada: %s", id)

	if err := s.Run(); err != nil {
		log.Fatal(err)
	}
}
Atención a la zona horaria: sin Location, el Scheduler interpreta el cron en UTC. En la primera prueba, sin esa opción, el 0 3 * * * estaba marcado para las 11h35 a partir de ese momento, es decir, medianoche en el horario de Brasilia. Con America/Sao_Paulo, el log confirma:
2026/09/23 12:24:53 entrada registrada: 4e28eaa1-ddd4-40d5-9dc6-2e96f770e600
asynq: pid=416391 2026/09/23 15:24:53.136229 INFO: Scheduler starting
asynq: pid=416391 2026/09/23 15:24:53.136232 INFO: Scheduler timezone is set to America/Sao_Paulo
asynq: pid=416391 2026/09/23 15:24:53.136241 INFO: Send signal TERM or INT to stop the scheduler
2026/09/23 12:25:13 periódica enfileirada: relatorio:diario id=217bb335-888a-4148-bdb2-121c19f6d8a8
2026/09/23 12:25:33 periódica enfileirada: relatorio:diario id=9d80f7ea-26c1-4e08-b0ee-124579c81e88
2026/09/23 12:25:53 periódica enfileirada: relatorio:diario id=1e43a446-4fc8-41c7-ab44-6285a8e53203
2026/09/23 12:26:13 periódica enfileirada: relatorio:diario id=399dc3e0-5d5d-4407-b10c-f14ba55c9eb3
asynq: pid=416391 2026/09/23 15:26:17.022259 INFO: Scheduler shutting down
asynq: pid=416391 2026/09/23 15:26:17.022798 INFO: Scheduler stopped
Solo ejecute un programador por entorno: dos copias ponen en cola cada tarea periódica dos veces. Los workers, en cambio, los replica a voluntad.
Ejecutando el ejemplo
Compile, levante el worker y el programador, pause la cola default por la CLI (para ver las tareas detenidas en el panel) y ejecute el productor:
go build -o bin/ ./cmd/...
export REDIS_ADDR=127.0.0.1:6379

bin/worker &
bin/agendador &
asynq queue pause default
bin/produtor
2026/09/23 12:24:55 enfileirada: id=542783fc-53f6-48c4-bff3-b3ded2e72681 fila=critical tipo=email:boas-vindas
2026/09/23 12:24:55 duplicada, ignorada: task already exists
2026/09/23 12:24:55 enfileirada: id=3b3008d8-9889-497a-aca8-3dd2cab5f84c fila=default tipo=imagem:miniatura
2026/09/23 12:24:55 agendada: id=miniatura-banner fila=low estado=scheduled para=12:25:25
2026/09/23 12:24:55 enfileirada: id=16d93751-6b19-4ca7-84fa-71cc2a20c306 fila=default tipo=imagem:miniaturaLa segunda llamada con Unique volvió task already exists, y el banner quedó en scheduled. Después de asynq queue unpause default, el registro del worker cuenta toda la historia:
asynq: pid=416390 2026/09/23 15:24:53.136156 INFO: Starting processing
asynq: pid=416390 2026/09/23 15:24:53.136186 INFO: Send signal TSTP to stop processing new tasks
asynq: pid=416390 2026/09/23 15:24:53.136187 INFO: Send signal TERM or INT to terminate the process
2026/09/23 12:24:55 e-mail de boas-vindas para ana@exemplo.com.br (usuário 42, tarefa 542783fc-53f6-48c4-bff3-b3ded2e72681)
2026/09/23 12:25:14 ERRO imagem:miniatura (retry 0/3): storage indisponível ao ler uploads/foto-42.jpg (tentativa 1)
2026/09/23 12:25:14 ERRO imagem:miniatura (retry 0/3): formato não suportado: uploads/antiga.bmp: skip retry for the task
asynq: pid=416390 2026/09/23 15:25:14.093162 WARN: Retry exhausted for task id=16d93751-6b19-4ca7-84fa-71cc2a20c306
2026/09/23 12:25:14 relatório diário gerado às 12:25:14
2026/09/23 12:25:23 ERRO imagem:miniatura (retry 1/3): storage indisponível ao ler uploads/foto-42.jpg (tentativa 2)
2026/09/23 12:25:28 ERRO imagem:miniatura (retry 0/3): storage indisponível ao ler uploads/banner.png (tentativa 1)
2026/09/23 12:25:33 relatório diário gerado às 12:25:33
2026/09/23 12:25:33 ERRO imagem:miniatura (retry 1/3): storage indisponível ao ler uploads/banner.png (tentativa 2)
2026/09/23 12:25:36 miniatura 320px gerada para uploads/foto-42.jpg na tentativa 3
2026/09/23 12:25:47 miniatura 1200px gerada para uploads/banner.png na tentativa 3
2026/09/23 12:25:53 relatório diário gerado às 12:25:53
2026/09/23 12:26:11 ERRO imagem:miniatura (retry 0/3): formato não suportado: uploads/antiga.bmp: skip retry for the task
asynq: pid=416390 2026/09/23 15:26:11.619533 WARN: Retry exhausted for task id=16d93751-6b19-4ca7-84fa-71cc2a20c306
2026/09/23 12:26:13 relatório diário gerado às 12:26:13
asynq: pid=416390 2026/09/23 15:26:14.020184 INFO: Stopping processor
asynq: pid=416390 2026/09/23 15:26:14.449245 INFO: Processor stopped
asynq: pid=416390 2026/09/23 15:26:14.449276 INFO: Starting graceful shutdown
asynq: pid=416390 2026/09/23 15:26:14.449296 INFO: Waiting for all workers to finish...
asynq: pid=416390 2026/09/23 15:26:14.449300 INFO: All workers have finished
asynq: pid=416390 2026/09/23 15:26:14.449797 INFO: Exiting
Léelo en orden:
- el correo electrónico salió a tiempo, por la cola
critical, que no estaba pausada; - a
foto-42.jpgfalló dos veces y acertó a la tercera, con 9 y 13 segundos entre los intentos (retraso de 5 s y 10 s más la comprobación periódica de Asynq); - a
antiga.bmpfue aarchiveden el primer fallo, debido alSkipRetry. El avisoRetry exhaustedes el mensaje que Asynq utiliza en ese caso; - el banner programado para 12:25:25 comenzó a las 12:25:28: Asynq verifica las tareas programadas cada 5 segundos, así que no cuentes con precisión de segundos;
- a las 12:26:11, reprocesé la tarea archivada con
asynq task run, y ella volvió al archivo, como se esperaba; - no
SIGTERM, el servidor dejó de tirar tareas, esperó a los workers y salió. Si una tarea pasa deShutdownTimeout, ella vuelve al Redis y se ejecuta de nuevo en otro worker, y de ahí viene la exigencia de idempotencia.
Los horarios con prefijo asynq: están en UTC (logger interno de la biblioteca), y los demás en horario local.
La misma prueba en Valkey
Cambié solo la variable: REDIS_ADDR=127.0.0.1:6380. Deduplicación, reintentos, agendamiento, archivado y periódicas se comportaron igual. La tarea en retry en el resumen de abajo es el banner: cerré el worker antes del tercer intento. La CLI muestra la versión 7.2.4 porque Valkey se presenta con esa versión de compatibilidad en INFO:
Task Count by State
active     pending    aggregating  scheduled  retry      archived   completed
---------  ---------  ---------    ---------  ---------  ---------  ---------
0          0          0            0          1          1          0

Task Count by Queue
critical  default   low
--------  --------  --------
0         1         1

Daily Stats 2026-09-23 UTC
processed  failed  error rate
---------  ------  ----------
9          5       55.56%

Redis Info
version  uptime  connections  memory usage  peak memory usage
-------  ------  -----------  ------------  -----------------
7.2.4    0 days  1            1.70MB        1.71MB
La CLI asynq
La herramienta de línea de comando está en un módulo separado del repositorio:
go install github.com/hibiken/asynq/tools/asynq@latestUn detalle: el módulo tools no tiene etiqueta propia, así que el @latest resolver a un commit del master (en mi caso, del 12 de junio de 2026) que todavía declara dependencia de Asynq v0.25.0. Funcionó sin problema contra colas de la v0.26.0. Los comandos que más uso:
asynq stats                                   # visão geral por estado e por fila
asynq queue ls                                # lista as filas
asynq queue inspect default                   # detalhes de uma fila
asynq queue pause default                     # para de entregar tarefas da fila
asynq task ls --queue=default --state=archived
asynq task run --queue=default --id=<ID>     # reprocessa uma arquivada
asynq server ls                               # workers conectados
asynq cron ls                                 # entradas do Scheduler
asynq dash                                    # painel no terminal (TUI)
Para otro servidor, usa --uri host:porta, --password, --username e --tls. Salidas reales del laboratorio:
$ asynq stats
Task Count by State
active     pending    aggregating  scheduled  retry      archived   completed
---------  ---------  ---------    ---------  ---------  ---------  ---------
0          0          0            0          0          1          1

Task Count by Queue
critical  default   low
--------  --------  --------
0         1         1

Daily Stats 2026-09-23 UTC
processed  failed  error rate
---------  ------  ----------
13         6       46.15%

Redis Info
version  uptime  connections  memory usage  peak memory usage
-------  ------  -----------  ------------  -----------------
8.10.2   0 days  4            2.32MB        2.38MB


$ asynq task ls --queue=default --state=archived
ID                                    Type              Payload                                        Last Failed                   Last Error
--                                    ----              -------                                        -----------                   ----------
16d93751-6b19-4ca7-84fa-71cc2a20c306  imagem:miniatura  {"origem":"uploads/antiga.bmp","largura":320}  Wed Sep 23 12:26:11 -03 2026  formato não suportado: uploads/antiga.bmp: skip retry for the task
Asynqmon: el panel web
O Asynqmon se ejecuta como binario, contenedor o biblioteca embebida en tu aplicación (asynqmon.New(...) devuelve un http.Handler). La forma más rápida es la imagen Docker, en la misma red que Redis:
docker run -d --name asynqmon --network filas \
  -p 127.0.0.1:8080:8080 \
  hibiken/asynqmon:0.7.2 \
  --redis-addr=redis:6379 \
  --enable-metrics-exporter
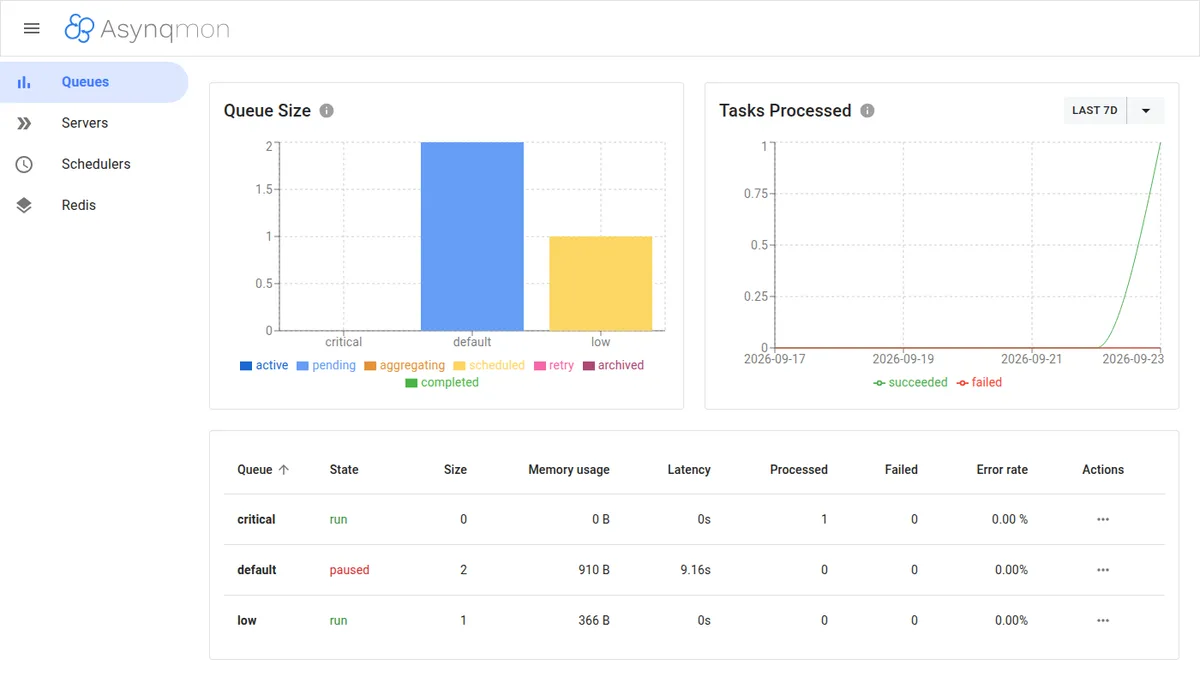
Abre http://127.0.0.1:8080. La pestaña Queues muestra tamaño, memoria, latencia, procesadas y tasa de error por cola. En la captura siguiente, la default aparece pausada, con las dos miniaturas pendientes:
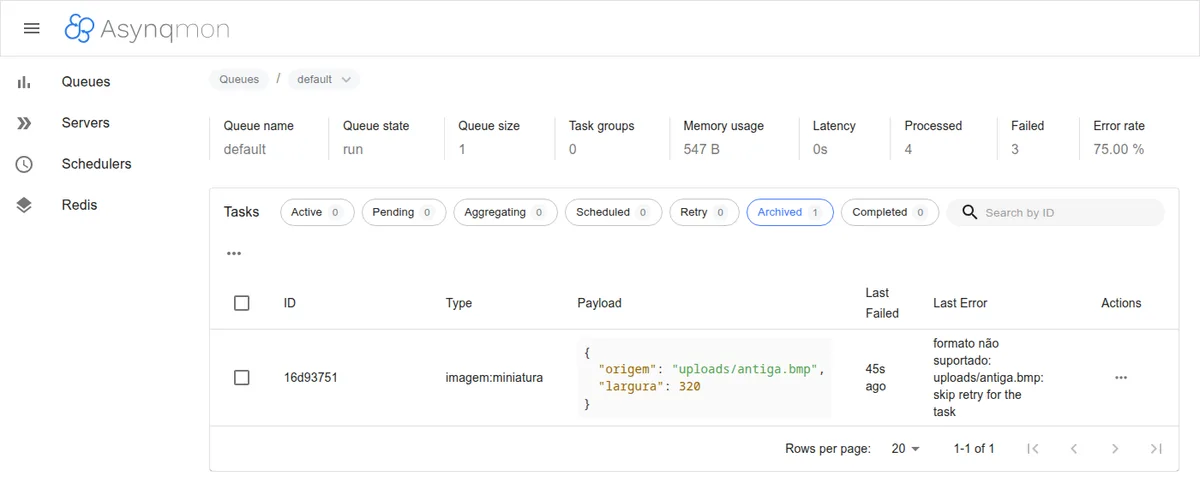
Al hacer clic en una cola, verás las tareas por estado (active, pending, aggregating, scheduled, retry, archived, completed), con payload y último error. Desde ahí se puede reejecutar, eliminar o archivar en lote:
La pestaña Schedulers enumera las entradas periódicas registradas, con el siguiente y el último encolamiento:
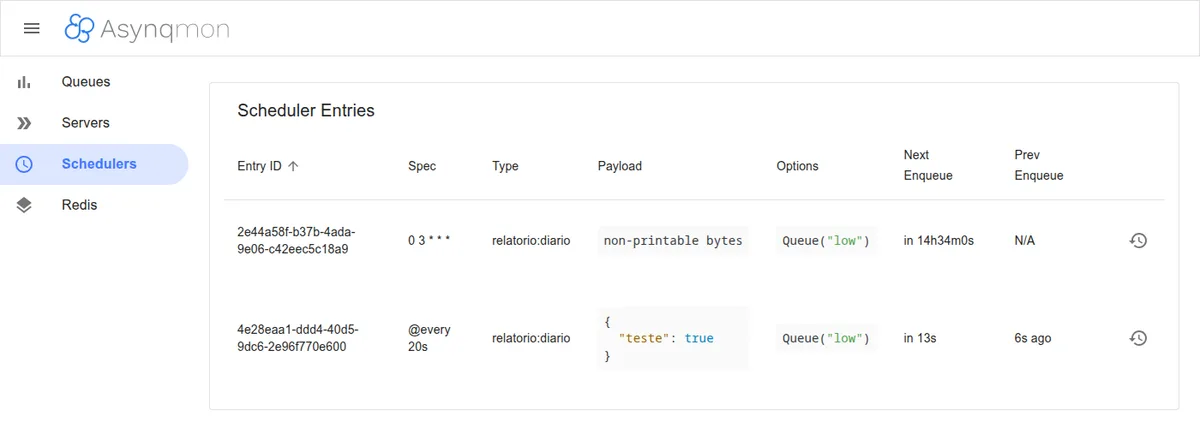
El panel no tiene ninguna autenticación: quien accede puede borrar colas enteras. Déjelo atrapado en 127.0.0.1 y publíquelo detrás de un proxy inverso con inicio de sesión, VPN o túnel SSH. Para quien solo necesita mirar, existe --read-only.
Métricas en Prometheus
Hay dos caminos, ambos comprobados en el código:
- A través de Asynqmon: con
--enable-metrics-exporter, expone/metricscon el estado de las colas. Con--prometheus-addr=http://prometheus:9090, también consulta Prometheus y activa la pestaña de gráficos históricos. - Dentro de su aplicación: el paquete
github.com/hibiken/asynq/x/metricstiene unNewQueueMetricsCollector(inspector)que registras en tu propioprometheus.Registry, sin depender de Asynqmon.
La salida real del exportador de Asynqmon en el laboratorio:
curl -s 127.0.0.1:8080/metrics | grep '^asynq_' | grep defaultasynq_queue_latency_seconds{queue="default"} 0
asynq_queue_memory_usage_approx_bytes{queue="default"} 547
asynq_queue_paused_total{queue="default"} 0
asynq_queue_size{queue="default"} 1
asynq_tasks_enqueued_total{queue="default",state="active"} 0
asynq_tasks_enqueued_total{queue="default",state="archived"} 1
asynq_tasks_enqueued_total{queue="default",state="completed"} 0
asynq_tasks_enqueued_total{queue="default",state="pending"} 0
asynq_tasks_enqueued_total{queue="default",state="retry"} 0
asynq_tasks_enqueued_total{queue="default",state="scheduled"} 0
asynq_tasks_failed_total{queue="default"} 4
asynq_tasks_processed_total{queue="default"} 5Y el fragmento de prometheus.yml:
scrape_configs:
  - job_name: asynq
    static_configs:
      - targets: ["127.0.0.1:8080"]
Las alertas que merecen la pena: asynq_queue_size creciendo sin parar (workers insuficientes o parados), asynq_queue_latency_seconds alto en la cola critical y cualquier aumento de asynq_tasks_enqueued_total{state="archived"}. Si aún no tienes Prometheus, la guía Monitorizando servidores Linux con Prometheus y Node Exporter sentará las bases.
Despliegue: el worker como servicio systemd
El worker es un binario estático, sin runtime, y funciona bien con un usuario sin privilegios. El punto central es el TimeoutStopSec, que debe ser mayor que el ShutdownTimeout del código (20 s). Sin esto, systemd envía SIGKILL antes de que Asynq devuelva las tareas en curso.
# /etc/systemd/system/filas-worker.service
[Unit]
Description=Worker Asynq (filas)
After=network-online.target
Wants=network-online.target

[Service]
Type=simple
User=filas
Group=filas
Environment=REDIS_ADDR=127.0.0.1:6379
ExecStart=/usr/local/bin/filas-worker
KillSignal=SIGTERM
TimeoutStopSec=30
Restart=on-failure
RestartSec=5
NoNewPrivileges=true
ProtectSystem=strict
ProtectHome=true
PrivateTmp=true

[Install]
WantedBy=multi-user.target
sudo useradd --system --no-create-home --shell /usr/sbin/nologin filas
sudo install -m 755 bin/worker /usr/local/bin/filas-worker
sudo systemctl daemon-reload
sudo systemctl enable --now filas-worker
journalctl -u filas-worker -fEl programador obtiene una unit igual, con ExecStart=/usr/local/bin/filas-agendador, en una solo máquina. Para más comandos del día a día, consulte Dominando systemd. Si su productor es una API Go, la serie Vue.js + Go con Echo v5 muestra cómo montarla, y la parte 5 cubre binario único, Docker y systemd, un encaje natural para llamar client.Enqueue dentro de los handlers.
Buenas prácticas
- Idempotencia siempre: la entrega es “al menos una vez”. Graba en la base de datos que el correo del usuario 42 ya fue enviado y comprueba antes de enviarlo de nuevo.
UniqueeTaskIDevitan duplicar la tarea en la cola, pero no protegen contra la reejecución tras un crash. - Payload pequeño: envía IDs y rutas, no el archivo. La imagen se queda en el almacenamiento y la tarea solo lleva
uploads/foto-42.jpg. Un payload grande pesa en la memoria de Redis y en cada lectura. - Colas separadas por perfil: correo transaccional en
critical, procesamiento pesado enlow. Si el volumen lo justifica, ejecuta workers dedicados solo para la cola pesada (Queues: {"low": 1}) en otra máquina. - Error permanente sin reintento: payload inválido o formato no compatible nunca funcionará. Use
SkipRetryy deje la tarea en el archivo para su análisis. - Respete el contexto: pase el
ctxdel handler a HTTP, base de datos y SMTP. Es a través de él como llegan timeout, deadline y cancelación. - Redis con persistencia y contraseña: la cola vive en Redis. Active AOF o RDB, configure
requirepasso ACL y no lo exponga fuera de la red interna. No use la misma instancia como caché conmaxmemory-policyde vaciado, o Redis puede eliminar tareas. - Fije versiones: con la API todavía en
v0.x, lea las notas antes de cada actualización de Asynq.
Conclusión
Asynq resuelve bien el problema clásico de sacar trabajo de la petición: colas con prioridad, reintentos con backoff, programación, cron, deduplicación y apagado limpio, todo con un Redis o Valkey que probablemente ya tienes. La biblioteca sigue activa, con release en 2026 y commits recientes. Asynqmon funciona, pero está parado desde 2023, así que úsalo como panel interno y confía en Prometheus para alertas. Si algún día Asynqmon se rompe en una versión nueva de Asynq, la CLI y el x/metrics cubren lo esencial.