
Crea un Service de tipo LoadBalancer en un clúster Kubernetes en AWS o Google Cloud y, en segundos, obtiene una IP externa. Haz lo mismo en un clúster con servidores propios y el EXTERNAL-IP se queda en <pending> para siempre. Kubernetes no incluye un balanceador de carga de red para bare metal: las implementaciones que acompañan al proyecto solo hablan con las nubes. MetalLB rellena ese hueco. Distribuye IPs desde un pool que tú defines y anuncia esas IPs en la red con protocolos estándar, ARP/NDP o BGP. En esta guía entenderás cómo funciona, instalarás la versión 0.16.1, configurarás los modos Layer 2 y BGP, y resolverás los problemas más comunes. Todos los comandos se probaron en un laboratorio con kind y un router FRR.
El problema: LoadBalancer en
En un clúster bare metal sin MetalLB, el síntoma es este:
kubectl create deployment nginx --image=nginx:1.29 --replicas=2
kubectl expose deployment nginx --type=LoadBalancer --port=80
kubectl get svc nginx
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
nginx LoadBalancer 10.96.187.200 <pending> 80:32251/TCP 5sSin un balanceador, quedan dos salidas malas. NodePort expone el servicio en un puerto alto (30000 a 32767) en todos los nodos, y el cliente necesita saber la IP de un nodo que esté en pie. externalIPs depende de ti enrutar la IP manualmente hasta algún nodo. La documentación de MetalLB resume: esas opciones convierten al bare metal en ciudadano de segunda clase en Kubernetes.
Qué es MetalLB
O MetalLB es una implementación de balanceador de carga de red para clústeres Kubernetes bare metal, escrita en Go, bajo licencia Apache 2.0. El repositorio existe desde 2017, tiene alrededor de 8,4 mil estrellas y el proyecto es sandbox de la Cloud Native Computing Foundation. La API aún está marcada como beta, pero la propia documentación afirma que MetalLB es estable y confiable en producción. Si quieres entender de dónde viene el modelo de Services y controladores, consulta la historia de Kubernetes.
Hace dos cosas que trabajan juntas:
- Asignación de direcciones: el
controller, un Deployment único en el clúster, toma una IP libre de unIPAddressPooly la escribe en el Service. No inventa IPs: solo entrega las que tú pusiste en los pools, ya sean públicas alquiladas en tu centro de datos o privadas de tu LAN. - Anuncio externo: el
speaker, un DaemonSet que se ejecuta en cada nodo, hace que la red fuera del clúster sepa que esa IP “vive” en el clúster. En modo Layer 2 responde ARP (IPv4) y NDP (IPv6); en modo BGP establece sesiones con sus enrutadores y publica rutas.
Después de que el paquete llega al nodo, el trabajo de MetalLB termina. A partir de ahí, quien lo reenvía hasta el pod es el kube-proxy y el plugin de red (CNI) del cluster.
Requisitos
- Kubernetes 1.13 o más reciente, sin otro balanceador de red instalado.
- Un plugin de red compatible; la página de compatibilidad indica Cilium, Flannel, Antrea y Canal como compatibles, y Calico y kube-router como compatibles con reservas.
- Algunas direcciones IPv4 libres para que MetalLB las distribuya.
- En modo BGP, uno o más routers que hablen BGP.
- En modo Layer 2, el puerto 7946 TCP y UDP abierto entre los nodos, utilizado por memberlist para detectar nodos fuera de servicio.
En la nube pública, la mayoría de los proveedores no funcionan con MetalLB, porque la red virtual no acepta IPs anunciadas por la VM. La página de compatibilidad con nubes detalla cada caso. En OpenStack funciona, siempre que libere las IPs en la protección antispoofing del puerto.
Modo Layer 2: sencillo y universal
En el modo Layer 2, un único nodo del clúster es elegido “dueño” de cada IP de servicio. Cuando alguien en la red pregunta mediante ARP quién tiene esa IP, el speaker de ese nodo responde con la MAC de su propia interfaz. Para la LAN, parece simplemente que la máquina tiene varias IPs. Funciona en cualquier red Ethernet, sin equipo especial.
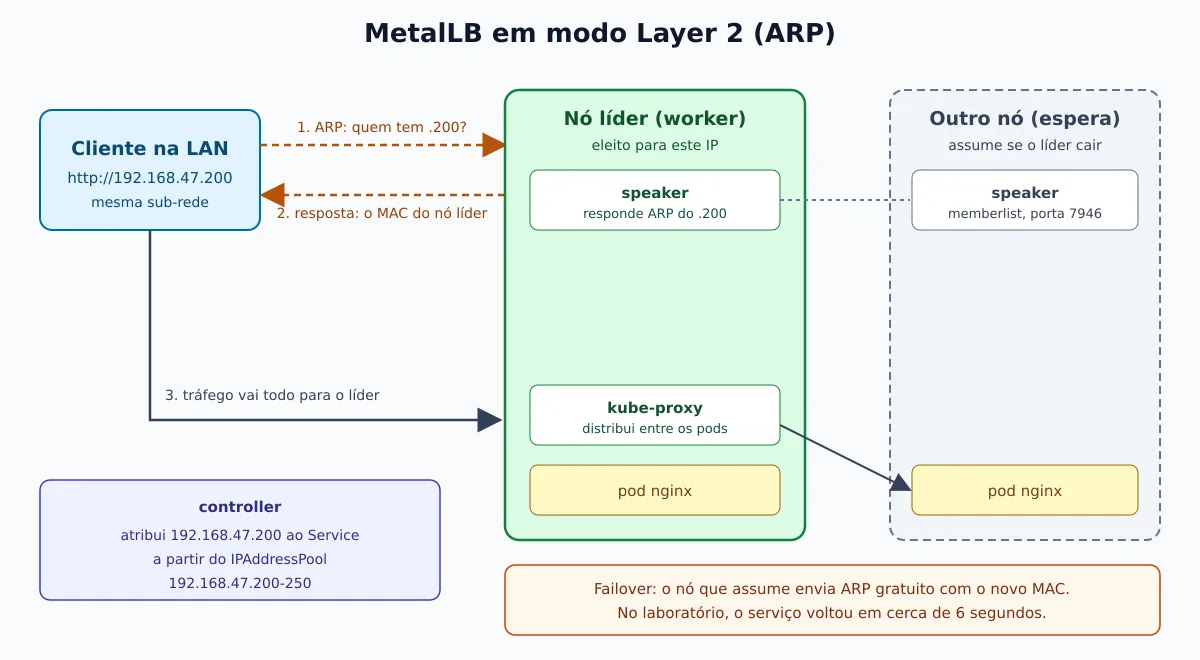
Esto tiene dos consecuencias que debes conocer:
- No es balanceo entre nodos. Todo el tráfico de una IP entra por un único nodo, y el ancho de banda de entrada queda limitado a la interfaz de este. Lo que ofrece el modo L2 es failover: si el líder cae, otro nodo asume la IP.
- El failover depende de los clientes. El nodo que asume envía paquetes ARP “gratuitos” indicando la nueva MAC. Los sistemas modernos (Linux, Windows, macOS) actualizan la caché al instante, y el cambio tarda unos pocos segundos. Equipos antiguos o con una implementación deficiente pueden tardar más.
La elección del líder no guarda estado: cada speaker calcula, para cada IP, una lista ordenada por el hash de “nodo + IP” entre los nodos elegibles, y quien esté en primero anuncia. Añadir un nodo solo cambia el líder si el nuevo nodo cae en la cima de la lista; quitar un nodo que no es líder no cambia nada.
Quien conozca Keepalived lo encontrará familiar: desde el punto de vista del cliente, la IP “salta” de una máquina a otra. La diferencia es que MetalLB no usa VRRP, sino memberlist. Por eso no existe el límite de 255 routers virtuales por red ni IDs de router virtual que configurar. A cambio, no habla con equipos VRRP de terceros.
Modo BGP: balanceo de verdad
En el modo BGP, cada nodo cierra una sesión BGP con los routers de su red y anuncia la IP de cada servicio como una ruta /32. Si el router está configurado para múltiples rutas (ECMP), trata todos los nodos como próximos saltos equivalentes y reparte las conexiones entre ellos.
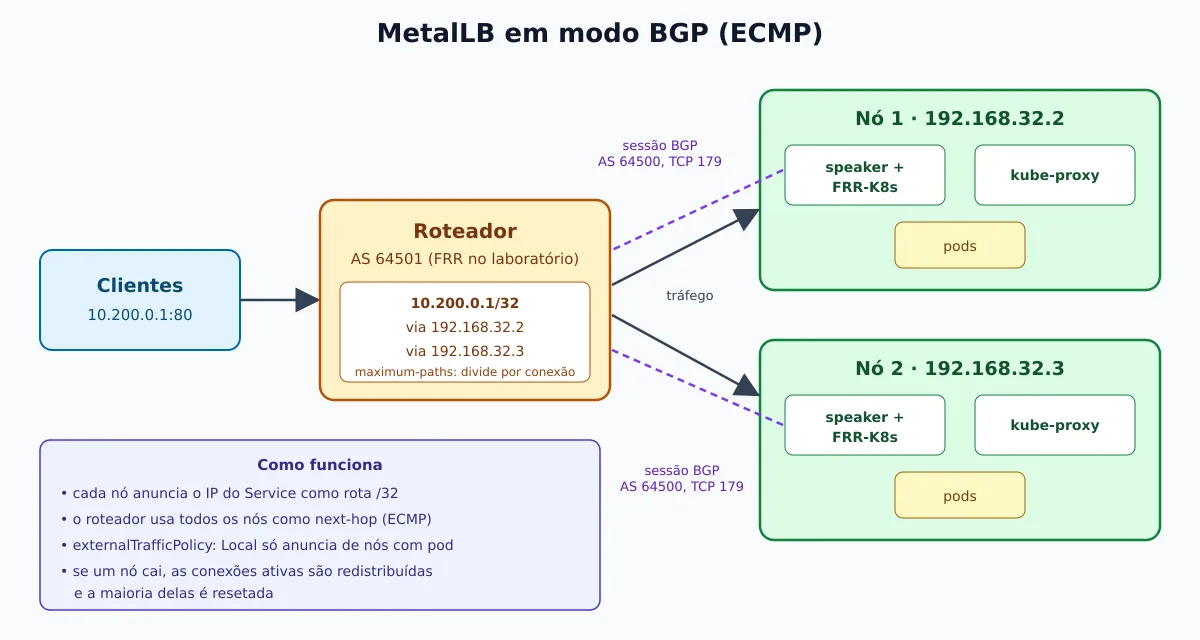
El reparto es por conexión, con hash de campos del paquete: todos los paquetes de una conexión TCP van al mismo nodo. El hash de 5 campos (protocolo, IPs y puertos de origen y destino) reparte mejor que el de 3, porque separa conexiones distintas del mismo cliente.
La limitación principal: cuando el conjunto de nodos cambia, por ejemplo porque un nodo cayó, el router recalcula el hash y la mayoría de las conexiones activas acabarán en otro nodo, que no conoce esa conexión. El cliente recibe connection reset. Es un corte único, no una pérdida continua. Para suavizarlo, la documentación sugiere ECMP “resiliente” en el router, dejar un Ingress Controller entre el BGP y los servicios, y hacer cambios en horarios de poco tráfico.
Los tres backends de BGP
MetalLB tiene tres implementaciones de BGP, y la v0.16.0, de 20 de mayo de 2026, cambió cuál de ellas es la predeterminada:
- FRR-K8s (predeterminado y recomendado): utiliza FRR mediante el FRR-K8s, que se ejecuta como su propio DaemonSet. Incluye BFD, BGP sobre IPv6 y permite añadir configuración FRR adicional a las mismas sesiones. Las nuevas funcionalidades de BGP solo entran aquí.
- Nativo: implementación propia, más ligera, sin BFD y sin BGP sobre IPv6. Adecuado para quienes solo usan Layer 2 o BGP sencillo.
- FRR (obsoleto): configura FRR directamente, sin la capa FRR-K8s. Se eliminará en una versión futura.
Laboratorio: kind con tres nodos
Para reproducir todo sin tocar producción, utilizamos el kind, que levanta nodos Kubernetes como contenedores Docker. Las versiones de la prueba fueron kind 0.33.0, Kubernetes 1.37.0 y MetalLB 0.16.1.
cat > kind.yaml <<'EOF'
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: metallb-lab
nodes:
- role: control-plane
- role: worker
- role: worker
EOF
kind create cluster --config kind.yaml
docker network inspect kind -f '{{range .IPAM.Config}}{{.Subnet}} {{end}}'
El último comando muestra la subred de la red kind en Docker, que hace el papel de tu LAN. En nuestro caso fue 192.168.32.0/20, y reservamos el tramo 192.168.47.200-192.168.47.250 para MetalLB. En tu red real, elige un rango fuera del DHCP y que ningún equipo use.
Trampa de kind: si algún pod entra en CrashLoopBackOff con too many open files en el log, el problema es el límite de inotify del host, no MetalLB. Auméntalo con sudo sysctl fs.inotify.max_user_instances=512, como recomienda la documentación de kind. Ocurrió en nuestra prueba con tres nodos en un host que ya ejecutaba varios contenedores.
Instalación
Preparación: kube-proxy en modo IPVS
Si tu kube-proxy se ejecuta en modo IPVS, activa el strictARP; sin él, los nodos responden ARP de IPs que no deberían. En modo iptables (el predeterminado de kubeadm y kind), salta este paso.
kubectl get configmap kube-proxy -n kube-system -o yaml | \
  sed -e "s/strictARP: false/strictARP: true/" | \
  kubectl apply -f - -n kube-system
Por manifiesto
El manifiesto recomendado incluye el backend FRR-K8s:
kubectl apply -f https://raw.githubusercontent.com/metallb/metallb/v0.16.1/config/manifests/metallb-frr-k8s.yaml
kubectl wait -n metallb-system --for=condition=ready pod --all --timeout=240s
kubectl get pods -n metallb-system
NAME READY STATUS RESTARTS AGE
controller-75db68c68f-69tsz 1/1 Running 0 2m
frr-k8s-daemon-fvd4w 5/5 Running 0 2m
frr-k8s-daemon-rdc2p 5/5 Running 0 2m
frr-k8s-statuscleaner-867ddf64df-h9rzt 1/1 Running 0 2m
speaker-kqhsl 1/1 Running 0 2m
speaker-mk2jq 1/1 Running 0 2mPara una instalación más ligera, sin FRR, cambie por metallb-native.yaml en la misma URL. El manifiesto ya crea el namespace metallb-system con las etiquetas pod-security.kubernetes.io/*: privileged, necesarias porque el speaker necesita privilegios de red. Recién instalado, MetalLB permanece inactivo: no ocurre nada hasta que crees la configuración.
Por Helm
kubectl create namespace metallb-system
kubectl label namespace metallb-system \
  pod-security.kubernetes.io/enforce=privileged \
  pod-security.kubernetes.io/audit=privileged \
  pod-security.kubernetes.io/warn=privileged
helm repo add metallb https://metallb.github.io/metallb
helm install metallb metallb/metallb --namespace metallb-system
El chart 0.16.1 también instala FRR-K8s por defecto. Para usar el backend nativo, pase --set speaker.frr.enabled=false --set frrk8s.enabled=false. Con Helm, los recursos de configuración deben estar en el mismo namespace en el que se instaló MetalLB.
Quien viene de versiones antiguas: hasta la v0.12 la configuración era un ConfigMap. Desde la v0.13 solo existen los recursos personalizados (CRDs) mostrados a continuación, y hay una herramienta de conversión.
Configurando el modo Layer 2
Son dos recursos: el pool de direcciones y el anuncio en Layer 2 que apunta a él.
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: lan
  namespace: metallb-system
spec:
  addresses:
  - 192.168.47.200-192.168.47.250
---
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: lan
  namespace: metallb-system
spec:
  ipAddressPools:
  - lan
Las direcciones aceptan rangos (inicio-fim), CIDR (192.168.10.0/24) e IPv6, y puedes tener tantos pools como quieras. Un L2Advertisement sin ipAddressPools vale para todos los pools. Sin ningún L2Advertisement, la IP se asigna pero no se anuncia, y el servicio no responde; es el error más común de quienes vienen de las versiones con ConfigMap.
kubectl apply -f l2.yaml
kubectl get svc nginx
curl -s -o /dev/null -w '%{http_code}\n' http://192.168.47.200/
kubectl describe svc nginx | sed -n '/Events/,$p'
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
nginx LoadBalancer 10.96.187.200 192.168.47.200 80:32251/TCP 4m45s
200
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal IPAllocated 5s metallb-controller Assigned IP ["192.168.47.200"]
Normal nodeAssigned 5s metallb-speaker announcing from node "metallb-lab-worker2" with protocol "layer2"El Service que estaba en <pending> obtuvo la IP al instante. Los eventos muestran las dos etapas: el controller asignó la IP y el speaker del worker2 pasó a anunciarla. Para ver qué nodo anuncia cada servicio sin leer eventos:
kubectl get servicel2statuses -n metallb-systemNAME ALLOCATED NODE SERVICE NAME SERVICE NAMESPACE
l2-vc27l metallb-lab-worker2 nginx defaultProbando el failover
En el laboratorio, tumbamos el nodo líder con docker stop mientras un bucle de curl golpeaba la IP cada medio segundo. El servicio volvió a responder en unos 6,3 segundos, y la tabla ARP del host cambió sola a la MAC del otro worker:
ip neigh show 192.168.47.200# antes: MAC do worker2
192.168.47.200 dev br-a312a0b87cf9 lladdr a2:7a:02:df:0c:57 REACHABLE
# depois: MAC do worker
192.168.47.200 dev br-a312a0b87cf9 lladdr c2:00:6c:c6:41:63 DELAYUn detalle de prueba: docker pause no sirve para simular la caída, porque el kernel del nodo pausado sigue reenviando paquetes y el servicio ni se inmuta. Utiliza docker stop, o apaga la máquina de verdad.
Limitando nodos, interfaces y servicios
Por defecto, cualquier nodo con speaker puede ser elegido, y el anuncio sale por todas las interfaces. Cuando solo algunos nodos están conectados a una red, restringe:
apiVersion: metallb.io/v1beta1
kind: L2Advertisement
metadata:
  name: dmz
  namespace: metallb-system
spec:
  ipAddressPools:
  - dmz
  nodeSelectors:
  - matchLabels:
      rede: dmz
  interfaces:
  - eth1
  serviceSelectors:
  - matchLabels:
      tier: frontend
serviceSelectors llegó en la v0.16.0 y limita el anuncio a los Services con esas etiquetas. Cuidado con interfaces: no influye en la elección del líder. Si el nodo elegido no tiene la interfaz, el servicio no se anuncia; combina siempre con nodeSelectors.
Configurando el modo BGP
Para la prueba de BGP, recreamos el clúster con dos nodos (el control-plane, 192.168.32.2, y un worker, 192.168.32.3) y levantamos un enrutador FRR 10.7.1 en contenedor, en la misma red de kind, con el AS 64501 :
docker run -d --name metallb-lab-router --network kind --ip 192.168.40.10 \
  --privileged -v "$PWD/router:/etc/frr" quay.io/frrouting/frr:10.7.1
En el directorio router/ se encuentra el archivo daemons, con bgpd=yes, y el frr.conf con la configuración del router:
router bgp 64501
 bgp router-id 192.168.40.10
 no bgp ebgp-requires-policy
 neighbor 192.168.32.2 remote-as 64500
 neighbor 192.168.32.3 remote-as 64500
 !
 address-family ipv4 unicast
  maximum-paths 8
 exit-address-family
maximum-paths es lo que activa ECMP: sin él, el router elige un único nodo. no bgp ebgp-requires-policy es necesario en FRR para aceptar rutas eBGP sin una política explícita; en un router de producción, es preferible utilizar filtros de prefijo que acepten solo su pool.
En el lado de MetalLB, son tres recursos: el par BGP, el pool y el anuncio.
apiVersion: metallb.io/v1beta2
kind: BGPPeer
metadata:
  name: roteador
  namespace: metallb-system
spec:
  myASN: 64500
  peerASN: 64501
  peerAddress: 192.168.40.10
---
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: bgp
  namespace: metallb-system
spec:
  addresses:
  - 10.200.0.0/24
  avoidBuggyIPs: true
---
apiVersion: metallb.io/v1beta1
kind: BGPAdvertisement
metadata:
  name: bgp
  namespace: metallb-system
spec:
  ipAddressPools:
  - bgp
Utilice metallb.io/v1beta2 no BGPPeer; el v1beta1 está obsoleto. El avoidBuggyIPs no está ahí por casualidad: sin él, el primer Service de nuestra prueba recibió 10.200.0.0, y algunos equipos antiguos descartan direcciones terminadas en .0 e .255. Con la opción activada, el Service empezó a recibir 10.200.0.1.
En el router, las sesiones suben y la ruta aparece con dos próximos saltos:
docker exec metallb-lab-router vtysh -c "show bgp summary"
docker exec metallb-lab-router vtysh -c "show ip route bgp"
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt
192.168.32.2 4 64500 4 6 1 0 0 00:00:15 1 1
192.168.32.3 4 64500 7 6 1 0 0 00:00:15 1 1
B>* 10.200.0.1/32 [20/0] via 192.168.32.2, eth0, weight 1, 00:00:09
* via 192.168.32.3, eth0, weight 1, 00:00:09Para ver lo que cada nodo pretende anunciar, sin entrar en el router:
kubectl get servicebgpstatuses -n metallb-systemBFD para detectar fallos más rápido
El BGP por sí solo puede tardar decenas de segundos en darse cuenta de que un vecino está muerto. En los backends de FRR, se puede acoplar una sesión BFD al par:
apiVersion: metallb.io/v1beta1
kind: BFDProfile
metadata:
  name: rapido
  namespace: metallb-system
spec:
  receiveInterval: 380
  transmitInterval: 270
---
apiVersion: metallb.io/v1beta2
kind: BGPPeer
metadata:
  name: roteador
  namespace: metallb-system
spec:
  myASN: 64500
  peerASN: 64501
  peerAddress: 192.168.40.10
  bfdProfile: rapido
El router también necesita tener BFD activo para ese vecino. El BGPPeer acepta también contraseña de la sesión (password o passwordSecret), ebgpMultiHop, VRF y graceful restart, y la configuración avanzada de BGP muestra agregación de rutas, local preference y comunidades. Y un mismo pool puede ser anunciado por L2 y BGP al mismo tiempo: basta con un L2Advertisement y un BGPAdvertisement apuntando a él.
Usando en los Services
Con MetalLB configurado, basta type: LoadBalancer. Las anotaciones siguientes ofrecen un control preciso; todas se probaron en el laboratorio.
IP fija
apiVersion: v1
kind: Service
metadata:
  name: nginx-fixo
  annotations:
    metallb.io/loadBalancerIPs: 192.168.47.210
spec:
  type: LoadBalancer
  selector:
    app: nginx
  ports:
  - port: 80
El campo spec.loadBalancerIP también funciona, pero está obsoleto en Kubernetes y no acepta dos IP. La anotación acepta una lista separada por comas, necesaria para servicios dual stack. Si la IP no pertenece a ningún pool, o ya está en uso, el Service queda en <pending> y el motivo aparece en kubectl describe svc.
Pool específico e IPs “caros”
Un escenario habitual: un pool grande de IP privadas y pocas IP públicas alquiladas. Marca el pool caro con autoAssign: false, y solo lo usará quien lo pida explícitamente:
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: publico
  namespace: metallb-system
spec:
  addresses:
  - 203.0.113.10/32
  autoAssign: false
---
apiVersion: v1
kind: Service
metadata:
  name: site
  annotations:
    metallb.io/address-pool: publico
spec:
  type: LoadBalancer
  selector:
    app: site
  ports:
  - port: 443
Recuerda incluir el pool en un L2Advertisement o BGPAdvertisement. En nuestra prueba, un pool olvidado fuera del anuncio entregó la IP al Service, pero el curl falló y el ARP quedó INCOMPLETE en el host. Para entornos con varios equipos, el pool también acepta serviceAllocation, que lo restringe a namespaces o Services por etiqueta y define prioridad entre pools.
Compartiendo una IP entre Services
Por defecto, cada Service obtiene su IP. Para colocar dos Services en la misma dirección, por ejemplo DNS en TCP y UDP o aplicaciones en puertos diferentes, usa la misma clave de compartición:
apiVersion: v1
kind: Service
metadata:
  name: web-http
  annotations:
    metallb.io/allow-shared-ip: "web"
    metallb.io/loadBalancerIPs: 192.168.47.220
spec:
  type: LoadBalancer
  selector:
    app: nginx
  ports:
  - port: 80
---
apiVersion: v1
kind: Service
metadata:
  name: web-alt
  annotations:
    metallb.io/allow-shared-ip: "web"
    metallb.io/loadBalancerIPs: 192.168.47.220
spec:
  type: LoadBalancer
  selector:
    app: nginx
  ports:
  - port: 8080
    targetPort: 80
Las condiciones: misma clave, puertos diferentes, y ambos con externalTrafficPolicy: Cluster (o exactamente el mismo selector de pods). En el laboratorio, 192.168.47.220:80 e 192.168.47.220:8080 respondieron ambos.
externalTrafficPolicy: Cluster o Local
Esta opción del Service cambia el comportamiento de MetalLB:
- Cluster (por defecto): el nodo que recibe el tráfico lo reenvía a cualquier pod del servicio, incluso en otro nodo. La distribución entre pods es uniforme, pero el pod ve como origen la IP del nodo, no la del cliente.
- Local: el tráfico solo va a pods del propio nodo, y el pod ve la IP real del cliente. En BGP, solo los nodos que tienen pods anuncian la ruta. En L2, solo los nodos con pods pueden ser elegidos.
En la prueba con BGP, con los dos pods en el mismo worker, bastó cambiar a Local y la ruta se redujo a un único salto siguiente:
kubectl patch svc web -p '{"spec":{"externalTrafficPolicy":"Local"}}'
docker exec metallb-lab-router vtysh -c "show ip route bgp"
B>* 10.200.0.1/32 [20/0] via 192.168.32.3, eth0, weight 1, 00:00:04El coste de Local en BGP es el desequilibrio: el router divide por nodo, no por pod. Con dos pods en el nodo A y uno en el nodo B, cada pod del nodo A recibe 25% del tráfico y el del nodo B recibe 50%. Usa anti-affinity para repartir los pods uno por nodo.
Troubleshooting
A página de troubleshooting parte de una división sencilla: si el Service no obtiene IP, el problema está en el controller; si obtiene IP pero no responde, está en los speakers (o en la red). Los comandos que más usamos:
kubectl describe svc <servico>                           # eventos IPAllocated e nodeAssigned
kubectl logs -n metallb-system deploy/controller           # atribuição de IPs
kubectl logs -n metallb-system -l component=speaker        # anúncios
kubectl get servicel2statuses,servicebgpstatuses -n metallb-system
kubectl get configurationstates -n metallb-system          # configuração válida por componente
Configuración inválida
Los webhooks rechazan buena parte de los errores en el momento. En el laboratorio, un segundo pool con el mismo rango fue bloqueado:
admission webhook "ipaddresspoolvalidationwebhook.metallb.io" denied the request:
CIDR "10.200.0.0/24" in pool "errado" overlaps with already defined CIDR "10.200.0.0/24"
No todo lo detecta el webhook, porque la configuración es la suma de varios recursos. Cuando la suma no es válida, MetalLB ignora el cambio y continúa con la última configuración válida. El recurso ConfigurationState, desde la v0.15.3, muestra el resultado por componente, y los logs traen failed to parse the configuration.
El plano de control no anuncia
Los nodos con la etiqueta node.kubernetes.io/exclude-from-external-load-balancers se ignoran, y kubeadm y kind ponen esa etiqueta en el control-plane. En nuestra prueba de BGP, el control-plane cerró la sesión pero envió cero prefijos, y el log del speaker decía exactamente el motivo:
"event":"skipping should announce bgp","ips":["10.200.0.0"],"protocol":"bgp",
"reason":"speaker's node has labeled 'node.kubernetes.io/exclude-from-external-load-balancers'"
En un cluster de un solo nodo o cuando realmente quieres anunciar desde el control-plane, quita la etiqueta (kubectl label node <no> node.kubernetes.io/exclude-from-external-load-balancers-) o pasa --ignore-exclude-lb a los speakers.
Anuncia pero no responde
- No pruebe con ping. La IP del servicio no responde ICMP; pruebe el puerto de la aplicación.
- Probar desde dentro de un nodo no demuestra nada. Un nodo alcanza la IP a través del CNI aunque el anuncio esté roto. Pruebe desde una máquina fuera del clúster.
- En L2, use
arpingde un host en la misma subred:arping -I eth0 192.168.47.200debe mostrar una única MAC, la del nodo líder. Dos MACs indican dos speakers peleando, una IP duplicada en la red o el CNI respondiendo ARP. Ninguna respuesta suele ser protección antispoofing de MAC en el switch o en el hipervisor; confírmelo contcpdump -n -i eth0 arpen el nodo elegido. - Wi-Fi: algunos dispositivos, como la Raspberry Pi, dejan de responder ARP por la interfaz inalámbrica. El contorno citado en la documentación es el modo promiscuo (
ip link set wlan0 promisc on). - En BGP, compruebe la sesión y la ruta:
vtysh -c "show bgp neighbor"en el router o en el contenedor FRR del nodo, y la métricafrrk8s_bgp_session_up. - Retorno asimétrico: si el cliente está en otra subred y el paquete entra por una interfaz que no es la del gateway por defecto, el
rp_filterde Linux descarta la respuesta. Resuélvelo con rutas estáticas en los nodos o enrutamiento por origen.
Para abrir un bug, la documentación pide los logs a nivel debug y el resultado del script collect.sh, que reúne logs y recursos. Las imágenes de MetalLB no tienen shell; para depurar dentro del pod, usa kubectl debug con un contenedor efímero.
Monitorización y actualización
MetalLB y FRR-K8s exponen métricas Prometheus. Desde la v0.16.0, el endpoint es solo HTTPS, con certificado autofirmado o proporcionado por ti, y el chart 0.16.1 corrigió las anotaciones de recolección para ese esquema. Las más útiles son frrk8s_bgp_session_up para las sesiones BGP y metallb_k8s_client_config_stale_bool para configuración detenida. La guía de monitorización con Prometheus muestra cómo recolectar y alertar; y el Go Uptime puede vigilar la IP del servicio desde fuera del clúster, que es la prueba que realmente importa.
Para actualizar, lee las notas de la versión y reaplica el manifiesto de la nueva versión o ejecuta helm upgrade; el chart actualiza los CRDs por sí solo. Atención a quien instaló con Helm con los valores por defecto antes de 0.16: el backend pasó de FRR a FRR-K8s, lo que cambia la topología de los pods y el prefijo de las métricas de metallb_ para frrk8s_. Para mantener el FRR antiguo durante la transición, fija speaker.frr.enabled=true e frrk8s.enabled=false. Y recuerde las limitaciones del failover: en L2 la IP cambia de nodo, en BGP las conexiones activas se reinician; realice la actualización en horario de poco tráfico.
Para desmontar el laboratorio: kind delete cluster --name metallb-lab e docker rm -f metallb-lab-router.
¿L2 o BGP?
- Layer 2 si tiene una LAN sencilla, no controla el router o quiere resolverlo en cinco minutos. Acepte que un nodo recibe todo el tráfico de cada IP y que el failover tarda unos segundos.
- BGP si tiene routers con BGP y necesita equilibrio real entre nodos, más ancho de banda del que admite una interfaz, o ya opera una red enrutada en el centro de datos. Planifique los cambios de nodo debido a los reinicios.
MetalLB realiza una tarea pequeña y bien definida: asignar una IP al Service y llevar el tráfico hasta algún nodo. Esto basta para sacar al bare metal de la condición de segunda clase, y es la base sobre la cual se coloca un Ingress Controller, una Gateway API o los propios servicios TCP y UDP. El código y la documentación completa están en metallb.io.