
Trocar de Claude Code para Codex, OpenCode, Cursor ou Grok no meio de uma tarefa normalmente custa contexto: é preciso explicar de novo a arquitetura, as tentativas que falharam e o próximo passo. O ai-memory resolve esse problema com memória persistente compartilhada entre agentes. Este guia instala a versão nativa no Linux, cria um serviço systemd --user, liga MCP e hooks nos clientes suportados e mostra onde os dados ficam. A versão 2.0 também tornou a memória mais portátil e preparada para uso concorrente.
OK. Esta versão corrige o atualizador nativo e acrescenta perfil entre projetos, backup das configurações dos agentes e novos controles de handoff.O que o ai-memory guarda — e o que não guarda
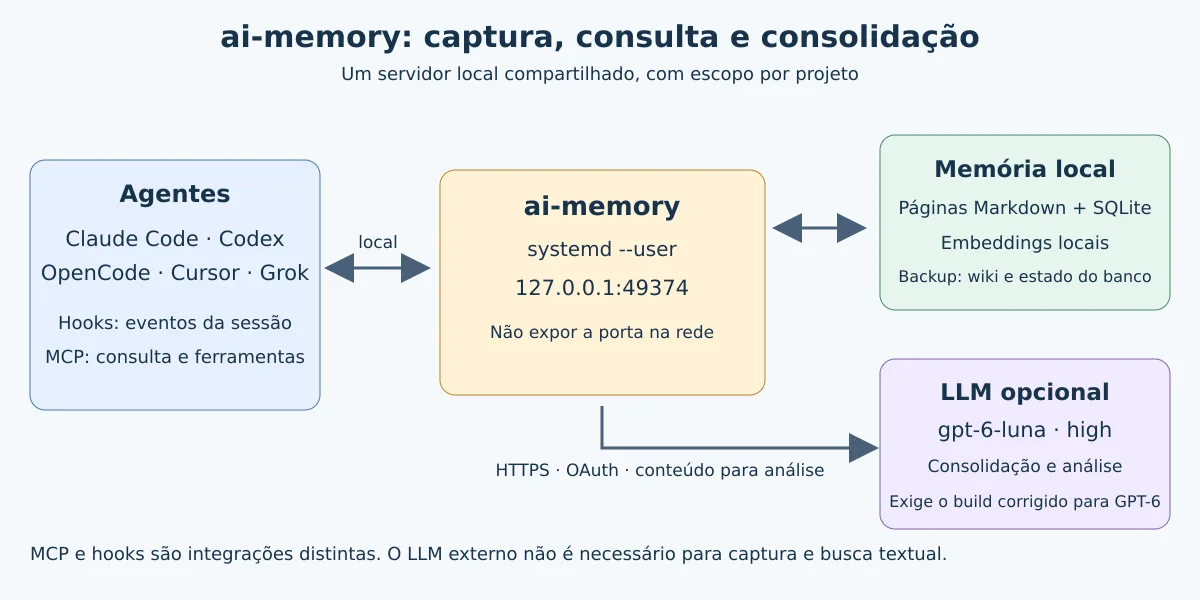
O ai-memory é um servidor de memória de longo prazo para agentes de programação. Os hooks registram eventos da sessão; o servidor consolida esse material em páginas Markdown e permite recuperar contexto e handoffs pelo MCP. A fonte de verdade é uma wiki em arquivos .md; o SQLite é um índice derivado. Isso torna a memória inspecionável, versionável e recuperável sem depender de um banco vetorial opaco.
O caminho padrão não exige chave de API nem chamadas a LLM: captura, busca textual e handoff continuam disponíveis. Na primeira execução do servidor, o ai-memory baixa o modelo local all-MiniLM-L6-v2 para embeddings; ele não precisa de chave de API. Uma LLM é opcional para recursos de consolidação e recuperação. Para desligar embeddings locais, defina embedding_provider = "none" na configuração. Antes de ativar hooks, avalie o que pode entrar no histórico do projeto. Para áreas sensíveis, use uma política de captura e mantenha a instância apenas no loopback.
O que mudou na linha 2.x
O anúncio da ai-memory 2.0 ajuda a entender por que este não é apenas um gerenciador de resumos. A wiki passou a usar o Open Knowledge Format (OKF): páginas Markdown com metadados padronizados. Em outras palavras, a memória continua legível fora do servidor — você pode inspecioná-la, versioná-la no Git ou levá-la para outra ferramenta compatível.
Ao migrar uma instalação 1.x, a 2.0 cria e verifica um backup do diretório de dados antes de alterar o formato. Não descarte esse backup até conferir a wiki e as consultas após a atualização. Os embeddings locais continuam sendo o caminho padrão: não exigem chave de API nem enviam o conteúdo da memória a um provedor externo.
A outra mudança prática é a concorrência. Claude Code, Codex, OpenCode e outros harnesses podem trabalhar no mesmo checkout sem compartilhar um ponteiro global de “projeto atual”. As escritas passam por uma fila única e páginas recebem versões, para que uma atualização posterior não apague silenciosamente a anterior. Em uma instalação compartilhada, as páginas podem servir ao time inteiro; handoffs, porém, continuam pessoais e só podem ser aceitos uma vez pelo dono da sessão.
Isso não significa que uma conversa já aberta seja interrompida para receber uma anotação nova: ela a verá na próxima consulta ou numa sessão seguinte. Para equipes, mantenha autenticação e HTTPS antes de expor o serviço fora da máquina local.
Novidades práticas da versão 2.6.0
Além das correções, o changelog da 2.6.0 traz mudanças úteis para quem alterna entre agentes e repositórios:
- Perfil entre projetos: reúne preferências recorrentes e as apresenta como contexto no início das sessões. Fica ativo por padrão em servidor de um único operador; em ambiente multiusuário, exige ativação. Memória recuperada é dado não confiável: não pode autorizar ações nem contrariar instruções atuais ou regras do repositório.
- Backup dos agentes:
backup-agentserestore-agentscuidam de configurações, skills, plugins e instruções, separadamente do backup da base de memória. A restauração é simulação por padrão. - Handoffs configuráveis: é possível deixar de consumir automaticamente um handoff ao abrir uma sessão e de criar handoffs automáticos ao encerrá-la.
- Execução com servidor indisponível:
ai-memory runagora pode iniciar o agente com um aviso, sem os recursos online do workstream. Use--require-serverse preferir abortar quando a memória estiver inacessível. - Integrações e diagnóstico: GitHub Copilot CLI ganha instalação de MCP e hooks;
list-projectslista os escopos conhecidos edoctormostra a resolução do projeto. Claude Code também pode receber hooks limitados ao checkout com--scope project.
O novo companion ai-memory-wikisync exporta famílias de páginas explicitamente permitidas para um diretório do repositório. É uma exportação unidirecional nesta etapa: não faz sincronização bidirecional, não apaga arquivos e não executa Git. Ele não é necessário para seguir este tutorial.
Pré-requisitos e escolha da instalação
O projeto oferece binários Linux para x86_64 e aarch64. A alternativa recomendada pelo próprio projeto para instalações nativas é mise use -g github:akitaonrails/ai-memory; abaixo usaremos o tarball da release para deixar versão, checksum, binário e hooks explícitos.
Não use cargo install ai-memory: esse nome já pertence a outro crate no crates.io. Para compilar, use o workspace do repositório; para operar normalmente, prefira um binário da release v2.6.0. No Fedora, a release também publica RPMs para x86_64 e aarch64, instaláveis com sudo dnf install ./ai-memory-2.6.0-1.<arq>.rpm; o pacote traz os arquivos de serviço systemd do projeto. Este guia segue com o tarball Linux; confira a arquitetura suportada e valide o executável na sua distribuição.
command -v curl sha256sum tar systemctl
uname -m
mkdir -p ~/.local/bin ~/.config/ai-memory ~/.local/share/ai-memory ~/.config/systemd/user
Baixando e verificando o binário nativo
Baixe sempre o arquivo .sha256 publicado junto ao tarball e interrompa a instalação se a soma não conferir. O bloco abaixo seleciona a arquitetura, usa a release v2.6.0 e preserva os hooks que vêm no pacote.
set -euo pipefail

VER=2.6.0
case "$(uname -m)" in
  x86_64)  ARQ=ai-memory-linux-x86_64.tar.gz ;;
  aarch64|arm64) ARQ=ai-memory-linux-aarch64.tar.gz ;;
  *) echo "Arquitetura sem binário publicado: $(uname -m)" >&2; exit 1 ;;
esac

BASE="https://github.com/akitaonrails/ai-memory/releases/download/v${VER}"
TMP=$(mktemp -d)
trap 'rm -rf "$TMP"' EXIT

curl -fL "$BASE/$ARQ" -o "$TMP/$ARQ"
curl -fL "$BASE/$ARQ.sha256" -o "$TMP/$ARQ.sha256"
(
  cd "$TMP"
  sha256sum -c "$ARQ.sha256"
  mkdir release
  tar -xzf "$ARQ" -C release
)

install -m 0755 "$TMP/release/ai-memory" "$HOME/.local/bin/ai-memory.new"
mv -f "$HOME/.local/bin/ai-memory.new" "$HOME/.local/bin/ai-memory"
install -d "$HOME/.local/share/ai-memory/release-$VER"
cp -a "$TMP/release/hooks" "$HOME/.local/share/ai-memory/release-$VER/"

export PATH="$HOME/.local/bin:$PATH"
ai-memory --version
Se ai-memory não aparecer em um terminal novo, acrescente export PATH="$HOME/.local/bin:$PATH" ao arquivo de inicialização do shell, como ~/.bashrc ou ~/.zshrc.
Inicializando a base local
Vamos manter a configuração em ~/.config/ai-memory/config.toml e os dados em ~/.local/share/ai-memory, o padrão esperado em uma instalação de usuário no Linux.
ai-memory \
  --data-dir "$HOME/.local/share/ai-memory" \
  --config "$HOME/.config/ai-memory/config.toml" \
  init
Após o primeiro uso, a wiki fica em ~/.local/share/ai-memory/wiki/, o índice SQLite em ~/.local/share/ai-memory/db/memory.sqlite e os modelos locais em ~/.local/share/ai-memory/models/. A wiki é a fonte de verdade das páginas, mas sessões, observações, handoffs e auditoria também vivem no banco. Para uma cópia completa, use o comando de backup do próprio ai-memory:
mkdir -p "$HOME/backups/ai-memory"
ai-memory backup --to "$HOME/backups/ai-memory/ai-memory-$(date +%Y%m%d-%H%M).tar.gz"
Subindo o servidor com systemd do usuário
O servidor MCP precisa ficar rodando para que os CLIs e hooks falem com ele. Este serviço de usuário escuta somente em 127.0.0.1:49374: não publique essa porta na rede.
cat > ~/.config/systemd/user/ai-memory.service <<'UNIT'
[Unit]
Description=ai-memory local MCP and lifecycle server
After=network.target

[Service]
Type=simple
WorkingDirectory=%h
ExecStart=%h/.local/bin/ai-memory --data-dir %h/.local/share/ai-memory --config %h/.config/ai-memory/config.toml serve --transport http --bind 127.0.0.1:49374 --enable-web
Restart=on-failure
RestartSec=5
NoNewPrivileges=true
PrivateTmp=true

[Install]
WantedBy=default.target
UNIT

systemctl --user daemon-reload
systemctl --user enable --now ai-memory.service
systemctl --user status ai-memory.service --no-pager
Em uma máquina que deve manter o serviço ativo mesmo sem login gráfico, habilite linger uma única vez:
loginctl enable-linger "$USER"Confira o processo e os logs quando algo não responder:
systemctl --user is-active ai-memory.service
journalctl --user -u ai-memory.service -n 80 --no-pager
ai-memory status
Usando ChatGPT/Codex como provedor LLM
Sem provedor, o ai-memory continua capturando sessões, buscando na wiki e criando resumos determinísticos. Um LLM acrescenta consolidação mais rica, lint e melhorias em segundo plano. Para usar a assinatura ChatGPT Plus, Pro ou Codex, selecione openai-oauth: ele usa o backend ChatGPT/Codex por OAuth, não precisa de OPENAI_API_KEY e guarda o token renovável em ~/.local/share/ai-memory/auth.json.
Atualização de 23/09/2026: a configuração usada neste ambiente passou para gpt-6-luna com effort high. É uma escolha operacional para as sessões técnicas deste laboratório, não o padrão do modelo nem uma garantia de resumos melhores. O teste de chamada respondeu OK; avalie a qualidade das consolidações e a latência no seu uso.
Compatibilidade: a release 2.4.0 enviava temperature para modelos GPT-6 e recebia 400 Unsupported parameter: temperature, o que quebrava consolidação e lint. A correção da PR #852 saiu oficialmente na 2.4.1, nos provedores codex, openai-oauth, copilot e openai. Com o tarball 2.6.0 deste guia, não é mais preciso compilar um snapshot da main: basta conferir que ai-memory --version mostra 2.4.1 ou mais novo antes de trocar o modelo.
Modelo e effort no drop-in do systemd
Com o binário 2.4.1 ou mais novo instalado, ajuste o arquivo abaixo. Em uma configuração já existente, altere somente as linhas de modelo e effort; preserve os demais parâmetros. Para uma instalação nova:
mkdir -p ~/.config/systemd/user/ai-memory.service.d

cat > ~/.config/systemd/user/ai-memory.service.d/llm-openai-oauth.conf <<'EOF'
[Service]
Environment=AI_MEMORY_LLM_PROVIDER=openai-oauth
Environment=AI_MEMORY_LLM_MODEL=gpt-6-luna
Environment=AI_MEMORY_LLM_REASONING_EFFORT=high
Environment=AI_MEMORY_CONSOLIDATE_ON_SESSION_END=true
EOF

systemctl --user daemon-reload
systemctl --user restart ai-memory.service
ai-memory status
O último parâmetro agenda a consolidação com LLM depois de um encerramento de sessão. O serviço usa as variáveis do systemd; elas não são automaticamente exportadas para o seu terminal. A documentação oficial do GPT-6 Luna lista none, low, medium (padrão), high, xhigh e max. A disponibilidade na API não garante a mesma seleção em todo cliente OAuth: neste ambiente, verificamos chamadas com medium e high.
Qual effort escolher para o ai-memory?
Effort orienta quanto raciocínio o modelo dedica à tarefa. Níveis maiores podem aumentar tokens e latência; não garantem ganho em toda sessão. Este guia usa high por escolha do ambiente, mas medium continua sendo o padrão documentado do modelo.
| Effort | Como avaliar |
|---|---|
none |
Sem raciocínio adicional; consta na API oficial, mas não foi validado aqui via OAuth. |
low |
Priorize velocidade em tarefas simples e bem delimitadas. |
medium |
Padrão do modelo; ponto de comparação para qualidade e latência. |
high |
Configuração adotada neste ambiente para dar mais espaço ao raciocínio. |
xhigh e max |
Avalie em tarefas difíceis, medindo se o ganho compensa o uso adicional. |
Para voltar a medium, edite AI_MEMORY_LLM_REASONING_EFFORT no mesmo drop-in, execute systemctl --user daemon-reload e reinicie o serviço. Não é necessário reinstalar o MCP dos agentes só por trocar esse parâmetro.
Login OAuth e teste
Faça o login interativo no mesmo usuário que executa o serviço. O comando mostra uma URL e um código temporário: abra a URL, entre na sua conta ChatGPT/Codex e informe o código. Não copie o arquivo auth.json, nem cole tokens em arquivos de configuração.
ai-memory auth login openai-oauth

# depois de autorizar no navegador:
systemctl --user restart ai-memory.service
ai-memory auth status
AI_MEMORY_LLM_REASONING_EFFORT=high ai-memory llm-test \
  --provider openai-oauth \
  --model gpt-6-luna \
  --prompt 'Responda somente: OK'
O teste deve devolver OK. Se o login expirar ou for revogado, repita ai-memory auth login openai-oauth; para trocar de conta, execute antes ai-memory auth logout openai-oauth. Consulte a documentação de provedores do ai-memory para Anthropic, OpenAI por API, Gemini, Copilot e endpoints compatíveis com OpenAI.
Registrando MCP e hooks nos agentes
O MCP dá ao agente ferramentas como consulta de memória e aceitação de handoff. Os hooks fazem a captura automática do ciclo de vida. Os dois são necessários para a experiência completa. Os comandos abaixo fazem merge das entradas pertencentes ao ai-memory, sem exigir edição manual dos JSON e TOML dos clientes.
Defina o diretório de hooks extraído na instalação e execute a dupla de comandos para cada cliente instalado:
export PATH="$HOME/.local/bin:$PATH"
HOOKS_DIR="$HOME/.local/share/ai-memory/release-2.6.0/hooks"

# Claude Code
ai-memory install-mcp --client claude-code --apply
ai-memory install-hooks --agent claude-code --hooks-dir "$HOOKS_DIR" --apply --project-strategy repo-root

# OpenAI Codex
ai-memory install-mcp --client codex --apply
ai-memory install-hooks --agent codex --hooks-dir "$HOOKS_DIR" --apply --project-strategy repo-root

# OpenCode
ai-memory install-mcp --client open-code --apply
ai-memory install-hooks --agent open-code --apply --project-strategy repo-root

# Cursor Agent CLI
ai-memory install-mcp --client cursor --apply
ai-memory install-hooks --agent cursor --hooks-dir "$HOOKS_DIR" --apply --project-strategy repo-root

# Grok Build CLI
ai-memory install-mcp --client grok --apply
ai-memory install-hooks --agent grok --hooks-dir "$HOOKS_DIR" --apply --project-strategy repo-root
Reinicie os clientes depois do merge. No Codex, aprove os hooks quando o cliente pedir confirmação. O OpenCode carrega os hooks como um plugin TypeScript em ~/.config/opencode/plugins/, por isso também precisa ser reiniciado. No Grok, o stdout de SessionStart continua descartado; desde a 2.5.0, o handoff pendente é entregue como contexto no primeiro uso de ferramenta da sessão. Se a sessão não chamar nenhuma ferramenta, peça ao agente para chamar memory_handoff_accept. No Codex CLI 0.145.0 ou mais novo, o evento SessionEnd entrega o handoff automaticamente. Em versões antigas — ou quando esse evento não estiver disponível — o evento Stop não encerra a sessão: execute ai-memory finalize-session --agent codex ao concluir uma tarefa importante.
Escopo por repositório e regras de privacidade
Sem configuração, a partir da 2.5.0 o projeto de um checkout com remote Git é identificado pelo repositório (remote upstream, senão origin), não pelo nome da pasta: dois clones do mesmo repositório em pastas diferentes caem no mesmo projeto, e dois repositórios distintos com a mesma pasta não se misturam. Projetos existentes compatíveis podem ser reaproveitados. Na 2.6.0, os clientes atuais enviam por padrão identity_style = "path": o nome deriva do caminho completo do remote, sem o host. Uma captura ou escrita autorizada pode promover um nome compatível, preservando o UUID; consultas não renomeiam projetos e ambiguidades são recusadas. Confira o resultado com ai-memory doctor e ai-memory list-projects. Sem remote, vale o nome do diretório. O parâmetro --project-strategy repo-root usado acima evita que um cd para um subdiretório crie uma memória separada. Para declarar o escopo no próprio repositório, crie .ai-memory.toml na raiz:
workspace = "pessoal"
project = "site-linuxpro"

[briefing]
inject_on_session_start = "true"
max_chars = 4000

[capture]
ignore_paths = ["private/**", "~/.ssh/**"]
Os valores de workspace e project aceitam letras minúsculas ASCII, dígitos, ponto, hífen e sublinhado. Um project declarado no marcador continua tendo prioridade sobre o remote Git. A seção capture evita registrar eventos reconhecidos de ferramentas de arquivo sob os caminhos indicados; não é uma solução completa de DLP para comandos de shell ou conteúdo que você mesmo escrever no prompt. Para máxima cautela, instale os hooks em modo allowlist e coloque o marcador somente nos repositórios que devem ser capturados:
ai-memory install-hooks --agent claude-code --hooks-dir "$HOOKS_DIR" --apply --capture-mode allowlistPerfil compartilhado: confira o que atravessa projetos
Na 2.6.0, o perfil pode aprender preferências a partir das suas solicitações e de páginas curadas. Não confunda esse recurso com isolamento absoluto entre projetos: em uma instalação de um único operador, ele compartilha padrões de trabalho entre workspaces. Inspecione o conteúdo antes de adotá-lo em trabalhos de clientes:
ai-memory profile status
ai-memory profile list
Para impedir que um projeto contribua ou receba esse perfil, acrescente ao seu .ai-memory.toml, sem apagar as configurações existentes:
[profile]
contribute = false
consume = false
Essas opções controlam o perfil; não desligam os hooks nem substituem [capture]. Consulte a documentação do perfil para revisar, remover preferências e configurar o comportamento do servidor.
Handoff sem consumo automático
Se abrir uma sessão não deve consumir o contexto reservado para outra tarefa, ajuste a seção abaixo no arquivo de configuração usado pelo servidor. Preserve as demais seções e reinicie o serviço:
[handoff]
claim_on_session_start = false
create_on_session_end = false
Com a primeira opção, a abertura mostra um aviso com o ID do handoff, sem reivindicá-lo. O agente pode listar os pendentes com memory_handoff_list e aceitar o escolhido por ID. A segunda desliga a criação automática no encerramento de sessões não gerenciadas; resumos e consolidação continuam. Handoffs explícitos e execuções gerenciadas não são desativados. Ambas são opções globais do servidor e permanecem true por padrão.
Consultando a memória e entregando contexto
Depois de trabalhar normalmente pelo agente, use o MCP para pedir uma busca sobre decisões, arquivos ou tentativas anteriores. Ao encerrar, finalize a sessão quando necessário; o próximo agente deve aceitar o handoff pendente em vez de começar do zero.
# Útil principalmente após uma sessão do Codex:
ai-memory finalize-session

# Diagnóstico e manutenção local
ai-memory status
ai-memory doctor
ai-memory lint
Dentro de Claude, Codex, OpenCode, Cursor Agent CLI ou Grok, uma instrução simples basta: “busque na memória decisões sobre autenticação deste projeto” ou “aceite o handoff pendente”. O agente usa as ferramentas MCP registradas; não é preciso copiar a wiki para a conversa.
Acesso remoto: não exponha a porta crua
O exemplo deste artigo é local e não usa autenticação porque o bind é exclusivo de loopback. Para atender outra máquina, configure token bearer, allowed_hosts e HTTPS por um proxy reverso antes de alterar o bind. Autenticação não cifra o tráfego. O projeto mantém um guia de proxy HTTPS com exemplos para Caddy e Cloudflare Tunnel.
Atualizações e recuperação
Se você ainda usa 2.5.x: faça a primeira passagem para 2.6.0 pelo bloco manual de download deste artigo. Em 05/10/2026, o atualizador da 2.5.2 rejeitou o próprio pacote oficial com release archive contains unexpected path: ./crates/. A correção está no executável 2.6.0, não no atualizador antigo que já está rodando. A linha 2.4.x nem possui o subcomando upgrade.
mkdir -p "$HOME/backups/ai-memory"
ai-memory backup --to "$HOME/backups/ai-memory/ai-memory-$(date +%Y%m%d-%H%M%S).tar.gz"

# Execute o bloco de download deste guia com VER=2.6.0.
# Depois, atualize apenas os agentes que você já utiliza.
# Exemplo para Codex; repita com o nome de cada agente instalado:
HOOKS_DIR="$HOME/.local/share/ai-memory/release-2.6.0/hooks"
ai-memory install-hooks --agent codex --hooks-dir "$HOOKS_DIR" --apply

# Somente se você já usa OpenCode, regenere também o plugin:
# ai-memory install-hooks --agent open-code --apply

# Na raiz do projeto, preserve as regras e renove o bloco gerenciado:
ai-memory install-instructions --target AGENTS.md --skills-agent agents
# Para um projeto Claude Code, use --target CLAUDE.md --skills-agent claude-code.

systemctl --user restart ai-memory.service
systemctl --user is-active ai-memory.service
ai-memory --version
ai-memory status
O processo pode levar alguns segundos para voltar a responder. Se status retornar conexão recusada imediatamente após o reinício, consulte o journal e repita a consulta depois da inicialização. Reinicie também os clientes MCP; plugins gerados, como o do OpenCode, só recarregam na próxima abertura. Reaplicar hooks sem --project-strategy preserva a estratégia previamente gravada.
Validação local em 07/10/2026: a passagem manual de 2.5.2 para 2.6.0 preservou as páginas e sessões existentes; CLI e servidor passaram a informar 2.6.0, e a chamada OAuth de teste respondeu OK. O checksum do tarball Linux x86_64 também foi verificado antes da troca.
Com a 2.6.0 já instalada: o atualizador nativo passou a aceitar os arquivos auxiliares dos pacotes oficiais, continuando a validar o checksum. A release também corrige caminhos de hooks com o sufixo Linux (deleted) após a substituição do próprio binário. Em teste isolado, o binário 2.6.0 conseguiu baixar, verificar e reinstalar a própria release com upgrade --version 2.6.0 --force; esse teste não altera os hooks da instalação principal. Para uma próxima atualização de instalação nativa por release:
ai-memory backup --to "$HOME/backups/ai-memory/ai-memory-$(date +%Y%m%d-%H%M%S).tar.gz"
ai-memory upgrade
systemctl --user restart ai-memory.service
ai-memory --version
ai-memory status
Use --version X.Y.Z para escolher uma release específica. Instalações gerenciadas por pacotes devem ser atualizadas pelo respectivo gerenciador. O upgrade reaplica hooks registrados, mas não substitui a revisão das instruções e skills dos projetos.
Backup da memória não é backup dos agentes
ai-memory backup preserva a wiki e o estado SQLite, incluindo sessões, observações e handoffs. O novo comando abaixo cobre outro conjunto: configurações, skills, plugins e instruções dos agentes. Veja primeiro o plano e depois gere o arquivo:
ai-memory backup-agents --dry-run --to "$HOME/backups/ai-memory/agentes.tar.gz"
ai-memory backup-agents --to "$HOME/backups/ai-memory/agentes-$(date +%Y%m%d-%H%M%S).tar.gz"
A sanitização padrão cobre texto de configuração MCP, não todo arquivo: outros conteúdos são copiados integralmente e podem conter segredos. Proteja o arquivo e não o publique no Git. Antes de recuperar dados, consulte ai-memory restore --help ou ai-memory restore-agents --help, conforme o tipo de backup. Em migrações, guarde também a versão anterior do binário; não tente fazer downgrade contra um banco já migrado sem um plano de restauração.
Crédito ao autor e licença
O ai-memory é criado e mantido por Fábio Akita, autor do repositório akitaonrails/ai-memory. O arquivo LICENSE da release identifica “Copyright (c) 2026 Fabio Akita” e disponibiliza o projeto sob a licença MIT. Obrigado ao Fábio por disponibilizar uma alternativa aberta, local e interoperável para memória de agentes.
Com o serviço local, MCP e hooks instalados, você pode alternar de agente sem abandonar o histórico técnico do projeto. Para comparar outras opções, veja também as alternativas ao Claude-Mem em Go, Rust e C e o artigo sobre memória persistente para agentes no Linux.