

Quando um serviço começa a falhar, normalmente os sinais estão espalhados: métricas no Prometheus, logs em outro backend, traces em uma terceira ferramenta e alertas sem contexto. O OpenObserve tenta reunir esse trabalho numa plataforma open source para logs, métricas, traces, RUM, dashboards, alertas e incidentes. Escrito em Rust, ele consulta logs e traces com SQL, métricas com SQL ou PromQL e usa Parquet com armazenamento orientado a objetos para reduzir o custo de retenção.
Resumo em vídeo: a demonstração oficial de dois minutos mostra a instalação e os primeiros passos do OpenObserve. URL: OpenObserve 2-Minute Demo: Quick Install and Setup.
Revisão técnica: 7 de outubro de 2026. Este artigo apresenta a plataforma e um laboratório de logs. Para instalar sem Docker e operar com TLS e bucket, siga o guia de OpenObserve no Ubuntu.
O que é o OpenObserve
OpenObserve, também chamado de O2, é uma plataforma de observabilidade unificada. A ideia não é substituir todo agente que coleta telemetria, mas oferecer um destino e uma interface comuns para os sinais: logs, métricas e traces distribuídos. A plataforma também inclui dashboards, alertas, pipelines de ingestão, gerenciamento de incidentes, monitoramento de usuário real (RUM) e recursos de observabilidade para aplicações de IA.
O projeto é open source sob AGPL-3.0. Há também uma edição Enterprise e o serviço OpenObserve Cloud. Isso importa na escolha: a edição OSS é útil para quem quer controle da infraestrutura e da residência dos dados; recursos corporativos específicos, como SSO, RBAC granular, busca federada e gestão de carga, pertencem à oferta Enterprise.
Por que reunir logs, métricas e traces
Os três sinais respondem perguntas diferentes:
- Métricas mostram tendência e estado agregado: uso de CPU, taxa de erros, latência e volume de requisições.
- Logs preservam o evento e o contexto: mensagens da aplicação, erros, campos estruturados e auditoria.
- Traces acompanham uma requisição através de serviços, filas e bancos, tornando visível onde o tempo foi gasto.
O valor de uma plataforma unificada aparece na investigação. Um pico de erros no gráfico pode levar aos traces daquele serviço e, deles, aos logs do mesmo período. Isso não elimina a necessidade de instrumentar bem a aplicação nem corrige cardinalidade excessiva; apenas reduz as trocas de contexto entre ferramentas.
Se você já acompanha máquinas Linux, comece pelo nosso guia de Prometheus e Node Exporter. O OpenObserve pode complementar esse fluxo ao centralizar outros sinais, mas não há motivo para migrar às pressas uma stack estável apenas porque uma plataforma reúne mais funções.
Da aplicação à investigação: o fluxo da telemetria
A aplicação produz sinais; agentes ou um OpenTelemetry Collector recebem, processam e encaminham esses dados; o OpenObserve armazena e permite consultá-los. O Collector é opcional, mas pode centralizar o envio e reduzir a configuração repetida nos serviços. Ele não é o banco de dados nem o painel. O desenho abaixo é conceitual, não uma configuração pronta de todos os protocolos.
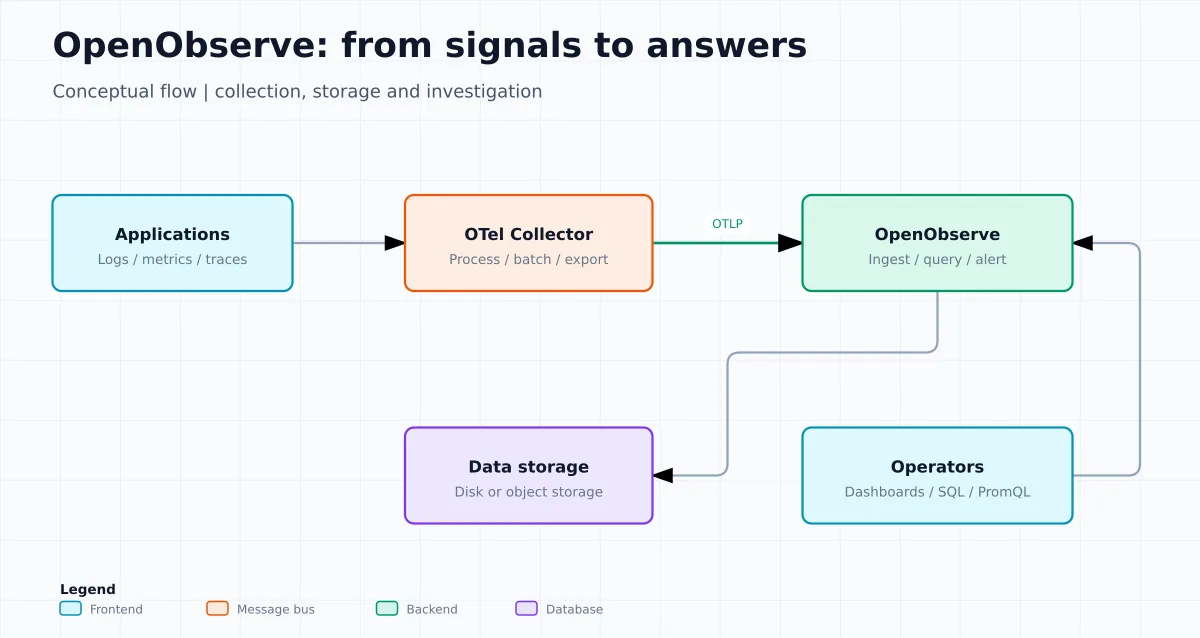
Mantenha identificadores consistentes de serviço e ambiente. Para correlacionar logs e traces, propague o contexto e inclua os identificadores de trace e span nos eventos relevantes. Não transforme IDs de usuário ou de requisição em labels de métricas sem avaliar cardinalidade. Referência: sinais do OpenTelemetry.
Como a arquitetura reduz o número de peças
No modo de nó único, o OpenObserve usa SQLite para metadados e pode gravar localmente ou em armazenamento de objetos. É o caminho para laboratório, desenvolvimento e cargas que não exigem alta disponibilidade. A documentação também prevê nó único com S3, GCS, MinIO ou Azure Blob: continua simples de operar, mas os arquivos Parquet ficam em armazenamento mais durável.
Em alta disponibilidade, a topologia muda: o projeto separa os papéis de Router, Ingester, Compactor, Querier e Scheduler. Kubernetes orquestra os nós; PostgreSQL guarda metadados; NATS coordena o cluster; e o armazenamento de objetos mantém os arquivos Parquet. Isso escala melhor, mas não é “um binário sem operação”: é uma arquitetura de produção que precisa de capacidade, backups, atualização planejada, rede e observabilidade do próprio backend.
Parquet organiza dados em colunas e permite compressão adequada a consultas analíticas. Isso não determina sozinho a economia: compare ingestão, retenção, concorrência, tempo de consulta, cache, requisições ao bucket e tráfego. Prefira medir sua carga a transportar um multiplicador de benchmark para o orçamento.
Recursos principais
| Área | O que o OpenObserve oferece | Ponto de atenção |
|---|---|---|
| Logs | Busca textual, filtros, SQL e construção visual de consultas. | Defina schema, retenção e campos úteis antes de enviar tudo indiscriminadamente. |
| Métricas | Consulta por SQL ou PromQL, gráficos e alertas. | Compatibilidade de consulta não substitui revisão das regras existentes. |
| Traces | Exploração de traces OpenTelemetry, waterfall, flame graph e service graph. | O resultado depende de propagação correta do contexto entre serviços. |
| Dashboards e alertas | Painéis, variáveis, visualizações, alertas e incidentes. | Alertas devem ter dono, severidade, rota e procedimento de resposta. |
| Pipelines | Transformações de ingestão, normalização e conversão de logs em métricas. | Teste transformações em amostra; um parser errado pode destruir contexto. |
| RUM e IA | Core Web Vitals, erros, replay de sessão e sinais para aplicações GenAI/LLM. | RUM e dados de IA exigem atenção redobrada a PII, consentimento e retenção. |
Instalação rápida em Docker para laboratório
O laboratório requer Bash, curl, OpenSSL e Docker Engine atualizado, com permissão para executar containers. Use Docker 28 ou posterior para evitar a limitação histórica de publicação em loopback acessível no mesmo segmento de rede; veja a documentação de publicação de portas.
O procedimento abaixo usa a imagem OSS indicada pelo repositório do projeto. Ele é para teste local ou uma prova de conceito; não exponha a porta 5080 diretamente na internet e não use uma senha de exemplo em servidor acessível.
umask 077
LAB=$(mktemp -d "$HOME/openobserve-lab.XXXXXX")
cd "$LAB"
mkdir data

export ZO_ROOT_USER_EMAIL="admin@example.com"
export ZO_ROOT_USER_PASSWORD="$(openssl rand -base64 32)"

printf '%s\n' "$ZO_ROOT_USER_PASSWORD" > senha-inicial.txt
chmod 600 senha-inicial.txt

docker run -d \
  --name linuxpro-openobserve-lab \
  --restart no \
  -v "$PWD/data:/data" \
  -p 127.0.0.1:5080:5080 \
  -e ZO_DATA_DIR="/data" \
  -e ZO_ROOT_USER_EMAIL \
  -e ZO_ROOT_USER_PASSWORD \
  public.ecr.aws/zinclabs/openobserve:latest
Abra http://127.0.0.1:5080 no próprio host ou faça um túnel SSH. Para uma equipe, publique a interface atrás de um proxy reverso com TLS e autenticação apropriada. Em produção, prefira uma tag de imagem testada em vez de latest e acompanhe a página de releases.
O usuário raiz é definido na primeira inicialização. Guarde a credencial fora do histórico do shell e de arquivos compartilhados, por exemplo em um gerenciador de segredos. Antes de apagar o teste, pare o container e remova o diretório de dados conscientemente: é ali que a telemetria local foi persistida.
Enviar um evento e fechar o teste de ponta a ponta
Confira o processo antes de enviar dados:
docker logs --tail=50 linuxpro-openobserve-lab
curl --fail --silent --show-error --retry 20 --retry-connrefused --retry-delay 2 http://127.0.0.1:5080/healthz
Envie o evento abaixo no terminal do host. O curl pedirá a senha salva em senha-inicial.txt, sem colocá-la no histórico. A organização é default e o stream é linuxpro_lab. Sem timestamp explícito, o servidor atribui o horário da ingestão.
curl --fail-with-body --silent --show-error \
  --user admin@example.com \
  --header 'Content-Type: application/json' \
  --data '[{"service":"linuxpro-demo","level":"info","message":"primeiro evento","duration_ms":12}]' \
  http://127.0.0.1:5080/api/default/linuxpro_lab/_json
Confira o corpo da resposta: HTTP 200 sozinho não basta se houver registros rejeitados. Entre na interface, selecione Logs e o stream linuxpro_lab, escolha os últimos minutos e execute no modo SQL:
SELECT _timestamp, service, level, message, duration_ms
FROM "linuxpro_lab"
ORDER BY _timestamp DESC
LIMIT 20
Encontrar primeiro evento comprova ingestão e consulta, não apenas processo ativo. Se não aparecer, confira organização, stream, janela de tempo e resposta do POST. O exemplo testa logs JSON; métricas e traces precisam de seus próprios exporters e endpoints. Referência oficial das APIs.
Registre a imagem efetiva para repetir o laboratório. A tag latest muda; em produção, fixe uma release homologada ou o digest e planeje atualizações.
docker image inspect public.ecr.aws/zinclabs/openobserve:latest --format '{{index .RepoDigests 0}}'
unset ZO_ROOT_USER_PASSWORD
Administradores do Docker podem inspecionar as variáveis do container. O arquivo de senha e o diretório precisam continuar protegidos. Para parar sem apagar a persistência:
docker stop linuxpro-openobserve-lab
docker rm linuxpro-openobserve-lab
O diretório data permanece. Remova-o somente quando decidir que esses dados são descartáveis. Não execute limpeza global de volumes ou containers.
Do laboratório à produção
Uma instalação de produção começa por decisões de dados, não pelo comando de Docker:
- Escolha a retenção por tipo de sinal. Logs de debug e replay de sessão não precisam ter a mesma janela que métricas de capacidade.
- Planeje o armazenamento. Para durabilidade e escala, use um bucket compatível com o desenho recomendado pelo projeto; para HA, armazenamento local não é suportado.
- Use OpenTelemetry quando possível. Padronizar instrumentação e contexto reduz dependência de agentes específicos.
- Separe organizações, streams e credenciais. Não misture produção, homologação e dados sensíveis sem uma política clara.
- Trate acesso como parte da arquitetura. A comparação oficial informa que a OSS não fornece RBAC granular; valide os requisitos de SSO, auditoria e permissões antes de abrir a plataforma para vários times.
- Teste restauração. Backup não testado é apenas uma esperança. Verifique dados, metadados e as configurações necessárias para recuperar o ambiente.
O guia oficial deixa claro que o modo HA requer Kubernetes, PostgreSQL, NATS e armazenamento de objetos. Se a equipe não tem maturidade para operar esses componentes, a edição Cloud ou um nó único bem delimitado pode ser uma decisão mais segura que uma implantação HA subdimensionada.
Consultas, dashboards e alertas
Logs e traces podem ser explorados com SQL; métricas podem usar SQL ou PromQL. A vantagem prática é preservar linguagens que muitos times já conhecem em vez de obrigar uma DSL proprietária. Ainda assim, migração de dashboards e alertas exige revisão: nomes de métricas, labels, janelas temporais, agregações e semântica de funções precisam ser validados contra o resultado anterior.
Comece por um painel pequeno e acionável: disponibilidade, taxa de erro, latência de percentis e sinais de saturação. Para cada alerta, documente qual dashboard abrir, quais campos filtrar, quem atende e qual ação pode ser tomada. Alertar sobre tudo é o caminho mais curto para ignorar alertas.
Vídeo oficial: este tutorial do canal OpenObserve percorre a criação de dashboards. URL: Building Dashboards with OpenObserve: A Comprehensive Tutorial.
Open source, Enterprise e Cloud
A edição OSS é AGPL-3.0 e gratuita, com logs, métricas, traces, RUM, dashboards e alertas. Segundo a tabela oficial de downloads, ela tem suporte básico a usuários, mas sem RBAC granular: os usuários têm acesso completo. A edição Enterprise acrescenta, entre outros itens, SSO, papéis personalizados, grupos, auditoria, busca federada, controle de workload e recursos avançados de pipeline e segurança.
Separe licença de custo operacional: infraestrutura, retenção, requisições, tráfego e trabalho da equipe continuam existindo em self-hosted. Franquias e condições comerciais mudam; consulte a página de preços e a comparação de edições antes de decidir.
Quando faz sentido — e quando não
OpenObserve é uma boa opção para quem quer consolidar telemetria em torno de OpenTelemetry, SQL, PromQL e armazenamento de objetos; para times que já pagam caro por retenção de logs; ou para quem prefere operar uma plataforma integrada em vez de conectar várias peças.
Ele talvez não seja a escolha certa se a equipe só precisa de métricas de poucos hosts, se já existe uma plataforma com SLOs e integrações maduras que atende bem, ou se não há capacidade para operar dados, backup e upgrades. “Um binário” simplifica o primeiro teste; não elimina responsabilidade operacional, governança de acesso nem custo de armazenamento.
Mais um vídeo: comparação com Splunk
Para uma visão de posicionamento do produto, este vídeo de WPoets TV traz uma conversa com a OpenObserve sobre comparação com Splunk. É uma fonte complementar, não substitui teste de carga e cálculo de custo no seu ambiente.
Para conhecer uma opção de armazenamento de objetos com API S3, veja RustFS no Linux: instalação por binário e Docker. RustFS armazena objetos; OpenObserve recebe, consulta e apresenta a telemetria. Homologue a compatibilidade entre as versões antes de combiná-los.
Fontes oficiais e próximos passos
- Repositório OpenObserve no GitHub
- Documentação oficial
- Recursos da plataforma
- Arquitetura e modos de implantação
- Quickstart: Cloud e self-hosted
- Blog do OpenObserve
- Preços e downloads
O melhor próximo passo é pequeno: rode o laboratório, envie uma fonte de logs e uma métrica que você já conhece, crie um único alerta e calcule ingestão e retenção reais. Só então decida se vale ampliar a plataforma.