Encuentras una función interesante en una aplicación, un formato de archivo sin documentación o un programa antiguo que necesitas entender. El problema no es pedirle a la IA que “adivine cómo funciona”: es darle los medios para examinar el objetivo y exigir evidencias. El REA — Reverse Engineer Anything conecta agentes de programación a herramientas de ingeniería inversa mediante MCP y ofrece los mismos flujos a través de una CLI.
Este artículo complementa “Ingeniería inversa con IA: ¿murió Adobe?”, de Fábio Akita, publicado el 13 de octubre de 2026. Su discusión separa el entusiasmo por las reconstrucciones asistidas por IA del trabajo necesario para entender y reproducir software. Aquí, el foco es operativo: qué herramientas integra REA, qué preguntas ayudan a responder y cómo empezar con un objetivo controlado en Linux.
3b79af28e80785afce9f5998d8f03289402a1847, y el paquete npm correspondiente. La documentación de la rama principal puede mostrar capacidades posteriores. Las pruebas locales utilizaron una pequeña aplicación creada para este artículo; no ejecutamos objetivos de terceros ni instalamos Ghidra, Hopper ni IDA.REA no es un botón para clonar cualquier software
REA es una capa de integración, investigación y evidencia. El agente formula una pregunta, llama a una herramienta, recibe observaciones y decide cuál será el siguiente paso. La descompilación sigue siendo trabajo de un motor como Ghidra, Hopper o IDA; el análisis de JavaScript utiliza otras vías; observar un proceso en ejecución es una operación diferente a leer un archivo.
El propio nombre “Reverse Engineer Anything” debe leerse como una propuesta amplia, no como una garantía. La herramienta no recupera automáticamente los nombres, comentarios, intenciones y pruebas que el compilador descartó. Tampoco entrega el backend de un SaaS solo porque hayas abierto su interfaz en el navegador.
Esto no disminuye su utilidad. Automatizar inventarios, encontrar referencias, relacionar módulos y mantener el origen de los resultados puede ahorrar bastante trabajo repetitivo. Pero pseudocódigo legible, código que compila y comportamiento equivalente son tres cosas diferentes.
Cómo funciona: agente, herramientas y evidencias
El proyecto está escrito en TypeScript, distribuido como rea-agents y ofrece el comando rea. REA se publica bajo licencia MIT; esto no altera las licencias propias de Hopper, IDA ni de otros proveedores externos. CLI y MCP usan flujos compartidos. Según la tarea, REA trabaja con un parser propio, una instalación externa de herramienta o una conexión con un runtime que hayas seleccionado.
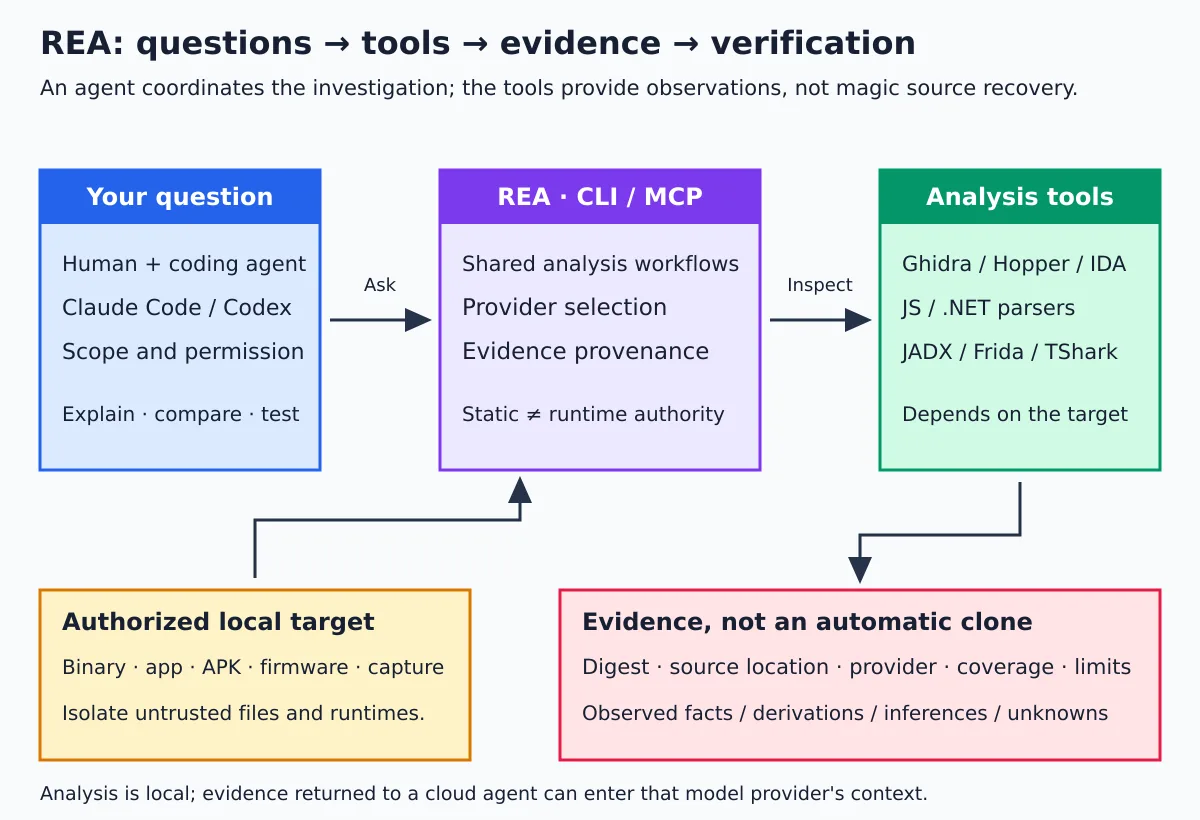
Los resultados usan un contrato de Evidence, con campos para identificar el objetivo, operación, proveedor, parámetros, origen y limitaciones. Según el flujo, también hay hashes, ubicaciones en el artefacto e información de cobertura. Esto ayuda a distinguir:
- Observación: una cadena, instrucción, import o declaración encontrada en el archivo.
- Derivación: una relación obtenida a partir de hechos observados y reglas explícitas.
- Inferencia: una hipótesis sobre finalidad o comportamiento.
- Desconocido: algo que el análisis no pudo establecer.
Una dirección similar a una API en un bundle no prueba que ese endpoint haya sido llamado. Dos funciones con texto similar no prueban equivalencia de comportamiento. Esta disciplina es más importante que el número de herramientas expuestas al agente. Los contratos están en la documentación MCP.
Las herramientas, organizadas por pregunta
No es necesario instalar todo. Elija primero el objetivo y la pregunta; luego vea la herramienta requerida. Algunas capacidades ya están en el paquete, otras dependen de programas proporcionados por usted. Las plataformas y versiones compatibles varían según el adaptador.
| Tipo de análisis | Herramientas o mecanismo | Qué ayuda a descubrir | Límite importante |
|---|---|---|---|
| Binario nativo | Ghidra, Hopper o IDA. | Ensamblador, pseudocódigo, funciones, cadenas, llamadas y referencias. | El formato y la arquitectura dependen del proveedor; la salida no es la fuente original. |
| Inspección nativa auxiliar | GNU objdump y Rizin proporcionados por el usuario. | Cabeceras, secciones, símbolos, reubicaciones e instrucciones. | No todo comando equivale a descompilación; las capacidades dependen de la instalación. |
| JavaScript/Electron estático | Analizadores de REA; Wakaru opcional para recuperación de fuentes. | Módulos, imports, exports, candidatos a rutas y relaciones entre main, preload y renderer. | Las expresiones dinámicas y la ofuscación pueden dejar relaciones desconocidas. |
| Navegador y aplicaciones web | CDP en navegador compatible; flujos de escenarios con Playwright. | Estructura de la página, scripts, recursos, observaciones de red y diferencias entre ejecuciones. | Observación pasiva y escenario que dirige el navegador tienen autoridades distintas. |
| Android | JADX y JDK; adb y Apktool para tareas específicas; JEB por integración propia. | Manifiesto, clases, métodos, recursos e información de dispositivo autorizado. | APK descompilado no es un proyecto Android listo para recompilar. |
| .NET | Inspección estática de metadatos PE/CLI y CIL. | Identidad, tipos, miembros, instrucciones y dependencias nativas declaradas. | NativeAOT y otras formas de distribución requieren un tratamiento diferente. |
| Runtime e instrumentación | Frida, GDB e integraciones de captura según el host. | Eventos, llamadas, salida y comportamiento de un proceso seleccionado. | Puede ejecutar código, modificar el estado o afectar al objetivo; requiere autorización adicional. |
| Firmware | Binwalk y Unblob en Linux. | Regiones, contenidos extraídos y artefactos para análisis posterior. | Extraer archivos no significa comprender toda la lógica ni conseguir actualizar el dispositivo. |
| Tráfico capturado | HAR/SAZ; TShark/capinfos; mitmdump en un flujo concreto. | Peticiones, respuestas, endpoints, protocolos y campos seleccionados. | Las capturas pueden contener credenciales y datos personales; el cifrado limita el contenido visible. |
| Señales lógicas capturadas | sigrok-cli y límites del proceso en Linux. | Anotaciones de decodificadores y rangos de muestras. | Depende de la señal registrada y del decodificador adecuado. |
| Metadatos de Go/Rust | Inspección estática integrada para formatos compatibles. | Información de compilación de Go y dependencias de Rust cuando hay metadatos cargo-auditable. | La ausencia de metadatos no demuestra la ausencia de dependencias. |
| WASM, EVM y SQLite | Flujos específicos; WABT externo para WASM, requisitos propios para SQLite. | Secciones e imports/exports, estructura de bytecode o esquema y muestras de tablas. | Son análisis diferentes; uno no sustituye las pruebas de ejecución del otro. |
Los puntos de partida son las guías de binarios nativos, JavaScript, Android, .NET e herramientas auxiliares.
Ghidra, Hopper e IDA: ¿cuál es el papel de cada uno?
Para una investigación nativa profunda, necesitas un proveedor compatible instalado y configurado. REA no sustituye a esos motores: ofrece acceso organizado a sus operaciones y preserva la procedencia de los resultados.
- Ghidra: una vía abierta para análisis nativo. REA importa el objetivo a un proyecto temporal de análisis; no es simplemente un robot haciendo clic en tu GUI.
- Hopper: integración con herramienta comercial; la configuración puede ofrecer instalación, previa aprobación. Demo y licencia tienen sus propias condiciones.
- IDA: utiliza una instalación y los componentes compatibles que ya posees; no proporciona licencia de IDA ni de Hex-Rays.
REA no descarga ni actualiza Ghidra o Java por ti. Configura las rutas según la guía del proveedor y verifica la compatibilidad de esa versión. Para diagnóstico dirigido:
rea providers --json
rea capabilities --json
rea doctor --provider ghidra --json
Elegir explícitamente un proveedor evita ambigüedades cuando hay más de uno disponible. No utilices una dirección de función inventada: averigua la dirección o nombre en el inventario del objetivo antes de solicitar una operación.
# Somente em um binário próprio ou cuja análise foi autorizada:
rea analyze /caminho/absoluto/programa --provider ghidra --json
rea function /caminho/absoluto/programa main --provider ghidra --json
Estos ejemplos son condicionales: un binario sin símbolo main requiere otro identificador, y el análisis necesita un Ghidra configurado. No ejecutamos ese flujo nativo en el laboratorio de este artículo.
Instalación rápida y configuración sin sorpresas
En 6.5.0, el paquete declara estos rangos de Node.js: 22.x a partir de 22.19, 24.x a partir de 24.11 o 26 y posteriores, además de npm. No simplifique esto a “cualquier Node más nuevo que 22”: otras líneas intermedias no aparecen en la declaración de compatibilidad.
Hay requisitos específicos: la inspección de SQLite en la versión analizada pide Node 24.x a partir de 24.15 o 26+. El Node 24.13.1 usado en nuestra prueba JavaScript cumple el requisito general, pero no con este flujo de SQLite.
En Linux, algunos flujos necesitan un ps compatible con procps para comprobar identidad y propiedad de los procesos. En una distribución mínima, verifique antes de comenzar:
node --version
npm --version
command -v ps

# CLI sem instalação global, fixando a versão examinada
npx --yes rea-agents@6.5.0 --version
npx --yes rea-agents@6.5.0 --help

# Planejamento somente leitura: não altera o Codex nem instala a skill
npx --yes rea-agents@6.5.0 setup \
  --client codex --skill=false --dry-run --json
npx --yes aprueba la descarga/ejecución del paquete por parte de npm; no es la misma autorización que aplicar cambios de configuración del REA. Lea el plan, haga una copia de seguridad de las configuraciones y luego ejecute la configuración interactiva para elegir los clientes y aprobar exactamente lo que se va a modificar:
npx rea-agents@6.5.0 setupLa configuración puede registrar MCP e instalar instrucciones de investigación compatibles con esa versión. Reinicie los clientes después. Instalar solo una skill no equivale a configurar el servidor y los motores de análisis. Para un uso frecuente, el proyecto también documenta la instalación global de rea-agents; prefiera un prefijo de usuario o un gestor de Node en lugar de instalar con sudo npm.
La fuente oficial es morluto/rea, el sitio rea.tools y los metadatos oficiales del paquete npm rea-agents. Un nombre similar en GitHub no demuestra que la descarga sea oficial.
Primer ejercicio: una pequeña aplicación JavaScript propia
No necesitas empezar con un binario comercial enorme. Un proyecto controlado te permite comparar el análisis con algo que conoces. Los comandos a continuación crean un ejemplo sencillo y analizan sus archivos como texto, sin necesidad de Ghidra.
mkdir -p rea-lab-app/lib
cd rea-lab-app

cat > package.json <<'JSON'
{"name":"rea-lab-app","version":"1.0.0","main":"main.cjs"}
JSON

cat > lib/labels.cjs <<'JS'
exports.normalizeLabel = (value) => String(value).trim().toLowerCase();
JS

cat > main.cjs <<'JS'
const { normalizeLabel } = require('./lib/labels.cjs');
module.exports = { normalizeLabel };
JS

npx --yes rea-agents@6.5.0 analyze-javascript-application \
  "$PWD" --json > ../rea-lab-evidence.json
El resultado no es solo una explicación en lenguaje natural. Hay una estructura de evidencia y relaciones entre artefactos y módulos. Para inspeccionarla, usa un visualizador de JSON o genera una vista resumida a partir del archivo guardado. El siguiente ejemplo utiliza jq, que debe estar instalado:
cd ..
jq -c '{source: {kind: "inline", evidence: .}, view: {kind: "summary"}}' \
  rea-lab-evidence.json > rea-lab-summary-request.json

npx --yes rea-agents@6.5.0 inspect-analysis-view \
  rea-lab-summary-request.json --json > rea-lab-summary.json
En el laboratorio, usamos una variante controlada de esta aplicación y añadimos un marcador que se escribiría si se ejecutara el entrypoint. El análisis finalizó con éxito y el marcador no se creó. Esto es coherente con la ruta de análisis estático declarada por el proyecto; no demuestra seguridad universal para cualquier archivo o analizador sintáctico.
Qué probamos y qué quedó fuera
| Verificación | Resultado observado |
|---|---|
| Paquete npm y etiqueta | Versión 6.5.0 confirmada; pruebas con Node 24.13.1. |
| CLI | --version e --help funcionaron. |
| Configuración de solo lectura | El plan para Codex devolvió planned, sin acciones aplicadas, en un HOME aislado. |
| Análisis estático de JavaScript | Devolvió Evidence con objetivo, resumen, relaciones y limitaciones, sin ejecutar el entrypoint de prueba. |
| Visión resumida | inspect-analysis-view procesó la evidencia guardada. |
| Volumen de salida de este ejemplo | 124.682 bytes de Evidence y 10.032 bytes en la respuesta de visión resumida. |
| Proveedores externos y runtime | No probados: Ghidra, Hopper, IDA, JADX, Frida, dispositivos y escenarios de navegador. |
Instalamos el paquete en un directorio de laboratorio, sin instalación global y con scripts de instalación desactivados. Esto fue suficiente para los flujos estáticos examinados, pero no valida integraciones nativas opcionales. No aplicamos la configuración a los agentes reales del usuario.
Los tamaños anteriores son bytes de JSON, no tokens, ni una estimación de coste de API. Tampoco son un benchmark de escala: el objetivo era pequeño. La lección práctica es que preservar la evidencia completa en disco y consultar una proyección puede ser mejor que volcarlo todo en el contexto del modelo.
Casos de uso: dónde ayuda realmente REA
1. Documentar un sistema heredado
Imagina una utilidad interna cuyo fuente se perdió, pero cuyo uso y análisis fueron autorizados. Puedes extraer cadenas, parámetros, formatos reconocidos y funciones candidatas, y luego contrastar las hipótesis con entradas y salidas controladas. El objetivo inicial es una especificación testeable, no reescribir todo en el primer prompt.
2. Entender un flujo en JavaScript o Electron
Una función de exportación puede atravesar renderer, preload, IPC y proceso principal. El grafo estático ayuda a mapear esos límites; la observación de runtime autorizada puede mostrar qué caminos ocurrieron realmente. Los imports encontrados y el código alcanzable no significan, por sí solos, ejecución probada.
3. Interoperabilidad y migración
Una integración puede necesitar entender un formato o contrato observado para construir una implementación propia. Trabaja con muestras permitidas, registra casos de prueba, fallos y ambigüedades, y valida los resultados. No supongas que conseguir descompilar un archivo concede derechos para copiar su implementación o redistribuirla.
4. Preservación de software y juegos antiguos
Los objetivos estables, los algoritmos pequeños y las entradas reproducibles son buenos candidatos para investigar. El ensamblaje y las comparaciones de comportamiento pueden ayudar a recuperar un cálculo específico. Esto no es lo mismo que reconstruir assets, herramientas, servidores o un juego entero de forma automática.
5. Comparar versiones e investigar regresiones
El REA tiene flujos de comparación para diferentes tipos de artefacto. Pueden localizar cambios de estructura, texto u observaciones de ejecución. Una diferencia de pseudocódigo no demuestra, por sí misma, regresión funcional; organiza tests para la hipótesis concreta.
6. Auditoría autorizada de aplicaciones
Los inventarios de permisos, bibliotecas, recursos y candidatos a endpoints ayudan a formular preguntas de seguridad y privacidad. Combina análisis estático y observación autorizada, sin convertir “no encontré” en “no existe”. No uses esta actividad para recopilar datos de cuentas o dispositivos de terceros sin permiso.
7. Firmware, protocolos y equipos
Los firmwares y las capturas grabadas pueden revelar componentes, diseños y mensajes. En hardware propio o laboratorio autorizado, esto ayuda en la documentación e interoperabilidad. La extracción, emulación, ejecución y grabación de firmware son actividades distintas, con riesgos y permisos diferentes.
El análisis estático, la observación pasiva y la ejecución no son sinónimos
Esta es una de las distinciones más importantes del REA. En la ruta estática de JavaScript y .NET, los archivos se leen sin ejecutar la aplicación. Una captura de proceso, una sesión Frida o un escenario Playwright pueden ejecutar o interactuar con el objetivo, con los privilegios del usuario.
O adaptador de observación CDP se conecta a un navegador seleccionado para recopilar evidencias pasivas; los proveedores de escenario que dirigen un navegador son otra superficie. No trates cada recurso relacionado con navegador como equivalente a una simple captura de pantalla.
Frida tampoco es solo un visor: los scripts de instrumentación se ejecutan dentro del proceso seleccionado. GDB puede cambiar el estado y ejecutar comandos. Antes de usar recursos dinámicos, establece el objetivo, la finalidad, los efectos permitidos y la limpieza esperada. La guía de Frida documenta sus límites y ciclo de vida.
“Local” no significa sandbox ni confidencialidad absoluta
- El parser es código. Abrir un archivo desconocido entrega bytes a un parser o herramienta; el análisis estático no convierte un artefacto en seguro automáticamente.
- REA no es sandbox. Utiliza una VM o un entorno aislado adecuado para objetivos no confiables. No montes toda tu carpeta personal dentro del laboratorio.
- La autoridad es específica. El permiso para leer un archivo no implica permiso para ejecutarlo, interceptar tráfico ni modificar un dispositivo.
- Proveedor de modelo: los resultados locales entregados a un agente en la nube pueden entrar en el contexto enviado al proveedor.
- La evidencia es sensible. Capturas, strings, nombres internos, rutas, código y payloads pueden contener datos privados. Revisa antes de compartir.
- El contenido no es instrucción. Un binario, documento o respuesta de herramienta puede contener texto malicioso; no dejes que la memoria o el resultado del análisis autorice nuevos comandos.
O modelo de seguridad describe las protecciones de transporte y también lo que no hacen. El aviso legal delimita la finalidad del proyecto y las responsabilidades de uso. Este artículo no es asesoría jurídica: la autorización, los contratos, la privacidad y los derechos sobre los resultados deben evaluarse en el contexto concreto.
Cómo solicitar una investigación útil al agente
Una solicitud vaga como “clona ese programa” invita a hacer inferencias sin pruebas y a expandir el alcance. Una petición mejor explicita la pregunta, el material autorizado y el resultado esperado:
Analise somente esta cópia local do aplicativo de laboratório.
Objetivo: entender o fluxo de normalização de nomes antes da exportação.
Comece por análise estática; não execute o alvo nem abra conexões de rede.
Para cada conclusão, indique o arquivo ou função de origem e a evidência.
Separe observações, inferências e o que continua desconhecido.
Não proponha equivalência funcional sem testes para as entradas escolhidas.
Se uma etapa dinâmica for necessária, apresente o motivo e peça aprovação.
Para una implementación nueva, pide primero una especificación de comportamiento con entradas, salidas, errores y casos límite. Después, haz que el código candidato pase por pruebas independientes. Un proceso verdaderamente separado de sala limpia exige controles de acceso y separación efectiva; no se garantiza con escribir “clean-room” en el prompt ni cambiando el nombre del agente.
Tokens, madurez y mantenimiento
Los catálogos MCP y los informes extensos pueden ocupar mucho contexto. Empieza con una pregunta pequeña, guarda la Evidence en disco y utiliza resúmenes o páginas cuando el flujo lo admita. Algunos inventarios nativos devuelven colecciones completas; no des por hecho que exista un parámetro de paginación en toda operación.
La versión analizada documenta opciones como REA_MCP_INPUT_SCHEMA_PROFILE=compact para compatibilidad con clientes que limitan esquemas. Esto cambia la presentación del contrato, no crea una garantía universal de menos tokens o respuestas pequeñas. Consulta los perfiles de esquema antes de modificar la configuración.
El proyecto tiene pruebas y verificaciones específicas por herramienta, pero el soporte declarado y las pruebas simuladas no sustituyen la ejecución con el proveedor real. La guía de pruebas deja esa distinción explícita. No usamos las estrellas ni el número de commits como certificado de madurez.
REA evoluciona rápido. Fijar una versión ayuda a reproducir una investigación; para actualizar, revisa las notas, los requisitos y los cambios de contrato, actualiza la CLI y revisa también la configuración y las instrucciones del agente. No mezcles silenciosamente documentación de main, paquete npm antiguo y habilidad de otro release.
Entonces, ¿Adobe ha muerto?
No es eso lo que REA demuestra. Entender un algoritmo o flujo de una aplicación no reproduce automáticamente el producto entero, sus integraciones, datos, infraestructura, formatos y criterios de calidad. La distinción que comenta Akita es un buen antídoto contra convertir una demostración interesante en promesa universal.
La ganancia real está en investigar mejor: preguntas más pequeñas, herramientas adecuadas, evidencia trazable y pruebas que afronten la hipótesis. Para quienes usan agentes en la terminal Linux, REA añade un banco especializado — diferente de herramientas que guardan memoria de las sesiones o mapean la estructura del propio repositorio.
Empiece por algo suyo y pequeño. El ejercicio JavaScript ya permite aprender el contrato de evidencia sin instalar un desensamblador. Después, elija un proveedor y un caso autorizado. REA es un conjunto de herramientas potente; lo que hace que el resultado sea fiable sigue siendo el alcance, el método y la verificación.