Na parte 1, o rclone levou arquivos do servidor para a nuvem. Aqui ele leva uma nuvem para outra: buckets do Amazon S3 migrados para o Google Cloud Storage (GCS) ou para o OCI Object Storage, da Oracle. O processo é o mesmo para os dois destinos — muda só o remote de chegada — e foi montado para migrar sem janela longa de parada: cópia em massa com as aplicações ainda no S3, deltas até o atraso ficar pequeno, congelamento curto, verificação e virada.
Os comandos usam o rclone 1.75.1. O fluxo de cópia, delta, sync final e verificação foi ensaiado de ponta a ponta contra um S3 local (o próprio rclone serve s3); a sintaxe dos remotes de GCS e OCI foi conferida no binário e na documentação dos provedores. Não houve teste contra contas reais de AWS, GCP ou OCI. Contas reais têm limites, políticas e quotas próprias — faça um ensaio com um bucket pequeno antes do grande.
Antes de começar: custo, lugar e escopo
Custo. O que mais pesa numa migração para fora da AWS é a saída de dados: a AWS cobra por GB transferido do S3 para a internet. Desde março de 2024 existe um programa que isenta essa cobrança para quem está saindo da AWS, mas ele não é automático: é preciso abrir um chamado no suporte, a aprovação é por conta e o prazo para concluir a migração é de 90 dias (anúncio oficial). Peça antes de começar, não depois da fatura. Some as requisições de listagem, leitura e gravação (LIST, GET, HEAD e PUT), a recuperação de classes frias, a VM e eventual tráfego de saída do destino na verificação. Muitos objetos pequenos podem tornar o custo de requisições relevante; calcule para suas regiões e classes.
Lugar. Numa cópia entre provedores diferentes não existe “cópia server-side”: cada objeto sai do S3, passa pela memória da máquina que roda o rclone e é gravado no destino. O conteúdo dos objetos é transmitido sem precisar armazenar o bucket no disco local; logs e inventários ficam em disco. A banda, a CPU e os limites das APIs podem limitar a transferência. Rode o rclone numa VM perto de uma das pontas — uma instância no GCP ou no OCI na mesma região do bucket de destino é o mais prático, porque permite autenticar sem chave em arquivo (veja abaixo) — e não no notebook de casa.
Escopo. O rclone migra objetos: conteúdo, nome, Content-Type e data de modificação. Políticas de bucket, ACLs, regras de ciclo de vida, versionamento, notificações de eventos e replicação são configuração do bucket e precisam ser recriadas no destino, na linguagem de cada provedor. Liste isso no início para não descobrir na virada.
Arquitetura e fases da migração
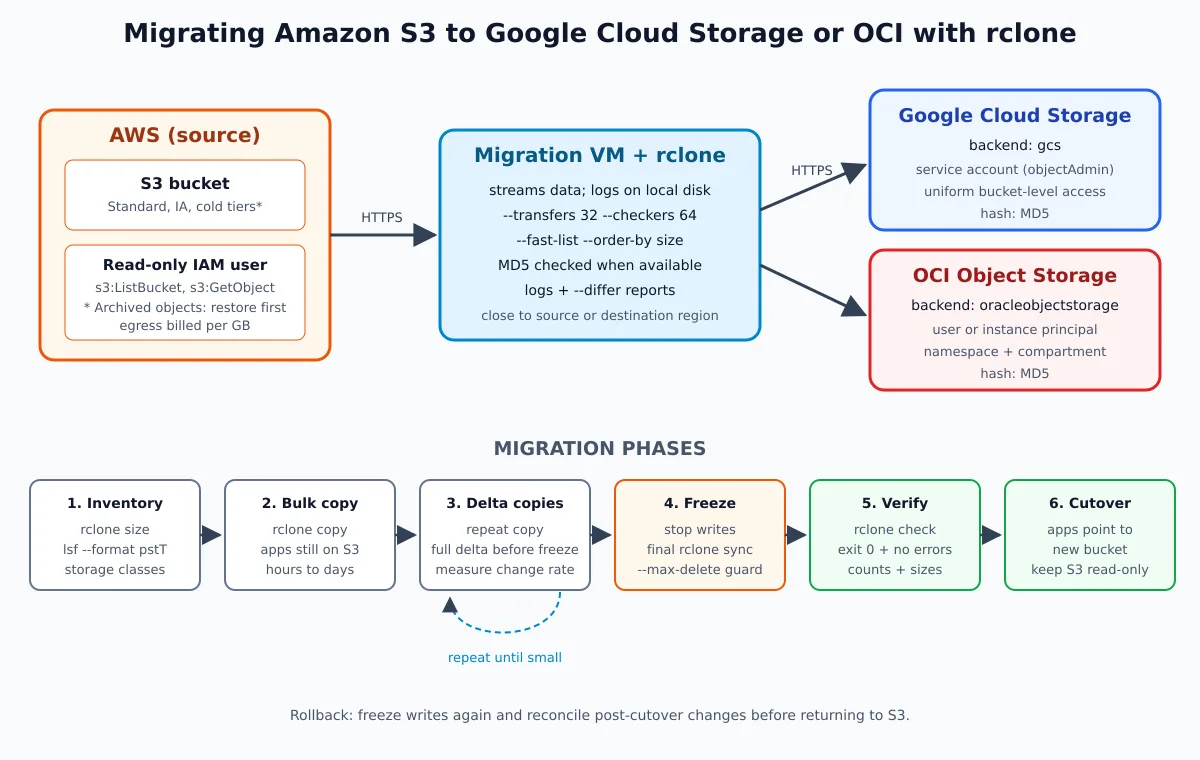
A VM com o rclone lê do S3 com um usuário IAM somente leitura e grava no destino com uma credencial de objetos restrita ao bucket de destino. A migração passa por seis fases: inventário, cópia em massa, deltas repetidos, congelamento com sync final, verificação e virada das aplicações. O bucket do S3 continua intacto e somente leitura até o novo estar validado em produção — é o seu plano de volta.
Preparar a VM de migração
Instale o rclone conforme a parte 1, além de tmux e Python 3. Os exemplos abaixo usam Bash e nomes de buckets ilustrativos: substitua nomes, projeto, namespace, compartment e regiões. A criação de buckets, contas e políticas exige uma identidade administrativa separada; o processo de cópia usa somente as permissões restritas apresentadas adiante. Instale e autentique a CLI do destino escolhido antes das etapas de provisionamento.
umask 077
mkdir -p "$HOME/rclone-migracao/logs" "$HOME/.config/rclone"
cd "$HOME/rclone-migracao"
rclone version
Todos os arquivos de inventário e relatórios serão gerados nesse diretório. Não coloque chaves em repositórios, no histórico do shell ou em argumentos visíveis na lista de processos.
Origem: credencial somente leitura na AWS
Crie um usuário IAM (ou uma role, se o rclone rodar numa EC2) só com leitura no bucket de origem. Nada de chave de administrador numa VM de migração:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3:ListBucket", "s3:GetBucketLocation"],
      "Resource": "arn:aws:s3:::meu-bucket"
    },
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject"],
      "Resource": "arn:aws:s3:::meu-bucket/*"
    }
  ]
}
E o remote de origem, com a região do bucket:
rclone configCrie o remote aws, tipo s3, provider AWS, região us-east-1 (troque pela real). Para chaves fornecidas pelo administrador, use env_auth=false e informe access key e secret key no assistente, sem colocá-las na linha de comando. Credenciais temporárias também precisam do session token. Teste diretamente o bucket autorizado:
rclone lsf aws:meu-bucket --max-depth 1Se o rclone rodar numa EC2 com instance profile, use env_auth=true e não grave chave nenhuma. Como na parte 1, cifre o rclone.conf com rclone config encryption set depois de configurar todos os remotes. Se houver SSE-KMS, a leitura também pode precisar de kms:Decrypt e autorização na política da chave. Não aumente o IAM só para listar todos os buckets da conta.
Fase 1: inventário
Antes de mover um byte, saiba o que existe. Tamanho total e número de objetos:
rclone size aws:meu-bucket --fast-listA lista completa, com caminho, tamanho, data e classe de armazenamento, num CSV que vai servir de referência na verificação:
rclone lsf -R --files-only --fast-list \
  --format "pstT" --csv \
  aws:meu-bucket > inventario-s3.csv

# objetos por classe de armazenamento
python3 - <<'PYCSV'
import csv
from collections import Counter
with open("inventario-s3.csv", newline="") as f:
    counts = Counter(row[3] or "not-reported" for row in csv.reader(f))
for storage_class, count in sorted(counts.items()):
    print(count, storage_class)
PYCSV
Três coisas que o inventário precisa responder:
- Há objetos nas classes Glacier Flexible Retrieval ou Deep Archive? Sem restauração, o rclone não lê o conteúdo deles: a cópia falha com
Object in GLACIER, restore first. Peça a um operador coms3:RestoreObjectque restaure antes (essa ação não está na credencial somente leitura de migração). Com o remote desse operador autorizado, os comandos são:rclone backend restore aws:meu-bucket/arquivo-morto -o priority=Bulk -o lifetime=7 rclone backend restore-status aws:meu-bucket/arquivo-mortoO prazo depende da classe e da prioridade e pode ultrapassar um dia; aguarde o status de restauração antes da cópia. Glacier Instant Retrieval não exige esse procedimento.
- O bucket tem versionamento? O rclone copia a versão atual de cada objeto. Se o histórico de versões precisa ir junto, isso é um projeto à parte (
--s3-versionslista as versões antigas como arquivos com sufixo de data); para a maioria das migrações, versão atual basta. - Quanto muda por dia? Compare dois inventários com um dia de distância. Isso define quantos deltas serão necessários e quanto tempo dura o congelamento.
Destino A: Google Cloud Storage
Crie o bucket na região certa e com acesso uniforme (permissão pelo IAM do bucket, sem ACL por objeto — é o padrão recomendado pelo Google):
gcloud storage buckets create gs://meu-bucket-gcs \
  --location=southamerica-east1 \
  --default-storage-class=STANDARD \
  --uniform-bucket-level-access
Crie uma service account só para a migração e dê a ela permissão de objetos naquele bucket, não no projeto inteiro:
gcloud iam service-accounts create rclone-migracao \
  --display-name="rclone migracao S3"

gcloud storage buckets add-iam-policy-binding gs://meu-bucket-gcs \
  --member=serviceAccount:rclone-migracao@MEU-PROJETO.iam.gserviceaccount.com \
  --role=roles/storage.objectAdmin
Autenticação sem chave (preferível). Rode o rclone numa VM do Compute Engine com essa service account anexada e escopo OAuth cloud-platform. IAM e escopos da VM precisam permitir a operação; um escopo somente leitura bloqueia uploads mesmo com o papel adequado. O rclone usa as Application Default Credentials da própria VM:
rclone config create gcs gcs \
  env_auth=true \
  bucket_policy_only=true

rclone lsf gcs:meu-bucket-gcs --max-depth 1
Autenticação com chave JSON. Fora do GCP, gere uma chave da service account. Organizações criadas a partir de 3 de maio de 2024 vêm com a política iam.disableServiceAccountKeyCreation ativa por padrão, e o comando abaixo falha até um administrador abrir exceção — mais um motivo para rodar dentro do GCP:
umask 077
mkdir -p "$HOME/.config/rclone"
gcloud iam service-accounts keys create "$HOME/.config/rclone/gcs-migracao.json" \
  --iam-account=rclone-migracao@MEU-PROJETO.iam.gserviceaccount.com
chmod 600 "$HOME/.config/rclone/gcs-migracao.json"

rclone config create gcs gcs \
  service_account_file="$HOME/.config/rclone/gcs-migracao.json" \
  bucket_policy_only=true
Com bucket_policy_only=true o rclone não tenta gravar ACL por objeto, o que daria erro num bucket com acesso uniforme. Terminada a migração, apague a chave (gcloud iam service-accounts keys delete).
Alternativa gerenciada. Para S3 → GCS, o Google tem o Storage Transfer Service, que lê do Amazon S3 sem VM nem agente. Para um bucket único e grande, sem transformação no meio, vale comparar. O rclone ganha quando você quer o mesmo procedimento para GCS e OCI, filtros, relatórios de diferença e controle fino de cada fase.
Destino B: OCI Object Storage
O rclone tem backend nativo para o OCI (oracleobjectstorage), que usa a autenticação da própria Oracle. Você vai precisar do namespace do tenancy (oci os ns get), do OCID do compartment e da região. Crie o bucket:
oci os bucket create \
  --name meu-bucket-oci \
  --compartment-id ocid1.compartment.oc1..aaaa... \
  --storage-tier Standard
Esta policy permite consultar metadados dos buckets do compartment Storage, mas restringe o gerenciamento de objetos ao bucket de migração. Para uma VM, substitua group MigracaoS3 por dynamic-group NomeDoGrupo:
Allow group MigracaoS3 to read buckets in compartment Storage
Allow group MigracaoS3 to manage objects in compartment Storage where target.bucket.name='meu-bucket-oci'
User principal (rclone fora do OCI): o usuário tem uma API key e um arquivo de configuração do OCI, o mesmo que o oci CLI usa. Use rclone config para cadastrar o remote e selecionar o arquivo e o profile. O bloco resultante deve corresponder ao exemplo abaixo, adaptando o caminho e o nome do profile do seu arquivo OCI. Não cole texto INI em um rclone.conf já criptografado: use o assistente.
[oci]
type = oracleobjectstorage
provider = user_principal_auth
namespace = meunamespace
compartment = ocid1.compartment.oc1..aaaa...
region = sa-saopaulo-1
config_file = /etc/rclone/oci/config
config_profile = MIGRACAO
Instance principal (rclone numa VM do OCI, preferível): a VM entra num dynamic group, a policy é dada ao dynamic group, e nenhuma chave fica em disco:
rclone config create oci oracleobjectstorage \
  provider=instance_principal_auth \
  namespace=meunamespace \
  compartment=ocid1.compartment.oc1..aaaa... \
  region=sa-saopaulo-1

rclone lsf oci:meu-bucket-oci --max-depth 1
Alternativa pela API compatível com S3. O OCI também expõe uma API compatível com S3, com Customer Secret Keys (par access/secret gerado no console) e endpoint no formato https://<namespace>.compat.objectstorage.<região>.oci.customer-oci.com. Serve para aplicações que já falam S3 — útil na virada — mas para a migração prefira o backend nativo. Um detalhe: buckets criados pela API S3 vão para o compartment raiz, a menos que você defina outro compartment padrão para ela.
Fase 2: cópia em massa
Com as aplicações ainda gravando no S3, faça a primeira cópia completa. Use copy, não sync: nesta fase nada deve ser apagado no destino. Ensaie antes com --dry-run e rode dentro de um tmux (ou screen), porque vai demorar:
tmux new -s migracao

rclone copy aws:meu-bucket gcs:meu-bucket-gcs \
  --transfers 32 \
  --checkers 64 \
  --fast-list \
  --order-by size,descending \
  --log-file "$HOME/rclone-migracao/logs"/migracao-copy.log \
  --log-level INFO \
  --stats 1m --stats-one-line
Para o OCI, troque só o destino: oci:meu-bucket-oci. O que cada flag faz aqui:
--transfers 32 --checkers 64: bem acima do padrão (4 e 8). São valores ilustrativos, não uma garantia: banda, memória, CPU e quotas das APIs limitam o resultado. Suba aos poucos olhando o log.--fast-list: lista o bucket em menos chamadas de API. Gasta mais memória (a listagem inteira fica em RAM), economiza tempo e requisições cobradas.--order-by size,descending: começa pelos objetos grandes, que ocupam a banda de forma estável, e deixa a cauda de arquivos pequenos para o fim.--log-file: a prova do que foi copiado. Guarde.
Se a cópia cair no meio — rede, reinício da VM, fim da sessão —, rode o mesmo comando de novo. O rclone compara tamanho e data e só copia o que falta; não recomeça do zero.
Fase 3: deltas até o atraso ficar pequeno
Enquanto a cópia em massa rodava, as aplicações continuaram gravando no S3. Repita o mesmo copy: agora ele só transfere objetos novos ou alterados. As rodadas só tendem a encurtar quando a capacidade de cópia supera a taxa de alterações na origem. Para rodadas intermediárias em buckets muito grandes, limite a comparação ao que mudou recentemente:
rclone copy aws:meu-bucket gcs:meu-bucket-gcs \
  --max-age 2d \
  --transfers 32 --checkers 64 --fast-list \
  --log-file "$HOME/rclone-migracao/logs"/migracao-delta.log --log-level INFO
--max-age filtra pela data de modificação do objeto, que pode vir do metadado X-Amz-Meta-Mtime, não necessariamente da data do upload. Um objeto recém-enviado pode preservar uma data antiga e ficar fora do filtro. Use uma janela maior que o intervalo entre as rodadas e, antes do congelamento, faça uma rodada sem o filtro para pegar qualquer coisa que tenha escapado. Quando um delta completo levar poucos minutos, está na hora da fase 4.
Fase 4: congelamento e sync final
Pare as gravações no S3: coloque a aplicação em manutenção, pare os workers de upload ou tire temporariamente a permissão de escrita no bucket. Mantenha o destino sem escritores de aplicação também. Então ensaie e rode um sync, que além de copiar o que falta apaga no destino o que foi removido na origem desde a cópia em massa:
# Primeiro simule e revise especialmente as exclusões:
rclone sync aws:meu-bucket gcs:meu-bucket-gcs \
  --transfers 32 --checkers 64 --fast-list \
  --max-delete 1000 \
  --log-file "$HOME/rclone-migracao/logs"/migracao-final.log --log-level INFO \
  --dry-run

# Só após revisar: repita o comando acima removendo --dry-run.
O --max-delete é a trava da parte 1 aplicada aqui: se o sync quiser apagar mais do que o esperado — origem trocada por engano, credencial apontando para o bucket errado —, ele para. Ajuste o número ao que o inventário e os deltas indicam. Esse limite não torna o sync uma transação e não desfaz alterações já feitas. Exija término com código zero e investigue qualquer erro antes de avançar.
Fase 5: verificação
Depois do sync, rode check sem --one-way: queremos encontrar tanto objetos faltando quanto sobras no destino. Ele verifica tamanho e hashes disponíveis; não é prova de igualdade de conteúdo quando não existe um hash utilizável nos dois lados.
if rclone check aws:meu-bucket gcs:meu-bucket-gcs \
  --fast-list \
  --differ "$HOME/rclone-migracao/logs/check-diferentes.txt" \
  --missing-on-dst "$HOME/rclone-migracao/logs/check-faltando.txt" \
  --missing-on-src "$HOME/rclone-migracao/logs/check-sobrando.txt" \
  --error "$HOME/rclone-migracao/logs/check-erros.txt"; then
  echo "Check concluído; revise também o resumo de hashes no log."
else
  echo "FALHA: não faça a virada; examine erros e diferenças." >&2
fi
Avance somente com código de saída zero, relatórios sem diferenças e sem erros. Relatórios vazios isoladamente não bastam. MD5 pode estar indisponível em objetos multipart ou cifrados; o rclone também pode encontrar um MD5 adicional nos metadados de objetos enviados por ele. Sem hash comum, a comparação pode se limitar ao tamanho.
Para conferir o conteúdo de um prefixo crítico, use:
rclone check aws:meu-bucket/pasta-critica gcs:meu-bucket-gcs/pasta-critica \
  --download
--download lê o conteúdo nas duas pontas e pode gerar egress em ambos os provedores. Uma amostra valida somente a amostra. Se o requisito é conferir todo o conteúdo sem hashes comuns, planeje a leitura integral, seu custo e sua duração; não encerre a janela de manutenção enquanto a validação exigida estiver pendente.
Com as gravações ainda congeladas, gere inventários novos de origem e destino e compare caminho e tamanho usando um parser CSV (nomes com vírgulas ou quebras de linha não podem ser tratados com cut):
rclone lsf -R --files-only --fast-list --format "ps" --csv aws:meu-bucket > inventario-origem-final.csv
rclone lsf -R --files-only --fast-list --format "ps" --csv gcs:meu-bucket-gcs > inventario-destino.csv

python3 - <<'PYCSV'
import csv
from collections import Counter

def load(path):
    with open(path, newline="") as f:
        return Counter((row[0], int(row[1])) for row in csv.reader(f))

src = load("inventario-origem-final.csv")
dst = load("inventario-destino.csv")
if src != dst:
    raise SystemExit("Inventários diferentes: não faça a virada")
print("Inventários batem em caminho e tamanho; isso não substitui hashes")
PYCSV
Interrompa também se qualquer comando de inventário falhar; não compare arquivos parciais. O parser carrega os inventários em memória: para milhões de objetos, dimensione a RAM ou faça a comparação em banco de dados.
O que chega e o que não chega no destino
| Item | GCS | OCI |
|---|---|---|
| Conteúdo e nome do objeto | Sim | Sim |
Content-Type |
Sim | Sim |
| Data de modificação | Sim (metadado mtime) |
Sim (metadado opc-meta-mtime) |
Metadados customizados x-amz-meta-* |
Não | Não |
| ACLs, bucket policy, lifecycle, versões antigas | Não — recriar | Não — recriar |
| Classe de armazenamento | Não — definir no destino | Não — definir no destino |
Os metadados customizados são o ponto que mais surpreende. O rclone sabe ler os metadados do S3 (-M/--metadata), mas na versão 1.75.1 os backends de GCS e de OCI não gravam metadados arbitrários por esse mecanismo. Se a aplicação depende de x-amz-meta-* — um hash próprio, um ID de usuário —, exporte antes com rclone lsjson aws:meu-bucket -R --files-only --metadata > metadados-origem.json, e trate a migração desses campos à parte, ou mude a aplicação para não depender deles.
A classe de armazenamento também não é copiada: tudo chega na classe padrão do bucket ou na que você passar. Para mandar um prefixo de arquivo morto direto para uma classe barata, faça essa parte num comando separado com --gcs-storage-class ARCHIVE (GCS) ou --oos-storage-tier Archive (OCI) — e lembre que a leitura dessas classes tem custo e, no OCI Archive, tempo de restauração.
Fase 6: virada das aplicações
Com a verificação limpa, aponte as aplicações para o novo bucket. O tamanho da mudança depende de como elas falam com o storage:
- SDK nativo do provedor: troque o cliente S3 pelo do GCS ou do OCI. É o caminho mais limpo, e o mais trabalhoso.
- Continuar falando S3: o GCS aceita chamadas no formato S3 em
https://storage.googleapis.comcom chaves HMAC (a documentação do rclone, no backend S3, tem o providerGCSpara isso), e o OCI tem a API compatível com S3 citada acima. A troca pode se limitar a endpoint, região e credenciais, mas não assuma compatibilidade completa do SDK ou de todos os recursos. Teste as operações que a aplicação usa — URLs pré-assinadas, multipart, listagem com prefixo — porque compatível não significa idêntico. - CDN e URLs públicas: se o bucket servia arquivos por URL direta ou atrás de CloudFront, a origem do CDN e os links publicados também mudam. Planeje redirecionamentos.
Depois da virada, deixe o bucket do S3 somente leitura por alguns dias ou semanas. Rollback não é apenas repontar. Depois de aceitar gravações no novo provedor, o S3 estará desatualizado. Para voltar, congele os escritores novamente, reconcilie criações, alterações e exclusões ocorridas após a virada e valide os dados antes de reabrir o S3 para escrita. Defina previamente quem faz essa reconciliação, as permissões temporárias necessárias e o tratamento de conflitos. Não execute um sync reverso às cegas. Só apague o S3 quando o novo bucket tiver passado por um ciclo completo de uso — e lembre de encerrar a credencial IAM, a chave da service account e o usuário do OCI criados para a migração.
Checklist
- Pedido de isenção de egress aberto no suporte da AWS (se aplicável) antes da primeira cópia.
- Inventário com contagem, tamanho e classes; objetos Glacier restaurados.
- Credencial de origem somente leitura; credencial de destino restrita ao bucket.
- VM de migração na região certa, com banda suficiente e
tmux. copyem massa → deltas → congelamento →synccom--max-delete.checkbidirecional com código zero, sem erros ou diferenças;--downloadno escopo exigido; inventários finais comparados.- Políticas, lifecycle, CORS e permissões recriados no destino.
- Aplicações repontadas; S3 em somente leitura; rollback com reconciliação definido; credenciais temporárias revogadas ao encerrar.
Fechando
Trocar de provedor de object storage é, no fundo, copiar muitos arquivos com cuidado — e isso o rclone faz bem. O trabalho de verdade está em volta: pedir a isenção de egress, restaurar o Glacier, aceitar que metadados customizados e configurações de bucket não viajam sozinhos, e manter o S3 intacto até o novo destino provar que funciona. O mesmo roteiro serve para GCS e OCI; muda uma linha de remote. Se você ainda não usa o rclone, comece pela parte 1. E se o seu próximo passo é armazenar logs e métricas nesses buckets, o OpenObserve com S3, GCS e OCI mostra o outro lado.