En la parte 1, rclone llevó archivos del servidor a la nube. Aquí lleva una nube a otra: buckets de Amazon S3 migrados al Google Cloud Storage (GCS) o al OCI Object Storage, de Oracle. El proceso es el mismo para ambos destinos — solo cambia el remoto de destino — y se montó para migrar sin una ventana larga de parada: copia masiva con las aplicaciones todavía en S3, deltas hasta que el desfase sea pequeño, congelación corta, verificación y cambio.
Los comandos usan rclone 1.75.1. El flujo de copia, delta, sync final y verificación se ensayó de principio a fin contra un S3 local (el propio rclone serve s3); la sintaxis de los remotos de GCS y OCI se comprobó en el binario y en la documentación de los proveedores. No hubo pruebas contra cuentas reales de AWS, GCP u OCI. Las cuentas reales tienen límites, políticas y cuotas propios — haz un ensayo con un bucket pequeño antes del grande.
Antes de empezar: coste, lugar y alcance
Coste. Lo que más pesa en una migración fuera de AWS es la salida de datos: AWS cobra por GB transferido desde S3 hacia internet. Desde marzo de 2024 existe un programa que exime ese cobro a quienes están saliendo de AWS, pero no es automático: hay que abrir un ticket en el soporte, la aprobación es por cuenta y el plazo para completar la migración es de 90 días (anuncio oficial). Pídelo antes de empezar, no después de la factura. Suma las peticiones de listado, lectura y escritura (LIST, GET, HEAD e PUT), la recuperación de clases frías, la VM y el posible tráfico de salida del destino en la comprobación. Muchos objetos pequeños pueden hacer que el coste de las peticiones sea relevante; calcula para tus regiones y clases.
Sitio. En una copia entre proveedores diferentes no existe “copia server-side”: cada objeto sale de S3, pasa por la memoria de la máquina que ejecuta rclone y se escribe en el destino. El contenido de los objetos se envía sin necesidad de almacenar el bucket en el disco local; los logs y los inventarios quedan en disco. El ancho de banda, la CPU y los límites de las APIs pueden restringir la transferencia. Ejecuta rclone en una VM cerca de uno de los extremos —una instancia en GCP o en OCI en la misma región del bucket de destino es lo más práctico, porque permite autenticarse sin clave en un archivo (ver más abajo)— y no en el portátil de casa.
Alcance. rclone migra objetos: contenido, nombre, Content-Type y fecha de modificación. Las políticas del bucket, ACLs, reglas de ciclo de vida, versionado, notificaciones de eventos y replicación son configuración del bucket y deben recrearse en el destino, en el lenguaje de cada proveedor. Enumere esto al principio para no descubrirlo en el cambio.
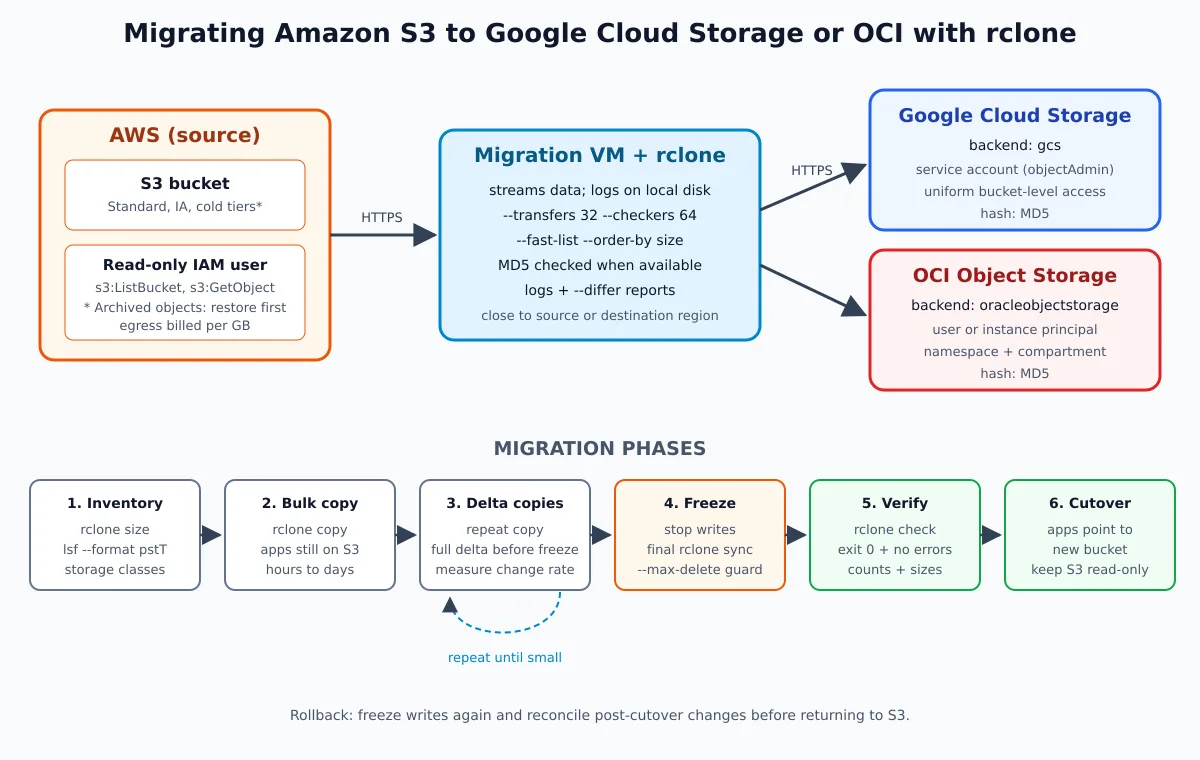
Arquitectura y fases de la migración
La VM con rclone lee desde S3 con un usuario IAM de solo lectura y escribe en el destino con una credencial de objetos restringida al bucket de destino. La migración pasa por seis fases: inventario, copia masiva, deltas repetidos, congelación con sincronización final, verificación y cambio de las aplicaciones. El bucket de S3 permanece intacto y de solo lectura hasta que el nuevo esté validado en producción: es su plan de vuelta.
Preparar la VM de migración
Instale rclone según la parte 1, además de tmux y Python 3. Los ejemplos siguientes usan Bash y nombres de buckets ilustrativos: sustituya nombres, proyecto, namespace, compartment y regiones. La creación de buckets, cuentas y políticas requiere una identidad administrativa separada; el proceso de copia utiliza únicamente los permisos restringidos que se presentan más adelante. Instale y autentique la CLI del destino elegido antes de los pasos de aprovisionamiento.
umask 077
mkdir -p "$HOME/rclone-migracao/logs" "$HOME/.config/rclone"
cd "$HOME/rclone-migracao"
rclone version
Todos los archivos de inventario e informes se generarán en ese directorio. No coloque claves en repositorios, en el historial del shell ni en argumentos visibles en la lista de procesos.
Origen: credencial de solo lectura en AWS
Cree un usuario IAM (o un rol, si rclone se ejecuta en una EC2) solo con lectura en el bucket de origen. Nada de clave de administrador en una VM de migración:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3:ListBucket", "s3:GetBucketLocation"],
      "Resource": "arn:aws:s3:::meu-bucket"
    },
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject"],
      "Resource": "arn:aws:s3:::meu-bucket/*"
    }
  ]
}
Y el remote de origen, con la región del bucket:
rclone configCree el remote aws, tipo s3, proveedor AWS, región us-east-1 (cámbiala por la real). Para claves proporcionadas por el administrador, usa env_auth=false e introduzca la access key y la secret key en el asistente, sin ponerlas en la línea de comandos. Las credenciales temporales también necesitan el session token. Pruebe directamente el bucket autorizado:
rclone lsf aws:meu-bucket --max-depth 1Si rclone se ejecuta en una EC2 con instance profile, usa env_auth=true y no guarde ninguna clave. Como en la parte 1, cifre el rclone.conf con rclone config encryption set después de configurar todos los remotos. Si hay SSE-KMS, la lectura también puede requerir kms:Decrypt y autorización en la política de la clave. No amplíe el IAM solo para listar todos los buckets de la cuenta.
Fase 1: inventario
Antes de mover un solo byte, sepa lo que existe. Tamaño total y número de objetos:
rclone size aws:meu-bucket --fast-listLa lista completa, con ruta, tamaño, fecha y clase de almacenamiento, número CSV que servirá de referencia en la verificación:
rclone lsf -R --files-only --fast-list \
  --format "pstT" --csv \
  aws:meu-bucket > inventario-s3.csv

# objetos por classe de armazenamento
python3 - <<'PYCSV'
import csv
from collections import Counter
with open("inventario-s3.csv", newline="") as f:
    counts = Counter(row[3] or "not-reported" for row in csv.reader(f))
for storage_class, count in sorted(counts.items()):
    print(count, storage_class)
PYCSV
Tres cosas que el inventario debe responder:
- ¿Hay objetos en las clases Glacier Flexible Retrieval o Deep Archive? Sin restauración, rclone no lee su contenido: la copia falla con
Object in GLACIER, restore first. Pide a un operador cons3:RestoreObjectque restaure antes (esa acción no está en la credencial de sólo lectura de migración). Con el remoto de ese operador autorizado, los comandos son:rclone backend restore aws:meu-bucket/arquivo-morto -o priority=Bulk -o lifetime=7 rclone backend restore-status aws:meu-bucket/arquivo-mortoEl plazo depende de la clase y de la prioridad y puede superar un día; espera al estado de restauración antes de la copia. Glacier Instant Retrieval no requiere este procedimiento.
- ¿El bucket tiene versionado? rclone copia la versión actual de cada objeto. Si el historial de versiones debe ir junto, eso es un proyecto aparte (
--s3-versionslista las versiones antiguas como archivos con sufijo de fecha); para la mayoría de las migraciones, la versión actual es suficiente. - ¿Cuánto cambia por día? Compara dos inventarios con un día de diferencia. Esto define cuántos deltas serán necesarios y cuánto dura la congelación.
Destino A: Google Cloud Storage
Crea el bucket en la región correcta y con acceso uniforme (permiso mediante la IAM del bucket, sin ACL por objeto: es el estándar recomendado por Google):
gcloud storage buckets create gs://meu-bucket-gcs \
  --location=southamerica-east1 \
  --default-storage-class=STANDARD \
  --uniform-bucket-level-access
Crea una cuenta de servicio solo para la migración y concédele permiso de objetos en ese bucket, no en todo el proyecto:
gcloud iam service-accounts create rclone-migracao \
  --display-name="rclone migracao S3"

gcloud storage buckets add-iam-policy-binding gs://meu-bucket-gcs \
  --member=serviceAccount:rclone-migracao@MEU-PROJETO.iam.gserviceaccount.com \
  --role=roles/storage.objectAdmin
Autenticación sin clave (preferible). Ejecuta rclone en una VM de Compute Engine con esa cuenta de servicio adjunta y alcance OAuth cloud-platform. La IAM y los alcances de la VM deben permitir la operación; un alcance de solo lectura bloquea las subidas incluso con el rol adecuado. rclone usa las Application Default Credentials de la propia VM:
rclone config create gcs gcs \
  env_auth=true \
  bucket_policy_only=true

rclone lsf gcs:meu-bucket-gcs --max-depth 1
Autenticación con clave JSON. Fuera de GCP, genera una clave de la cuenta de servicio. Las organizaciones creadas a partir del 3 de mayo de 2024 vienen con la política iam.disableServiceAccountKeyCreation activa por defecto, y el comando siguiente falla hasta que un administrador abra una excepción, otro motivo para ejecutarlo dentro de GCP:
umask 077
mkdir -p "$HOME/.config/rclone"
gcloud iam service-accounts keys create "$HOME/.config/rclone/gcs-migracao.json" \
  --iam-account=rclone-migracao@MEU-PROJETO.iam.gserviceaccount.com
chmod 600 "$HOME/.config/rclone/gcs-migracao.json"

rclone config create gcs gcs \
  service_account_file="$HOME/.config/rclone/gcs-migracao.json" \
  bucket_policy_only=true
Con bucket_policy_only=true rclone no intenta escribir ACL por objeto, lo que daría error en un bucket con acceso uniforme. Terminada la migración, elimina la clave (gcloud iam service-accounts keys delete).
Alternativa gestionada. Para S3 → GCS, Google tiene el Storage Transfer Service, que lee desde Amazon S3 sin VM ni agente. Para un bucket único y grande, sin transformación intermedia, vale la pena comparar. rclone gana cuando quieres el mismo procedimiento para GCS y OCI, filtros, informes de diferencias y control fino de cada fase.
Destino B: OCI Object Storage
rclone tiene backend nativo para OCI (oracleobjectstorage,), que usa la autenticación propia de Oracle. Necesitarás el namespace del tenancy (oci os ns get,), del OCID del compartment y de la región. Crea el bucket:
oci os bucket create \
  --name meu-bucket-oci \
  --compartment-id ocid1.compartment.oc1..aaaa... \
  --storage-tier Standard
Esta policy permite consultar metadados de los buckets del compartment Storage, pero restringe la gestión de objetos al bucket de migración. Para una VM, sustituya group MigracaoS3 por dynamic-group NomeDoGrupo:
Allow group MigracaoS3 to read buckets in compartment Storage
Allow group MigracaoS3 to manage objects in compartment Storage where target.bucket.name='meu-bucket-oci'
User principal (rclone fuera de OCI): el usuario tiene una API key y un archivo de configuración de OCI, el mismo que el oci CLI utiliza. Use rclone config para registrar el remote y seleccionar el archivo y el profile. El bloque resultante debe coincidir con el ejemplo de abajo, adaptando la ruta y el nombre del profile de su archivo OCI. No pegue texto INI en un rclone.conf ya cifrado: use el asistente.
[oci]
type = oracleobjectstorage
provider = user_principal_auth
namespace = meunamespace
compartment = ocid1.compartment.oc1..aaaa...
region = sa-saopaulo-1
config_file = /etc/rclone/oci/config
config_profile = MIGRACAO
Instance principal (rclone en una VM de OCI, preferible): la VM entra en un dynamic group, la policy se concede al dynamic group y ninguna clave queda en disco:
rclone config create oci oracleobjectstorage \
  provider=instance_principal_auth \
  namespace=meunamespace \
  compartment=ocid1.compartment.oc1..aaaa... \
  region=sa-saopaulo-1

rclone lsf oci:meu-bucket-oci --max-depth 1
Alternativa mediante la API compatible con S3. OCI también expone una API compatible con S3, con Customer Secret Keys (par access/secret generado en la consola) y endpoint en el formato https://<namespace>.compat.objectstorage.<região>.oci.customer-oci.com. Sirve para aplicaciones que ya hablan S3 — útil en el cambio — pero para la migración prefiere el backend nativo. Un detalle: los buckets creados por la API S3 van al compartment raíz, a menos que defina otro compartment predeterminado para ella.
Fase 2: copia masiva
Con las aplicaciones todavía escribiendo en S3, haz la primera copia completa. Usa copy, no sync: en esta fase no se debe borrar nada en el destino. Ensaya antes con --dry-run y ejecútalo dentro de un tmux (o screen), porque va a tardar:
tmux new -s migracao

rclone copy aws:meu-bucket gcs:meu-bucket-gcs \
  --transfers 32 \
  --checkers 64 \
  --fast-list \
  --order-by size,descending \
  --log-file "$HOME/rclone-migracao/logs"/migracao-copy.log \
  --log-level INFO \
  --stats 1m --stats-one-line
Para OCI, cambia solo el destino: oci:meu-bucket-oci. Lo que hace cada flag aquí:
--transfers 32 --checkers 64: muy por encima del estándar (4 y 8). Son valores ilustrativos, no una garantía: el ancho de banda, la memoria, la CPU y las cuotas de las APIs limitan el resultado. Sube poco a poco mirando el log.--fast-list: lista el bucket en menos llamadas a la API. Gasta más memoria (el listado entero queda en RAM), ahorra tiempo y solicitudes cobradas.--order-by size,descending: empieza por los objetos grandes, que ocupan el ancho de banda de forma estable, y deja la cola de archivos pequeños para el final.--log-file: la prueba de lo que se copió. Guárdala.
Si la copia se cae a la mitad — red, reinicio de la VM, fin de la sesión —, ejecuta el mismo comando otra vez. rclone compara tamaño y fecha y solo copia lo que falta; no empieza desde cero.
Fase 3: deltas hasta que el retraso sea pequeño
Mientras la copia masiva se ejecutaba, las aplicaciones siguieron escribiendo en S3. Repita lo mismo copy: ahora solo transfiere objetos nuevos o modificados. Las rondas solo tienden a acortarse cuando la capacidad de copia supera la tasa de cambios en el origen. Para rondas intermedias en buckets muy grandes, limite la comparación a lo que cambió recientemente:
rclone copy aws:meu-bucket gcs:meu-bucket-gcs \
  --max-age 2d \
  --transfers 32 --checkers 64 --fast-list \
  --log-file "$HOME/rclone-migracao/logs"/migracao-delta.log --log-level INFO
--max-age filtra por la fecha de modificación del objeto, que puede venir del metadato X-Amz-Meta-Mtime, no necesariamente de la fecha de subida. Un objeto recién subido puede conservar una fecha antigua y quedar fuera del filtro. Use una ventana mayor que el intervalo entre rondas y, antes de la congelación, haga una ronda sin el filtro para capturar cualquier cosa que se haya escapado. Cuando un delta completo tarda pocos minutos, es el momento de la fase 4.
Fase 4: congelación y sincronización final
Detenga las escrituras en S3: ponga la aplicación en mantenimiento, pare los workers de subida o retire temporalmente el permiso de escritura en el bucket. Mantenga también el destino sin escritores de aplicación. Luego ensaye y ejecute un sync, que además de copiar lo que falta borra en el destino lo que se haya eliminado en el origen desde la copia masiva:
# Primeiro simule e revise especialmente as exclusões:
rclone sync aws:meu-bucket gcs:meu-bucket-gcs \
  --transfers 32 --checkers 64 --fast-list \
  --max-delete 1000 \
  --log-file "$HOME/rclone-migracao/logs"/migracao-final.log --log-level INFO \
  --dry-run

# Só após revisar: repita o comando acima removendo --dry-run.
O --max-delete es el bloqueo de la parte 1 aplicada aquí: si el sync pretende borrar más de lo esperado — origen cambiado por error, credencial apuntando al bucket equivocado —, se detiene. Ajuste el número a lo que indican el inventario y los deltas. Ese límite no convierte al sync en una transacción y no deshace cambios ya realizados. Exija finalización con código cero e investigue cualquier error antes de avanzar.
Fase 5: verificación
Después del sync, ejecute check sin --one-way: queremos encontrar tanto objetos faltantes como sobrantes en el destino. Verifica tamaño y hashes disponibles; no es prueba de igualdad de contenido cuando no existe un hash utilizable en ambos lados.
if rclone check aws:meu-bucket gcs:meu-bucket-gcs \
  --fast-list \
  --differ "$HOME/rclone-migracao/logs/check-diferentes.txt" \
  --missing-on-dst "$HOME/rclone-migracao/logs/check-faltando.txt" \
  --missing-on-src "$HOME/rclone-migracao/logs/check-sobrando.txt" \
  --error "$HOME/rclone-migracao/logs/check-erros.txt"; then
  echo "Check concluído; revise também o resumo de hashes no log."
else
  echo "FALHA: não faça a virada; examine erros e diferenças." >&2
fi
Avance solo con código de salida cero, informes sin diferencias y sin errores. Los informes vacíos por sí solos no bastan. MD5 puede no estar disponible en objetos multipart o cifrados; rclone también puede encontrar un MD5 adicional en los metadatos de objetos subidos por él. Sin un hash común, la comparación puede limitarse al tamaño.
Para comprobar el contenido de un prefijo crítico, use:
rclone check aws:meu-bucket/pasta-critica gcs:meu-bucket-gcs/pasta-critica \
  --download
--download lee el contenido en ambos extremos y puede generar egress en ambos proveedores. Una muestra solo valida la muestra. Si el requisito es comprobar todo el contenido sin hashes comunes, planifique la lectura completa, su coste y su duración; no cierre la ventana de mantenimiento mientras la validación exigida esté pendiente.
Con las escrituras aún congeladas, genere inventarios nuevos de origen y destino y compare ruta y tamaño usando un parser CSV (los nombres con comas o saltos de línea no se pueden tratar con cut):
rclone lsf -R --files-only --fast-list --format "ps" --csv aws:meu-bucket > inventario-origem-final.csv
rclone lsf -R --files-only --fast-list --format "ps" --csv gcs:meu-bucket-gcs > inventario-destino.csv

python3 - <<'PYCSV'
import csv
from collections import Counter

def load(path):
    with open(path, newline="") as f:
        return Counter((row[0], int(row[1])) for row in csv.reader(f))

src = load("inventario-origem-final.csv")
dst = load("inventario-destino.csv")
if src != dst:
    raise SystemExit("Inventários diferentes: não faça a virada")
print("Inventários batem em caminho e tamanho; isso não substitui hashes")
PYCSV
Deténgase también si cualquier comando de inventario falla; no compare archivos parciales. El parser carga los inventarios en memoria: para millones de objetos, dimensione la RAM o haga la comparación en una base de datos.
Lo que llega y lo que no llega al destino
| Ítem | GCS | OCI |
|---|---|---|
| Contenido y nombre del objeto | Sí | Sí |
Content-Type |
Sí | Sí |
| Fecha de modificación | Sí (metadato mtime) |
Sí (metadato opc-meta-mtime) |
Metadatos personalizados x-amz-meta-* |
No | No |
| ACLs, bucket policy, lifecycle, versiones antiguas | No — recrear | No — recrear |
| Clase de almacenamiento | No — definir en el destino | No — definir en el destino |
Los metadatos personalizados son el punto que más sorprende. rclone sabe leer los metadatos de S3 (-M/--metadata), pero en la versión 1.75.1 los backends de GCS y de OCI no escriben metadatos arbitrarios mediante ese mecanismo. Si la aplicación depende de x-amz-meta-* — un hash propio, una ID de usuario —, expórtalos antes con rclone lsjson aws:meu-bucket -R --files-only --metadata > metadados-origem.json, y trata la migración de esos campos por separado, o cambia la aplicación para que no dependa de ellos.
La clase de almacenamiento tampoco se copia: todo llega a la clase predeterminada del bucket o a la que indiques. Para enviar un prefijo de archivo muerto directamente a una clase barata, haz esa parte en un comando aparte con --gcs-storage-class ARCHIVE (GCS) o --oos-storage-tier Archive (OCI) — y recuerda que la lectura de esas clases tiene coste y, en OCI Archive, tiempo de restauración.
Fase 6: cambio de las aplicaciones al nuevo destino
Con la verificación limpia, apunta las aplicaciones al nuevo bucket. El alcance del cambio depende de cómo hablan con el storage:
- SDK nativo del proveedor: cambia el cliente S3 por el de GCS o el de OCI. Es el camino más limpio y el más laborioso.
- Continuar hablando S3: GCS acepta llamadas en formato S3 en
https://storage.googleapis.comcon claves HMAC (la documentación de rclone, en el backend S3, tiene el providerGCSpara ello), y OCI dispone de la API compatible con S3 mencionada anteriormente. El cambio puede limitarse a endpoint, región y credenciales, pero no asumas compatibilidad completa del SDK ni de todas las funcionalidades. Prueba las operaciones que utiliza la aplicación — URLs prefirmadas, multipart, listado con prefijo — porque compatible no significa idéntico. - CDN y URLs públicas: si el bucket servía archivos mediante URL directa o detrás de CloudFront, el origen del CDN y los enlaces publicados también cambian. Planifica redirecciones.
Después del cambio, deja el bucket de S3 solo lectura durante unos días o semanas. La reversión no consiste solo en reapuntar. Tras aceptar escrituras en el nuevo proveedor, el S3 quedará desactualizado. Para volver, congela de nuevo a los escritores, reconcilia creaciones, modificaciones y borrados ocurridos tras el cambio y valida los datos antes de reabrir el S3 a escritura. Define previamente quién hace esa reconciliación, los permisos temporales necesarios y el tratamiento de conflictos. No ejecutes un sync inverso a ciegas. Solo borra el S3 cuando el nuevo bucket haya pasado por un ciclo completo de uso — y recuerda dar de baja la credencial IAM, la clave de la service account y el usuario de OCI creados para la migración.
Checklist
- Solicitud de exención de egress abierta en el soporte de AWS (si procede) antes de la primera copia.
- Inventario con recuento, tamaño y clases; objetos Glacier restaurados.
- Credencial de origen solo lectura; credencial de destino restringida al bucket.
- VM de migración en la región adecuada, con ancho de banda suficiente y
tmux. copymasiva → deltas → congelación →synccon--max-delete.checkbidireccional con código cero, sin errores ni diferencias;--downloaden el alcance exigido; inventarios finales comparados.- Políticas, lifecycle, CORS y permisos recreados en el destino.
- Aplicaciones re-apuntadas; S3 en solo lectura; rollback con reconciliación definido; credenciales temporales revocadas al cerrar.
Cerrando
Cambiar de proveedor de object storage es, en el fondo, copiar muchos archivos con cuidado — y eso el rclone lo hace bien. El trabajo de verdad está alrededor: pedir la exención de egress, restaurar el Glacier, aceptar que los metadatos personalizados y las configuraciones de bucket no viajan solos, y mantener el S3 intacto hasta que el nuevo destino demuestre que funciona. El mismo guion sirve para GCS y OCI; cambia una línea de remote. Si todavía no usas rclone, empieza por la parte 1. Y si tu siguiente paso es almacenar logs y métricas en esos buckets, el OpenObserve con S3, GCS y OCI muestra el otro lado.