Uma plataforma de logs deveria ajudar a resolver incidentes, não se tornar o incidente mais frequente da equipe. Quando o Elasticsearch consome uma parcela importante do orçamento e manter índices, retenção e capacidade exige atenção constante, o OpenObserve merece entrar na avaliação. Seus principais atrativos são uma arquitetura orientada a armazenamento de objetos, uma interface integrada para telemetria e um caminho simples para começar em um único servidor.
Isso não significa que “OpenObserve é sempre melhor que ELK”, nem que Kibana seja apenas um visualizador descartável. A escolha envolve dados, consultas, integrações, segurança e maturidade operacional. Neste comparativo, vamos separar benefícios reais, limitações e um roteiro de prova de conceito. Não executamos um benchmark comparativo neste artigo; as características foram conferidas na documentação dos projetos, e as recomendações de avaliação são propostas para o seu ambiente.
Primeiro: OpenObserve não compete apenas com Kibana
ELK é a sigla histórica de Elasticsearch, Logstash e Kibana: armazenamento/pesquisa, processamento de eventos e exploração visual. Hoje, uma implantação Elastic pode usar Elastic Agent, OpenTelemetry e outros caminhos de ingestão, sem necessariamente incluir Logstash. Também pode ser autogerenciada, gerenciada ou Serverless.
O OpenObserve combina ingestão, pesquisa, visualização e alertas voltados a logs, métricas e traces. Portanto, a comparação útil é entre soluções completas de observabilidade, não entre um backend e uma tela. Para conhecer primeiro a plataforma, veja nosso guia de OpenObserve. Para o lado Elastic, consulte a documentação de OpenTelemetry.
Onde estão os benefícios mais interessantes do OpenObserve
| Benefício potencial | Por que interessa | O que precisa ser provado |
|---|---|---|
| Retenção com object storage | Abre espaço para manter histórico sem concentrar todo o custo em discos de nós de busca. | Custo total, consultas ao histórico, tráfego e restauração. |
| Entrada simples | Uma implantação single-node facilita laboratório e adoção inicial. | Limites de capacidade, indisponibilidade aceitável e caminho de crescimento. |
| Interface integrada | Pesquisa e visualização no mesmo produto reduzem a montagem inicial. | Os dashboards e investigações que a equipe realmente utiliza. |
| SQL na investigação | Aproveita conhecimento existente de filtros e agregações. | Equivalência de funções, tipos, precisão e desempenho das consultas. |
| Coleta desacoplada | Padrões e coletores permitem avaliar outro destino sem reescrever toda a aplicação. | Compatibilidade de protocolos, atributos, filas e política de repetição. |
A palavra “potencial” importa: economizar armazenamento enquanto se perde uma investigação crítica não é uma melhoria. A decisão precisa considerar o serviço prestado à equipe, não apenas a quantidade de componentes instalados.
Arquitetura: por que o armazenamento muda a conversa
No OpenObserve, dados analíticos podem ser persistidos em Parquet no armazenamento de objetos. Single-node pode usar SQLite e disco local ou object storage. O desenho HA documentado usa Kubernetes/Helm e acrescenta PostgreSQL para metadados, NATS para coordenação e papéis separados de ingestão, consulta, roteamento, compactação e agendamento. Arquitetura oficial do OpenObserve.
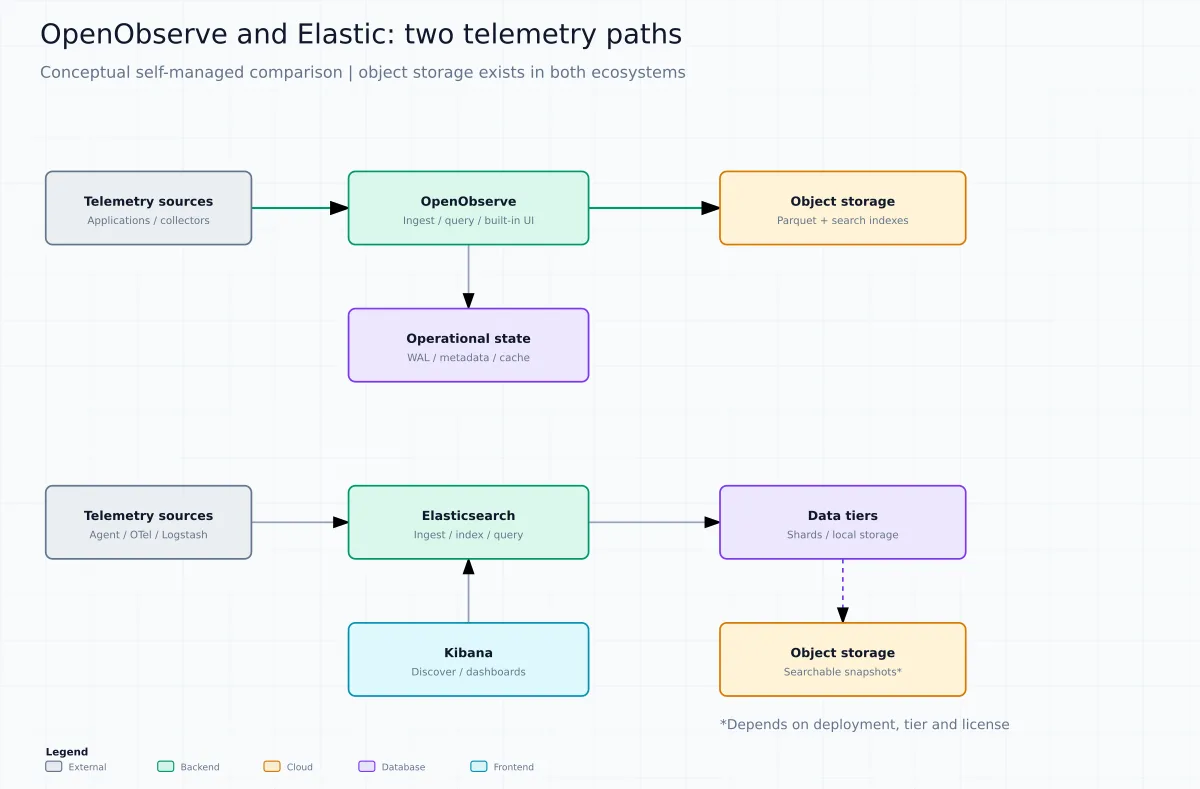
Não é “tudo sem estado”. Os ingesters mantêm dados em memória e WAL/disco antes do envio; metadados continuam essenciais. Um bucket íntegro não reconstrói automaticamente usuários, permissões, regras e todas as informações operacionais. A durabilidade deve ser avaliada de ponta a ponta, incluindo a janela anterior ao envio dos dados.
Também seria incorreto dizer que o Elasticsearch só usa SSD local. O Elastic possui camadas de dados e searchable snapshots, com requisitos de implantação e licenciamento. A comparação deve usar a configuração que sua equipe realmente contrataria e operaria, não a arquitetura mais cara de um lado contra a mais econômica do outro.
Benefício 1: reduzir a pressão do custo de retenção
Em muitos ambientes, apenas uma pequena janela de logs é consultada diariamente, mas o histórico precisa permanecer acessível para investigações. Separar computação de consulta e armazenamento pode tornar esse perfil mais interessante economicamente. A vantagem esperada do OpenObserve é especialmente relevante quando a dor principal é manter grandes volumes de telemetria por mais tempo.
Porém, o preço do bucket é apenas uma linha da conta. Some armazenamento local temporário, metadados, CPU, memória, cache, operações de leitura e escrita, transferência entre zonas, saída de dados, backup, suporte e horas de trabalho. Se o storage S3 for autogerenciado, inclua seus discos, redundância, atualizações e recuperação: S3 é uma interface, não uma promessa de infraestrutura gratuita.
Já publicamos a implantação do OpenObserve no Ubuntu com armazenamento externo e a instalação do RustFS. Eles ajudam a montar o laboratório, mas não substituem um ensaio de falha e restauração.
Não compare com um Elasticsearch congelado no passado
O modo logsdb do Elasticsearch é voltado à eficiência de armazenamento de logs. A documentação informa sua adoção padrão para novos data streams correspondentes a logs-*-* em implantações elegíveis do Elasticsearch 9.0 e posteriores. Clusters atualizados de 8.x têm condições específicas; não suponha que streams ou índices antigos tenham sido convertidos automaticamente. Avalie o modo, o mapeamento e a política de retenção corretos antes de concluir que a única solução é migrar. Documentação de logs data streams.
Benefício 2: começar com menos montagem
Para uma equipe pequena, o tempo até a primeira investigação útil conta muito. Instalar uma plataforma, ingerir eventos e explorá-los na própria interface pode ser mais direto do que desenhar uma pilha distribuída completa no primeiro dia. Esse é um bom motivo para experimentar OpenObserve em um laboratório ou serviço com escopo limitado.
O cuidado é não transportar essa simplicidade inicial para uma promessa de produção. Single-node não oferece alta disponibilidade por existir um bucket externo; uma falha do processo ainda afeta o serviço. Em HA, a equipe precisa operar as dependências e compreender o comportamento sob falha. Se ninguém quer assumir isso, compare também opções gerenciadas dos dois fornecedores.
Minha sugestão é registrar duas arquiteturas na avaliação: a mínima que atende ao experimento e a que atenderia aos requisitos reais. Precificar a primeira e prometer a disponibilidade da segunda produz um orçamento fictício.
Benefício 3: investigação orientada a SQL e telemetria integrada
O OpenObserve oferece SQL para consultas e recursos para trabalhar com métricas e traces. Isso pode facilitar a adoção por profissionais habituados a consultas analíticas. Para detalhes de sintaxe e funções, use a referência SQL do projeto, em vez de assumir que todo dialeto de banco relacional será aceito.
Entretanto, SQL não é exclusividade do OpenObserve: Elasticsearch oferece SQL e a linguagem de processamento ES|QL. A vantagem precisa estar na experiência da equipe, na adequação das consultas e no custo de operá-las — não em afirmar que o concorrente só entende JSON.
Ter logs, métricas e traces disponíveis também não cria correlação automaticamente. Padronize nome do serviço, ambiente, timestamps e identificadores de trace. Se cada aplicação usa nomes diferentes ou remove o identificador durante a coleta, nenhuma interface resolve essa perda de contexto sozinha.
Para métricas de infraestrutura, confira também nosso guia de Prometheus e Node Exporter. Uma migração de logs não obriga a trocar, no mesmo projeto, toda a coleta de métricas que já funciona.
O que “sem preocupação com índices” não pode significar
OpenObserve não é um sistema sem esquema, sem tipos ou sem índices. Há configurações de streams, evolução de schema e índices invertidos com Tantivy. O benefício deve ser descrito como uma possível redução ou mudança do trabalho de administração, não como desaparecimento de decisões sobre dados. Consulte schema dos streams e índices Tantivy.
Na prova de conceito, misture eventos válidos com tipos inconsistentes, campos ausentes, mensagens grandes e timestamps incorretos. Verifique o que é rejeitado, transformado ou aceito com perda de informação. Uma plataforma que aparenta ingerir mais rapidamente porque descarta parte da carga não está executando o mesmo trabalho.
Onde Elastic e Kibana podem continuar sendo a melhor escolha
- Investimento existente: dashboards, alertas, integrações e procedimentos já validados têm valor operacional.
- Busca além de telemetria: se Elasticsearch atende também à busca do produto, separar esse uso da observabilidade pode ser melhor que tentar substituir tudo.
- Fluxos especializados: uma equipe que utiliza investigação de segurança não deve tratar a troca como simples migração de logs.
- Conhecimento da equipe: especialistas que já operam a pilha bem podem obter mais retorno com ajustes que com uma reimplantação completa.
O Kibana Lens e as soluções de segurança Elastic mostram por que “substituir o Kibana” pode envolver muito mais do que reproduzir alguns gráficos. Catalogue primeiro os recursos usados e só depois classifique as lacunas. Nem toda função ausente é bloqueadora, mas nenhuma função essencial deve desaparecer por distração.
Edições, SSO e licenças: compare o produto que será usado
A documentação do OpenObserve lista recursos como SSO, RBAC avançado, auditoria e busca federada entre as capacidades Enterprise. Não deduza que a edição comunitária oferece todos os controles mostrados em uma demonstração comercial. Faça uma matriz por edição e confirme quais requisitos são indispensáveis. Recursos Enterprise.
O repositório comunitário do OpenObserve publica licença AGPLv3. No Elastic, a situação exige distinguir código-fonte, partes gratuitas e distribuição: a FAQ documenta a opção AGPLv3 para partes gratuitas do código e a continuidade da distribuição oficial sob Elastic License 2.0. Não reduza isso a “um é aberto e o outro não”. FAQ oficial de licenciamento.
Antes de redistribuir modificações ou oferecer uma solução como serviço, encaminhe as licenças aplicáveis para análise específica. Este comparativo técnico não substitui uma avaliação jurídica nem uma proposta comercial atualizada.
Como ler benchmarks sem comprar uma promessa
O fornecedor do OpenObserve publica benchmarks contra Elasticsearch. São evidências úteis sobre um experimento do fornecedor, não garantia do resultado na sua infraestrutura. Verifique versões, edições, dataset, documentos efetivamente aceitos, réplicas, hardware, consultas e condições de cache antes de reproduzir qualquer multiplicador de economia.
Não apresentamos um número universal de “vezes mais barato” ou “vezes mais rápido”. Armazenamento comprimido, custo mensal e latência são medidas diferentes. Uma redução em bytes não informa sozinha quanto custará o sistema completo; uma consulta isolada mais rápida não representa a experiência de vários usuários durante um incidente.
Prova de conceito: um roteiro que permite decidir
- Escolha um serviço não crítico: obtenha logs representativos, remova segredos e defina uma janela de avaliação com responsáveis.
- Fixe as condições: registre versões, edições, recursos computacionais, retenção, redundância e políticas de ingestão.
- Duplique uma amostra controlada: configure o coletor para entregar aos dois destinos, sem retirar de imediato o ambiente que atende à operação.
- Conte o que entrou: compare eventos enviados, aceitos, rejeitados e disponíveis para consulta. Use identificadores de teste para detectar perdas e duplicações.
- Reproduza investigações reais: procura por um trace, erros por serviço, texto livre, agregações, intervalos longos e consultas simultâneas.
- Teste limites e falhas: destino indisponível, pico de carga, armazenamento lento, reinício e restauração.
- Decida por critérios escritos: custo total, funcionalidade, segurança, desempenho e capacidade da equipe de operar.
Dupla escrita não é gratuita: pode aumentar CPU, rede e filas do coletor. Defina limites para que a falha do destino experimental não prejudique a entrega ao destino principal. Observe também a política de repetição; reenviar eventos pode produzir duplicatas se a integração não garantir deduplicação.
| Dimensão | O que registrar | Armadilha a evitar |
|---|---|---|
| Integridade | Enviados, aceitos, rejeitados e consultáveis. | Confundir HTTP de sucesso com todos os eventos indexados. |
| Ingestão | Taxa sustentada, atraso e comportamento em pico. | Medir só poucos segundos sem pressão de retenção. |
| Consulta | p50/p95, concorrência e cache frio/quente. | Comparar consultas diferentes ou só o melhor resultado. |
| Armazenamento | Dados, índices, WAL, metadados, réplicas e backup. | Contar apenas o arquivo comprimido de um lado. |
| Operação | Horas de manutenção, atualizações e recuperação. | Tratar trabalho interno como custo zero. |
| Segurança | Isolamento, permissões, SSO, auditoria e retenção. | Avaliar edição diferente daquela que será contratada. |
Migração: ingestão compatível não é substituição automática
Uma integração que envia eventos a um endpoint compatível não transfere automaticamente consultas, dashboards, alertas e permissões. Liste esses objetos como entregas de migração, com dono e teste de aceite. Campos podem mudar de nome ou tipo; uma contagem visualmente parecida pode esconder filtros ou intervalos de tempo diferentes.
Para o histórico, decida entre reingerir dados, mantê-los temporariamente na plataforma anterior ou migrar apenas a partir de uma data de corte. Registre custos, retenção e como investigar um incidente que atravesse essa data. Evite prometer importação direta de índices ou snapshots sem um procedimento especificamente suportado e testado.
Antes do corte definitivo, ensaie voltar o fluxo ao destino anterior. Preserve a configuração dos coletores e a janela necessária para comparação. Só desative a solução antiga depois de validar alertas, acesso da equipe e recuperação, não apenas porque o novo dashboard ficou pronto.
Veredito: em quais cenários eu começaria pelo OpenObserve
Eu colocaria OpenObserve entre as primeiras opções quando a necessidade principal é observabilidade, o custo de retenção pesa e a equipe quer experimentar uma plataforma integrada sem montar um cluster complexo de saída. O melhor argumento é um piloto que prove valor com os próprios dados.
Manteria Elastic na comparação quando recursos especializados, busca do produto ou um investimento significativo em Kibana e automação forem decisivos. Também consideraria coexistência: migrar uma classe de logs pode resolver o problema sem uma substituição total.
A vantagem do OpenObserve não precisa ser “vencer em tudo”. Basta atender às investigações necessárias com custo total e esforço operacional melhores no seu cenário — sem abrir mão de integridade, segurança e recuperação.