Una plataforma de logs debería ayudar a resolver incidentes, no convertirse en el incidente más frecuente del equipo. Cuando Elasticsearch consume una parte importante del presupuesto y mantener índices, retención y capacidad exige atención constante, el OpenObserve merece entrar en la evaluación. Sus principales atractivos son una arquitectura orientada a almacenamiento de objetos, una interfaz integrada para telemetría y un camino sencillo para empezar en un único servidor.
Esto no significa que “OpenObserve siempre sea mejor que ELK”, ni que Kibana sea solo un visualizador descartable. La elección involucra datos, consultas, integraciones, seguridad y madurez operativa. En esta comparativa, vamos a separar beneficios reales, limitaciones y un roteiro de prueba de concepto. No ejecutamos un benchmark comparativo en este artículo; las características se comprobaron en la documentación de los proyectos, y las recomendaciones de evaluación se proponen para tu entorno.
Primero: OpenObserve no compite solo con Kibana
ELK es la sigla histórica de Elasticsearch, Logstash y Kibana: almacenamiento/búsqueda, procesamiento de eventos y exploración visual. Hoy, una implantación Elastic puede usar Elastic Agent, OpenTelemetry y otras vías de ingesta, sin incluir necesariamente Logstash. También puede ser autogestionada, gestionada o Serverless.
OpenObserve combina ingesta, búsqueda, visualización y alertas orientados a logs, métricas y traces. Por tanto, la comparación útil es entre soluciones completas de observabilidad, no entre un backend y una pantalla. Para conocer primero la plataforma, vea nuestra guía de OpenObserve. Para el lado Elastic, consulte la documentación de OpenTelemetry.
Dónde están los beneficios más interesantes de OpenObserve
| Beneficio potencial | Por qué interesa | Qué necesita ser demostrado |
|---|---|---|
| Retención con object storage | Abre espacio para mantener histórico sin concentrar todo el coste en discos de nodos de búsqueda. | Coste total, consultas al histórico, tráfico y restauración. |
| Entrada simple | Una implementación single-node facilita laboratorio y adopción inicial. | Límites de capacidad, indisponibilidad aceptable y camino de crecimiento. |
| Interfaz integrada | La búsqueda y la visualización en el mismo producto reducen el montaje inicial. | Los dashboards e investigaciones que el equipo realmente utiliza. |
| SQL en la investigación | Aprovecha el conocimiento existente de filtros y agregaciones. | Equivalencia de funciones, tipos, precisión y rendimiento de las consultas. |
| Recolección desacoplada | Los pipelines y colectores permiten evaluar otro destino sin reescribir toda la aplicación. | Compatibilidad de protocolos, atributos, colas y política de reintentos. |
La palabra “potencial” importa: ahorrar almacenamiento mientras se pierde una investigación crítica no es una mejora. La decisión debe considerar el servicio prestado al equipo, no solo la cantidad de componentes instalados.
Arquitectura: por qué el almacenamiento cambia la conversación
En OpenObserve, los datos analíticos pueden persistirse en Parquet en almacenamiento de objetos. Single-node puede usar SQLite y disco local u object storage. El diseño HA documentado utiliza Kubernetes/Helm y añade PostgreSQL para metadatos, NATS para coordinación y roles separados de ingesta, consulta, enrutamiento, compactación y programación. Arquitectura oficial de OpenObserve.
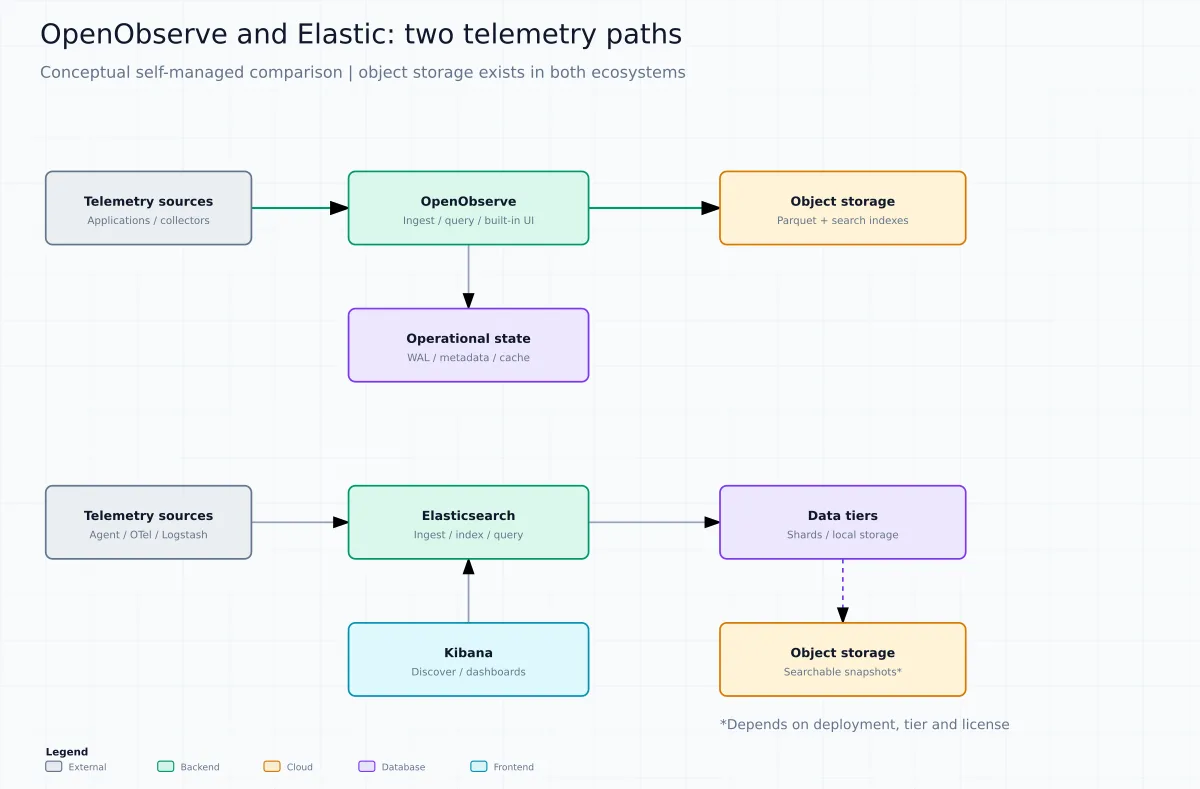
No es “todo sin estado”. Los ingesters mantienen datos en memoria y WAL/disco antes de reenviar; los metadatos siguen siendo esenciales. Un bucket íntegro no reconstruye automáticamente usuarios, permisos, reglas y toda la información operativa. La durabilidad debe evaluarse de extremo a extremo, incluyendo la ventana previa al reenvío de los datos.
También sería incorrecto decir que Elasticsearch solo usa SSD local. Elastic ofrece capas de datos e instantáneas consultables, con requisitos de implementación y licenciamiento. La comparación debe usar la configuración que su equipo realmente contrataría y operaría, no la arquitectura más cara de un lado frente a la más económica del otro.
Beneficio 1: reducir la presión del coste de retención
En muchos entornos, solo una pequeña ventana de logs se consulta a diario, pero el historial debe permanecer accesible para investigaciones. Separar computación de consulta y almacenamiento puede hacer ese perfil más interesante económicamente. La ventaja esperada de OpenObserve es especialmente relevante cuando el principal dolor es mantener grandes volúmenes de telemetría durante más tiempo.
Sin embargo, el precio del bucket es solo una línea de la cuenta. Sume almacenamiento local temporal, metadatos, CPU, memoria, caché, operaciones de lectura y escritura, transferencia entre zonas, salida de datos, backup, soporte y horas de trabajo. Si el almacenamiento S3 es autogestionado, incluya sus discos, redundancia, actualizaciones y recuperación: S3 es una interfaz, no una promesa de infraestructura gratuita.
Ya publicamos la implementación de OpenObserve en Ubuntu con almacenamiento externo y la instalación de RustFS. Ayudan a montar el laboratorio, pero no sustituyen a un ensayo de fallo y restauración.
No compares con un Elasticsearch congelado en el pasado
El modo logsdb de Elasticsearch está orientado a la eficiencia de almacenamiento de logs. La documentación indica su adopción por defecto para nuevos data streams correspondientes a logs-*-* en implantaciones elegibles de Elasticsearch 9.0 y posteriores. Los clústeres actualizados desde 8.x tienen condiciones específicas; no supongas que los streams o índices antiguos se hayan convertido automáticamente. Evalúa el modo, el mapeado y la política de retención correctos antes de concluir que la única solución es migrar. Documentación de logs data streams.
Beneficio 2: empezar con menos montaje
Para un equipo pequeño, el tiempo hasta la primera investigación útil cuenta mucho. Instalar una plataforma, ingerir eventos y explorarlos en la propia interfaz puede ser más directo que diseñar una pila distribuida completa el primer día. Este es un buen motivo para probar OpenObserve en un laboratorio o servicio con un alcance limitado.
El cuidado está en no trasladar esa simplicidad inicial a una promesa de producción. Single-node no ofrece alta disponibilidad por existir un bucket externo; un fallo del proceso sigue afectando al servicio. En HA, el equipo debe operar las dependencias y comprender el comportamiento ante fallos. Si nadie quiere asumir eso, compara también opciones gestionadas de ambos proveedores.
Mi sugerencia es registrar dos arquitecturas en la evaluación: la mínima que satisface el experimento y la que cubriría los requisitos reales. Presupuestar la primera y prometer la disponibilidad de la segunda produce un presupuesto ficticio.
Beneficio 3: investigación orientada a SQL y telemetría integrada
OpenObserve ofrece SQL para consultas y recursos para trabajar con métricas y traces. Esto puede facilitar la adopción por parte de profesionales habituados a consultas analíticas. Para detalles de sintaxis y funciones, utiliza la referencia SQL del proyecto, en lugar de asumir que se aceptará todo dialecto de base de datos relacional.
Sin embargo, SQL no es exclusivo de OpenObserve: Elasticsearch ofrece SQL y el lenguaje de procesamiento ES|QL. La ventaja debe estar en la experiencia del equipo, en la adecuación de las consultas y en el coste de operarlas — no en afirmar que el competidor solo entiende JSON.
Tener logs, métricas y trazas disponibles tampoco crea correlación automáticamente. Estandarice el nombre del servicio, el entorno, las marcas de tiempo y los identificadores de trazas. Si cada aplicación utiliza nombres diferentes o elimina el identificador durante la recopilación, ninguna interfaz resuelve por sí sola esa pérdida de contexto.
Para métricas de infraestructura, consulte también nuestra guía de Prometheus y Node Exporter. Una migración de logs no obliga a cambiar, en el mismo proyecto, toda la recopilación de métricas que ya funciona.
Lo que “sin preocupación por los índices” no puede significar
OpenObserve no es un sistema sin esquema, sin tipos o sin índices. Existen configuraciones de streams, evolución de esquema e índices invertidos con Tantivy. El beneficio debe describirse como una posible reducción o cambio del trabajo de administración, no como la desaparición de decisiones sobre los datos. Consulte esquema de los streams e índices Tantivy.
En la prueba de concepto, mezcle eventos válidos con tipos incoherentes, campos ausentes, mensajes grandes y marcas de tiempo incorrectas. Verifique qué se rechaza, transforma o acepta con pérdida de información. Una plataforma que parece ingerir más rápido porque descarta parte de la carga no está realizando el mismo trabajo.
Dónde Elastic y Kibana pueden seguir siendo la mejor opción
- Inversión existente: dashboards, alertas, integraciones y procedimientos ya validados tienen valor operativo.
- Búsqueda más allá de telemetría: si Elasticsearch también atiende a la búsqueda del producto, separar ese uso de la observabilidad puede ser mejor que intentar sustituirlo todo.
- Flujos especializados: un equipo que utiliza investigación de seguridad no debe tratar el cambio como una simple migración de logs.
- Conocimiento del equipo: especialistas que ya operan bien la pila pueden obtener más retorno con ajustes que con una reimplantación completa.
O Kibana Lens y las soluciones de seguridad de Elastic muestran por qué “sustituir Kibana” puede implicar mucho más que reproducir algunos gráficos. Catalogue primero las funcionalidades utilizadas y solo después clasifique las carencias. Ni toda función ausente es bloqueante, pero ninguna función esencial debe desaparecer por descuido.
Ediciones, SSO y licencias: compara el producto que se va a usar
La documentación de OpenObserve enumera funciones como SSO, RBAC avanzado, auditoría y búsqueda federada entre las capacidades Enterprise. No deduzca que la edición comunitaria ofrece todos los controles mostrados en una demostración comercial. Haga una matriz por edición y confirme qué requisitos son imprescindibles. Funciones Enterprise.
El repositorio comunitario de OpenObserve publica licencia AGPLv3. En Elastic, la situación exige distinguir código fuente, partes gratuitas y distribución: la FAQ documenta la opción AGPLv3 para las partes gratuitas del código y la continuidad de la distribución oficial bajo Elastic License 2.0. No lo reduzca a “uno es abierto y el otro no”. FAQ oficial de licencias.
Antes de redistribuir modificaciones u ofrecer una solución como servicio, envíe las licencias aplicables para un análisis específico. Esta comparativa técnica no sustituye a una evaluación jurídica ni a una propuesta comercial actualizada.
Cómo leer benchmarks sin comprar una promesa
El proveedor de OpenObserve publica benchmarks frente a Elasticsearch. Son evidencias útiles sobre un experimento del proveedor, no garantía del resultado en su infraestructura. Verifique versiones, ediciones, conjunto de datos, documentos efectivamente aceptados, réplicas, hardware, consultas y condiciones de caché antes de reproducir cualquier multiplicador de ahorro.
No presentamos un número universal de “veces más barato” o “veces más rápido”. Almacenamiento comprimido, coste mensual y latencia son medidas diferentes. Una reducción en bytes no informa por sí sola cuánto costará el sistema completo; una consulta aislada más rápida no representa la experiencia de varios usuarios durante un incidente.
Prueba de concepto: una hoja de ruta que permite decidir
- Elija un servicio no crítico: obtenga registros representativos, elimine secretos y defina una ventana de evaluación con responsables.
- Defina las condiciones: registre versiones, ediciones, recursos computacionales, retención, redundancia y políticas de ingesta.
- Duplique una muestra controlada: configure el colector para entregar a ambos destinos, sin retirar de inmediato el entorno que atiende a la operación.
- Cuente lo que entró: compare eventos enviados, aceptados, rechazados y disponibles para consulta. Use identificadores de prueba para detectar pérdidas y duplicaciones.
- Reproduzca investigaciones reales: búsqueda por un trace, errores por servicio, texto libre, agregaciones, intervalos largos y consultas simultáneas.
- Pruebe límites y fallos: destino no disponible, pico de carga, almacenamiento lento, reinicio y restauración.
- Decida por criterios escritos: coste total, funcionalidad, seguridad, rendimiento y capacidad del equipo para operarlo.
La escritura dual no es gratuita: puede aumentar la CPU, la red y las colas del colector. Define límites para que la caída del destino experimental no perjudique la entrega al destino principal. Observa también la política de reintentos; reenviar eventos puede producir duplicados si la integración no garantiza la deduplicación.
| Dimensión | Qué registrar | Trampa a evitar |
|---|---|---|
| Integridad | Enviados, aceptados, rechazados y consultables. | Confundir el HTTP de éxito con todos los eventos indexados. |
| Ingestión | Tasa sostenida, retraso y comportamiento en pico. | Medir solo unos pocos segundos sin presión de retención. |
| Consulta | p50/p95, concurrencia y caché fría/caliente. | Comparar consultas diferentes o solo el mejor resultado. |
| Almacenamiento | Datos, índices, WAL, metadatos, réplicas y backup. | Contar solo el archivo comprimido de un lado. |
| Operación | Horas de mantenimiento, actualizaciones y recuperación. | Tratar trabajo interno como coste cero. |
| Seguridad | Aislamiento, permisos, SSO, auditoría y retención. | Evaluar una edición distinta de la que se contratará. |
Migración: ingesta compatible no es sustitución automática
Una integración que envía eventos a un endpoint compatible no transfiere automáticamente consultas, dashboards, alertas ni permisos. Liste esos objetos como entregas de migración, con responsable y prueba de aceptación. Los campos pueden cambiar de nombre o tipo; un recuento visualmente parecido puede ocultar filtros o intervalos de tiempo diferentes.
Para el histórico, decida entre reingerir datos, mantenerlos temporalmente en la plataforma anterior o migrar solo a partir de una fecha de corte. Registre costes, retención y cómo investigar un incidente que atraviese esa fecha. Evite prometer importación directa de índices o snapshots sin un procedimiento específicamente soportado y probado.
Antes del corte definitivo, ensaye volver el flujo al destino anterior. Preserve la configuración de los colectores y la ventana necesaria para la comparación. Solo desactive la solución antigua después de validar alertas, acceso del equipo y recuperación, no únicamente porque el nuevo dashboard haya quedado listo.
Veredicto: en qué escenarios empezaría por OpenObserve
Yo situaría OpenObserve entre las primeras opciones cuando la necesidad principal es la observabilidad, el coste de retención pesa y el equipo quiere experimentar con una plataforma integrada sin montar un clúster complejo de salida. El mejor argumento es un piloto que demuestre valor con los datos propios.
Mantendría Elastic en la comparación cuando recursos especializados, búsqueda del producto o una inversión significativa en Kibana y automatización sean determinantes. También consideraría la coexistencia: migrar una clase de logs puede resolver el problema sin una sustitución total.
La ventaja de OpenObserve no tiene por qué ser “ganar en todo”. Basta con atender a las investigaciones necesarias con un coste total y un esfuerzo operativo mejores en su escenario, sin renunciar a integridad, seguridad y recuperación.