

Cuando un servicio empieza a fallar, normalmente las señales están dispersas: métricas en Prometheus, logs en otro backend, traces en una tercera herramienta y alertas sin contexto. El OpenObserve intenta unificar ese trabajo en una plataforma open source para logs, métricas, traces, RUM, dashboards, alertas e incidentes. Escrito en Rust, consulta logs y traces con SQL, métricas con SQL o PromQL y utiliza Parquet con almacenamiento orientado a objetos para reducir el coste de retención.
Resumen en vídeo: la demostración oficial de dos minutos muestra la instalación y los primeros pasos de OpenObserve. URL: OpenObserve 2-Minute Demo: Quick Install and Setup.
Revisión técnica: 7 de octubre de 2026. Este artículo presenta la plataforma y un laboratorio de registros. Para instalarlo sin Docker y operarlo con TLS y bucket, siga la guía de OpenObserve en Ubuntu.
Qué es OpenObserve
OpenObserve, también llamado O2, es una plataforma de observabilidad unificada. La idea no es reemplazar todos los agentes que recopilan telemetría, sino ofrecer un destino y una interfaz comunes para las señales: logs, métricas y trazas distribuidas. La plataforma también incluye cuadros de mando, alertas, pipelines de ingestión, gestión de incidentes, monitorización de usuario real (RUM) y recursos de observabilidad para aplicaciones de IA.
El proyecto es open source bajo AGPL-3.0. También hay una edición Enterprise y el servicio OpenObserve Cloud. Esto importa en la elección: la edición OSS es útil para quienes quieren control de la infraestructura y de la residencia de los datos; las funciones corporativas específicas, como SSO, RBAC granular, búsqueda federada y gestión de carga, pertenecen a la oferta Enterprise.
Por qué unificar logs, métricas y traces
Las tres señales responden a preguntas diferentes:
- Métricas muestran tendencia y estado agregado: uso de CPU, tasa de errores, latencia y volumen de peticiones.
- Los registros preservan el evento y su contexto: mensajes de la aplicación, errores, campos estructurados y auditoría.
- Los traces siguen una solicitud a través de servicios, colas y bases de datos, haciendo visible dónde se invirtió el tiempo.
El valor de una plataforma unificada aparece en la investigación. Un pico de errores en el gráfico puede llevar a los traces de ese servicio y, desde ellos, a los logs del mismo periodo. Esto no elimina la necesidad de instrumentar bien la aplicación ni corrige una cardinalidad excesiva; solo reduce los cambios de contexto entre herramientas.
Si ya monitorizas máquinas Linux, empieza por nuestra guía de Prometheus y Node Exporter. OpenObserve puede complementar ese flujo al centralizar otras señales, pero no hay motivo para migrar con prisa una pila estable solo porque una plataforma reúne más funciones.
De la aplicación a la investigación: el flujo de la telemetría
La aplicación produce señales; los agentes o un OpenTelemetry Collector reciben, procesan y reenvían esos datos; OpenObserve los almacena y permite consultarlos. El Collector es opcional, pero puede centralizar el envío y reducir la configuración repetida en los servicios. No es la base de datos ni el panel. El esquema de abajo es conceptual, no una configuración lista de todos los protocolos.
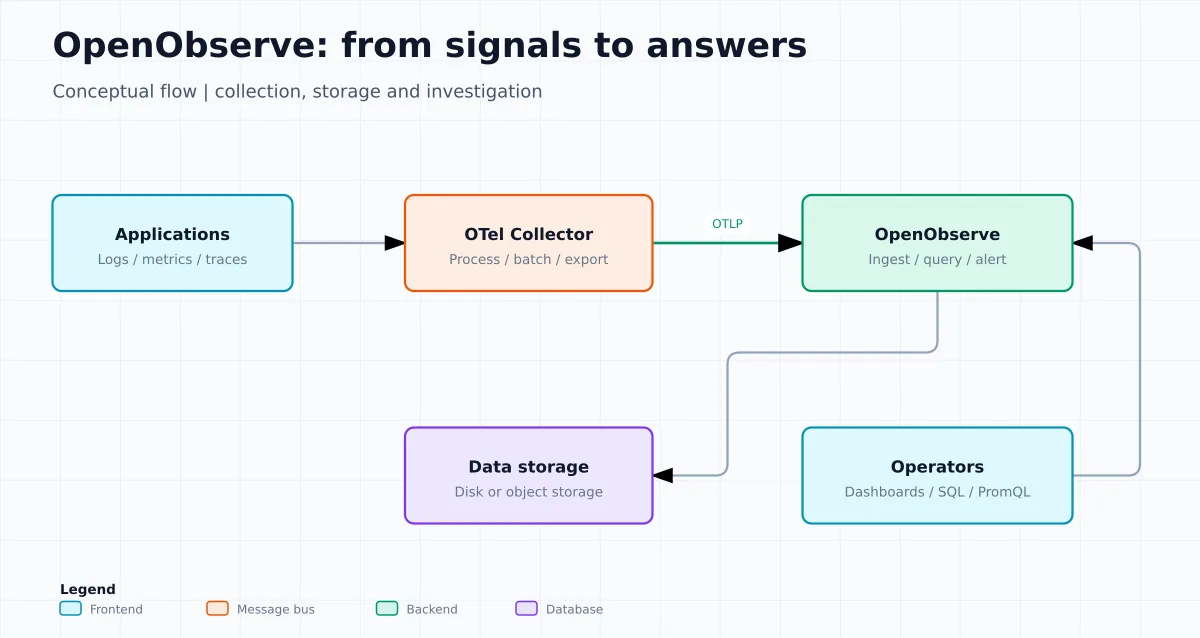
Mantenga identificadores coherentes de servicio y entorno. Para correlacionar logs y traces, propague el contexto e incluya los identificadores de trace y span en los eventos relevantes. No transforme IDs de usuario o de petición en labels de métricas sin evaluar la cardinalidad. Referencia: señales de OpenTelemetry.
Cómo la arquitectura reduce el número de piezas
En modo de nodo único, OpenObserve utiliza SQLite para los metadatos y puede escribir localmente o en almacenamiento de objetos. Es la opción para laboratorio, desarrollo y cargas que no exigen alta disponibilidad. La documentación también contempla nodo único con S3, GCS, MinIO o Azure Blob: sigue siendo sencilla de operar, pero los archivos Parquet quedan en un almacenamiento más duradero.
En alta disponibilidad, la topología cambia: el proyecto separa los roles de Router, Ingester, Compactor, Querier y Scheduler. Kubernetes orquesta los nodos; PostgreSQL guarda los metadatos; NATS coordina el clúster; y el almacenamiento de objetos conserva los archivos Parquet. Esto escala mejor, pero no es “un binario sin operación”: es una arquitectura de producción que requiere capacidad, copias de seguridad, actualización planificada, red y observabilidad del propio backend.
Parquet organiza los datos en columnas y permite una compresión adecuada para consultas analíticas. Esto no determina por sí solo el ahorro: compare ingestión, retención, concurrencia, tiempo de consulta, caché, peticiones al bucket y tráfico. Prefiera medir su carga a trasladar un multiplicador de benchmark al presupuesto.
Características principales
| Área | Qué ofrece OpenObserve | Punto de atención |
|---|---|---|
| Los registros | Búsqueda textual, filtros, SQL y construcción visual de consultas. | Define esquema, retención y campos útiles antes de enviar todo indiscriminadamente. |
| Métricas | Consulta por SQL o PromQL, gráficos y alertas. | La compatibilidad de consulta no sustituye la revisión de las reglas existentes. |
| Los traces | Exploración de traces OpenTelemetry, waterfall, flame graph y service graph. | El resultado depende de la propagación correcta del contexto entre servicios. |
| Dashboards y alertas | Paneles, variables, visualizaciones, alertas e incidentes. | Las alertas deben tener propietario, severidad, ruta y procedimiento de respuesta. |
| Pipelines | Transformaciones de ingesta, normalización y conversión de logs en métricas. | Prueba transformaciones en muestra; un parser incorrecto puede destruir el contexto. |
| RUM e IA | Core Web Vitals, errores, reproducción de sesión y señales para aplicaciones GenAI/LLM. | RUM y datos de IA exigen una atención redoblada a PII, consentimiento y retención. |
Instalación rápida en Docker para laboratorio
El laboratorio requiere Bash, curl, OpenSSL y Docker Engine actualizado, con permiso para ejecutar contenedores. Use Docker 28 o posterior para evitar la limitación histórica de publicación en loopback accesible en el mismo segmento de red; consulte la documentación de publicación de puertos.
El procedimiento siguiente utiliza la imagen OSS indicada por el repositorio del proyecto. Es para pruebas locales o una prueba de concepto; no exponga el puerto 5080 directamente en internet y no utilice una contraseña de ejemplo en un servidor accesible.
umask 077
LAB=$(mktemp -d "$HOME/openobserve-lab.XXXXXX")
cd "$LAB"
mkdir data

export ZO_ROOT_USER_EMAIL="admin@example.com"
export ZO_ROOT_USER_PASSWORD="$(openssl rand -base64 32)"

printf '%s\n' "$ZO_ROOT_USER_PASSWORD" > senha-inicial.txt
chmod 600 senha-inicial.txt

docker run -d \
  --name linuxpro-openobserve-lab \
  --restart no \
  -v "$PWD/data:/data" \
  -p 127.0.0.1:5080:5080 \
  -e ZO_DATA_DIR="/data" \
  -e ZO_ROOT_USER_EMAIL \
  -e ZO_ROOT_USER_PASSWORD \
  public.ecr.aws/zinclabs/openobserve:latest
Abre http://127.0.0.1:5080 en el propio host o haga un túnel SSH. Para un equipo, publique la interfaz detrás de un proxy inverso con TLS y autenticación adecuada. En producción, prefiera una etiqueta de imagen probada en lugar de latest y siga la página de releases.
El usuario root se define en el primer arranque. Guarde la credencial fuera del historial del shell y de archivos compartidos, por ejemplo en un gestor de secretos. Antes de eliminar la prueba, detenga el contenedor y elimine el directorio de datos de forma consciente: allí es donde se persistió la telemetría local.
Enviar un evento y cerrar la prueba de extremo a extremo
Verifique el proceso antes de enviar datos:
docker logs --tail=50 linuxpro-openobserve-lab
curl --fail --silent --show-error --retry 20 --retry-connrefused --retry-delay 2 http://127.0.0.1:5080/healthz
Envíe el evento siguiente en la terminal del host. El curl pedirá la contraseña guardada en senha-inicial.txt, sin colocarla en el historial. La organización es default y el stream es linuxpro_lab. Sin timestamp explícito, el servidor asigna el horario de la ingestión.
curl --fail-with-body --silent --show-error \
  --user admin@example.com \
  --header 'Content-Type: application/json' \
  --data '[{"service":"linuxpro-demo","level":"info","message":"primeiro evento","duration_ms":12}]' \
  http://127.0.0.1:5080/api/default/linuxpro_lab/_json
Consulta el cuerpo de la respuesta: HTTP 200 por sí solo no basta si hay registros rechazados. Entra en la interfaz, selecciona Logs y el stream linuxpro_lab, elige los últimos minutos y ejecuta en modo SQL:
SELECT _timestamp, service, level, message, duration_ms
FROM "linuxpro_lab"
ORDER BY _timestamp DESC
LIMIT 20
Encontrar primeiro evento demuestra ingestión y consulta, no solo proceso activo. Si no aparece, revisa la organización, el stream, la ventana de tiempo y la respuesta del POST. El ejemplo prueba logs JSON; métricas y traces necesitan sus propios exporters y endpoints. Referencia oficial de las APIs.
Registra la imagen efectiva para repetir el laboratorio. La etiqueta latest cambia; en producción, fija una release homologada o el digest y planifica las actualizaciones.
docker image inspect public.ecr.aws/zinclabs/openobserve:latest --format '{{index .RepoDigests 0}}'
unset ZO_ROOT_USER_PASSWORD
Los administradores de Docker pueden inspeccionar las variables del contenedor. El archivo de contraseña y el directorio deben permanecer protegidos. Para detener sin borrar la persistencia:
docker stop linuxpro-openobserve-lab
docker rm linuxpro-openobserve-lab
El directorio data se mantiene. Elimínalo solo cuando decidas que esos datos son descartables. No ejecutes limpieza global de volúmenes o contenedores.
Del laboratorio a producción
Una instalación de producción comienza con decisiones de datos, no con el comando de Docker:
- Elija la retención por tipo de señal. Los registros de depuración y la reproducción de sesión no necesitan tener la misma ventana que las métricas de capacidad.
- Planifique el almacenamiento. Para durabilidad y escalabilidad, usa un bucket compatible con el diseño recomendado por el proyecto; para HA, el almacenamiento local no es compatible.
- Usa OpenTelemetry cuando sea posible. Estandarizar la instrumentación y el contexto reduce la dependencia de agentes específicos.
- Separa organizaciones, streams y credenciales. No mezcles producción, homologación y datos sensibles sin una política clara.
- Trata el acceso como parte de la arquitectura. La comparación oficial indica que la OSS no proporciona RBAC granular; valida los requisitos de SSO, auditoría y permisos antes de abrir la plataforma a varios equipos.
- Prueba la restauración. Un backup no probado es solo una esperanza. Verifica los datos, los metadatos y las configuraciones necesarias para recuperar el entorno.
La guía oficial deja claro que el modo HA requiere Kubernetes, PostgreSQL, NATS y almacenamiento de objetos. Si el equipo no tiene la madurez necesaria para operar estos componentes, la edición Cloud o un nodo único bien delimitado puede ser una decisión más segura que una implementación HA infradimensionada.
Consultas, cuadros de mando y alertas
Los logs y traces se pueden explorar con SQL; las métricas pueden usar SQL o PromQL. La ventaja práctica es conservar lenguajes que muchos equipos ya conocen en lugar de obligar a usar un DSL propietario. Aun así, la migración de dashboards y alertas requiere revisión: nombres de métricas, labels, ventanas temporales, agregaciones y semántica de funciones deben validarse frente al resultado anterior.
Empieza por un panel pequeño y accionable: disponibilidad, tasa de error, latencia de percentiles y señales de saturación. Para cada alerta, documenta qué dashboard abrir, qué campos filtrar, quién atiende y qué acción se puede tomar. Alertar sobre todo es el camino más corto para que se ignoren las alertas.
Vídeo oficial: este tutorial del canal OpenObserve recorre la creación de dashboards. URL: Building Dashboards with OpenObserve: A Comprehensive Tutorial.
Open source, Enterprise y Cloud
La edición OSS es AGPL-3.0 y gratuita, con logs, métricas, traces, RUM, dashboards y alertas. Según la tabla oficial de descargas, tiene soporte básico de usuarios, pero sin RBAC granular: los usuarios tienen acceso completo. La edición Enterprise añade, entre otros elementos, SSO, roles personalizados, grupos, auditoría, búsqueda federada, control de carga de trabajo y funciones avanzadas de pipeline y seguridad.
Separe el coste de la licencia del coste operativo: infraestructura, retención, peticiones, tráfico y trabajo del equipo siguen existiendo en self-hosted. Las licencias y condiciones comerciales cambian; consulta la página de precios y la comparación de ediciones antes de decidir.
Cuándo tiene sentido — y cuándo no
OpenObserve es una buena opción para quien desea consolidar telemetría en torno a OpenTelemetry, SQL, PromQL y almacenamiento de objetos; para equipos que ya pagan caro por la retención de logs; o para quien prefiere operar una plataforma integrada en lugar de conectar varias piezas.
Puede que no sea la elección adecuada si el equipo solo necesita métricas de unos pocos hosts, si ya existe una plataforma con SLOs e integraciones maduras que cubre bien las necesidades, o si no hay capacidad para operar datos, copias de seguridad y actualizaciones. “Un binario” simplifica la primera prueba; no elimina la responsabilidad operativa, la gobernanza de acceso ni el coste de almacenamiento.
Un vídeo más: comparación con Splunk
Para una visión del posicionamiento del producto, este vídeo de WPoets TV recoge una conversación con OpenObserve sobre la comparación con Splunk. Es una fuente complementaria, no sustituye a una prueba de carga ni al cálculo de coste en tu entorno.
Para conocer una opción de almacenamiento de objetos con API S3, consulta RustFS en Linux: instalación por binario y Docker. RustFS almacena objetos; OpenObserve recibe, consulta y presenta la telemetría. Homologa la compatibilidad entre las versiones antes de combinarlos.
Fuentes oficiales y próximos pasos
- Repositorio de OpenObserve en GitHub
- Documentación oficial
- Funcionalidades de la plataforma
- Arquitectura y modos de implementación
- Inicio rápido: Cloud y self-hosted
- Blog de OpenObserve
- Precios e downloads
El mejor siguiente paso es pequeño: ejecute el laboratorio, envíe una fuente de logs y una métrica que ya conozca, cree una única alerta y calcule la ingesta y la retención reales. Solo entonces decida si merece la pena ampliar la plataforma.