
Todo el mundo tiene backup de bases de datos. Poca gente tiene backup que ya haya sido restaurado. El Databasus ataca justo esa diferencia: es una herramienta self-hosted, con interfaz web, que programa dumps de PostgreSQL, MySQL, MariaDB y MongoDB, comprime, cifra, envía a S3, Google Drive, SFTP o disco local, avisa en Telegram o en Slack y, para PostgreSQL, además levanta un contenedor desechable, restaura el backup y cuenta las filas de cada tabla para demostrar que funciona.
El proyecto es open source bajo licencia Apache 2.0, escrito en Go (backend) y TypeScript (frontend), y se ejecuta en Docker. En este post vemos cómo funciona por dentro, instala, configura un backup de MariaDB/MySQL, entiende el PITR de PostgreSQL 17 y monta el agente de verificación de restore.
De Postgresus a Databasus
El proyecto nació como Postgresus, creado por Rostislav Dugin, y era solo para PostgreSQL. Cuando añadió soporte para MySQL, MariaDB y MongoDB, el nombre dejó de tener sentido y pasó a llamarse Databasus, a finales de 2025 (las issues de migración “Upgrade path from Postgresus to Databasus” son de diciembre de 2025). El repositorio antiguo RostislavDugin/postgresus ahora redirige a databasus/databasus.
En septiembre de 2026 el repositorio supera las 8.600 estrellas, la imagen en Docker Hub tiene más de 1,9 millón de pulls y la versión más reciente es la v3.60.0, de 22/09/2026. El ritmo de lanzamientos es alto, así que consulta la página de lanzamientos antes de fijar una versión.
¿Hace backup de MySQL y MariaDB? Sí, pero solo lógico
Esa es la pregunta que más importa para quien ejecuta LAMP. La respuesta corta: sim, con una limitación que conviene dejar clara.
| Base de datos | Versiones | Tipo de copia de seguridad | Herramienta utilizada |
|---|---|---|---|
| PostgreSQL | 14, 15, 16, 17 y 18 | lógico y físico (físico solo en 17+) | pg_dump, pg_basebackup, pg_receivewal |
| MySQL | 5.7, 8.0, 8.4, 9 y 26 | solo lógico | mysqldump |
| MariaDB | 5.5, 10, 11, 12 y 13 | solo lógico | mariadb-dump |
| MongoDB | 4.2+, 5, 6, 7 y 8 | solo lógico | dump nativo |
Para MySQL, Databasus llama al mysqldump oficial; para MariaDB, utiliza el mariadb-dump nativo, y no el dump de MySQL, lo que evita incompatibilidades con características específicas de MariaDB. Los binarios de cada versión vienen integrados en la imagen, por lo que no se instala ningún cliente. Mirando el código del backend, los parámetros pasados al dump son los siguientes:
--single-transaction: snapshot consistente en InnoDB, sin bloquear las tablas;--routines,--triggerse--events: procedures, functions, triggers y eventos programados se incluyen en el backup;--quicke--max-allowed-packet=1G: filas en streaming, sin cargar tablas enteras en memoria;--no-tablespaces: no requiere el privilegioPROCESS;- compresión de red zstd en MySQL 8.0+ (en 5.7 recurre a la compresión antigua).
Hay un cuidado con MariaDB Galera: en el restore, Databasus desactiva la replicación solo en esa sesión (wsrep_on), para que el dump no se replique fila a fila por el clúster. Esto se puede desactivar en la configuración de la base de datos. Quien ejecuta el cluster Galera te va a gustar ese detalle.
La contraseña va en un .my.cnf temporal con permiso 0600, nunca en la línea de comandos, así que no aparece ni en la ps ni en los logs.
Lo que no tienes en MySQL/MariaDB: backup físico, incremental o PITR con binlog. Para bases de datos grandes (el propio sitio del proyecto habla de algo por encima de 100 GB) o cuando necesitas volver al segundo exacto antes de un DELETE erróneo, sigue con mariabackup/XtraBackup y binlog, como mostré en el post de clúster MariaDB Galera con mariabackup. La verificación automática de restore, descrita más abajo, también es solo para PostgreSQL por ahora. Para la base de datos de un WordPress, un GLPI o un Nextcloud de tamaño medio, el dump diario con retención GFS resuelve bien.
Cómo funciona por dentro
Databasus se ejecuta lejos del banco. Se conecta a través de la red, como cualquier cliente, y extrae el volcado en streaming, bloque a bloque. No se instala nada en el servidor de base de datos. Si la base de datos está en una red cerrada, accede mediante un túnel SSH a través de un bastión. Esto también significa que funciona con bases de datos gestionadas (RDS, Cloud SQL, Azure Database), que no permiten instalar nada en el host.
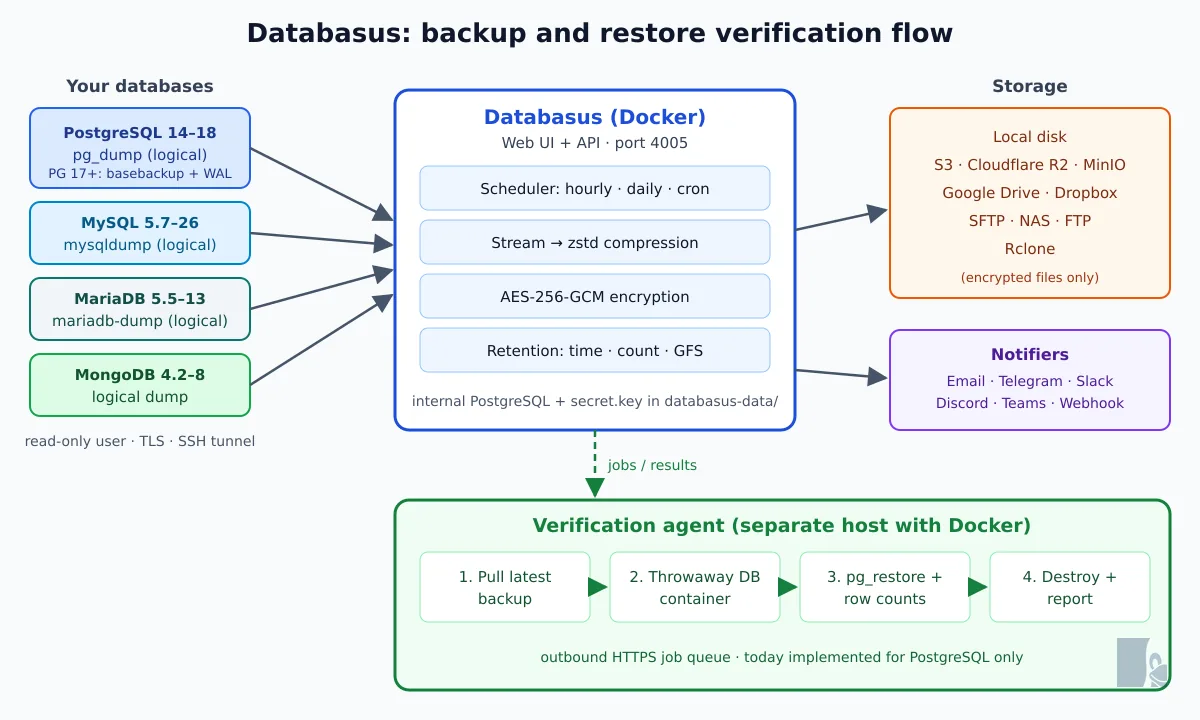
El flujo de cada copia de seguridad:
- el programador se activa en el horario (cada hora, diario, semanal, mensual o cron);
- el volcado sale de la base de datos en streaming y se comprime con zstd (en PostgreSQL, formato custom de
pg_dumpcon zstd nivel 5); - cada archivo se cifra con AES-256-GCM, con su propia clave derivada de la clave maestra, del ID de la copia de seguridad y de una sal aleatoria;
- el archivo va al almacenamiento elegido, que solo ve datos cifrados;
- la política de retención elimina los antiguos: por tiempo, por cantidad, por tamaño o en el esquema GFS (abuelo-padre-hijo, con copias por hora, día, semana, mes y año);
- el notificador avisa del éxito o del fallo.
El estado interno (programaciones, usuarios, historial) se guarda en un PostgreSQL integrado en la propia imagen, en databasus-data/pgdata, y las credenciales de las bases de datos quedan cifradas con la clave databasus-data/secret.key. Guarda esta clave en otro lugar: sin ella, las copias de seguridad cifradas se convierten en basura.
Instalación
Hay cuatro caminos: script automático, docker run, Docker Compose y Helm. Si Docker aún es novidade, el artículo A história do Docker proporciona el contexto.
Script (Debian/Ubuntu)
Instala Docker y Compose si faltan, ponlo todo en /opt/databasus/ y configura el inicio automático al arrancar:
sudo apt-get install -y curl
curl -sSL https://raw.githubusercontent.com/databasus/databasus/refs/heads/main/install-databasus.sh -o install-databasus.sh
less install-databasus.sh     # leia antes de rodar como root
sudo bash install-databasus.sh
Docker Compose
Es el camino que prefiero, porque queda versionado junto con el resto de la infraestructura:
services:
  databasus:
    container_name: databasus
    image: databasus/databasus:latest
    ports:
      - "127.0.0.1:4005:4005"
    volumes:
      - ./databasus-data:/databasus-data
    restart: unless-stopped
    healthcheck:
      test: ["CMD", "databasus", "healthcheck"]
      interval: 30s
      timeout: 5s
      retries: 3
      start_period: 60s
mkdir -p /opt/databasus && cd /opt/databasus
# salve o docker-compose.yml acima aqui
docker compose up -d
docker compose psHe publicado el puerto solo en 127.0.0.1 a propósito: la interfaz guarda credenciales de todas tus bases de datos, así que queda detrás de un proxy inverso con TLS, no expuesta en crudo en internet. Si Docker Hub limita el pull, la misma imagen está en ghcr.io/databasus/databasus:latest. En producción, cambia latest por una etiqueta fija.
Kubernetes con Helm
helm install databasus oci://ghcr.io/databasus/charts/databasus \
  -n databasus --create-namespace \
  --set ingress.enabled=true \
  --set ingress.hosts[0].host=backup.exemplo.com.br
El chart también acepta service.type=LoadBalancer, NodePort y HTTPRoute de Gateway API. En bare metal, el MetalLB entrega la IP del LoadBalancer.
Compilando la imagen a partir del código
Si su política exige imagen construida en casa (auditoría, registro interno, sin pull de Docker Hub), el Dockerfile en la raíz del repositorio lo hace todo por etapas: frontend con Node 24 y pnpm, backend y agente de verificación con Go 1.26, e imagen final en debian:bookworm-slim con los clientes de base de datos ya incrustados en el repositorio (assets/tools, unos 320 MB de binarios de pg_dump, mysqldump e mariadb-dump por versión). Use siempre una etiqueta de release, no la main:
git clone --depth 1 --branch v3.60.0 https://github.com/databasus/databasus.git
cd databasus
docker build --build-arg APP_VERSION=v3.60.0 -t registry.exemplo.com.br/databasus:v3.60.0 .
docker push registry.exemplo.com.br/databasus:v3.60.0
En mi prueba, en una máquina con caché vacía, la compilación tardó unos 2 minutos y 15 segundos y generó una imagen de 800 MB, el mismo tamaño que la oficial. El APP_VERSION aparece en la interfaz y en /api/v1/system/version. No docker-compose.yml, basta cambiar la línea image: por su etiqueta.
Proxy inverso con nginx
server {
    listen 443 ssl http2;
    server_name backup.exemplo.com.br;

    ssl_certificate     /etc/letsencrypt/live/backup.exemplo.com.br/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/backup.exemplo.com.br/privkey.pem;

    client_max_body_size 0;

    location / {
        proxy_pass http://127.0.0.1:4005;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_set_header X-Forwarded-Proto $scheme;
    }
}
Abre https://backup.exemplo.com.br y cree la primera cuenta: ella se convierte en la administradora de la instancia, así que hazlo justo después de levantarla, antes de que cualquier otra persona llegue a la pantalla.
Copia de seguridad de MariaDB y MySQL paso a paso
1. Usuario solo de lectura
Databasus trabaja por defecto con un usuario de solo lectura y comprueba los privilegios antes de ejecutarse. Por el código, SELECT e SHOW VIEW son obligatorios; sin TRIGGER e EVENT la copia de seguridad no falla, pero deja fuera los triggers y los eventos. Así que concede los cuatro:
CREATE USER 'databasus'@'10.0.0.50' IDENTIFIED BY 'troque-esta-senha';
GRANT SELECT, SHOW VIEW, TRIGGER, EVENT ON wordpress.* TO 'databasus'@'10.0.0.50';
FLUSH PRIVILEGES;
Sustituya 10.0.0.50 por la IP del servidor de Databasus y wordpress por tu esquema. Si MariaDB escucha solo en 127.0.0.1, no abras el puerto 3306: usa el túnel SSH integrado.
2. Registrar la base de datos
- New Database → elige MySQL o MariaDB;
- host, puerto, usuario, contraseña y base de datos (o túnel SSH y TLS);
- programación: por ejemplo, diario a las 03:00, fuera del horario punta;
- storage: disco local, S3 (AWS, MinIO, Backblaze B2), Cloudflare R2, Google Drive, Dropbox, SFTP, FTP o cualquier destino de rclone;
- retención: GFS es el valor predeterminado sensato, por ejemplo 7 diarios, 4 semanales, 12 mensuales;
- notificación: Telegram, Slack, Discord, Teams, Mattermost, correo electrónico o webhook.
Al guardar, valida la conexión y los privilegios, detecta la versión del servidor por sí mismo e indica si falta algún grant. Dos detalles que vi en la prueba: al activar las copias de seguridad, lanza la primera copia de seguridad en el momento, así que comprueba antes si la opción Encryption está en Encrypted (es el valor predeterminado de la interfaz para la copia lógica). Sin cifrado, el archivo en el almacenamiento es un .zst legible por cualquiera que tenga acceso al bucket.
Un buen truco de las FAQ del proyecto: si tienes réplica, apunta la copia de seguridad a ella. El --single-transaction no detiene la replicación y quita carga del primario.
3. Restaurar
El dump es un mysqldump estándar, comprimido con zstd. Descargue el backup por la interfaz (sale ya descifrado, como .sql.zst) y restáurelo en cualquier MySQL/MariaDB, en otra versión u otro proveedor. La interfaz muestra el comando exacto de cada backup; el formato es este:
zstd -dc wp-lab_backup_2026-09-24_10-23-28.sql.zst | mariadb -h 127.0.0.1 -u root -p wordpress_restoreHaga esto al menos una vez, en una base de datos de prueba, antes de necesitarlo. Es la única forma de saber cuánto tarda el restore de verdad.
PostgreSQL: físico, incremental y PITR
Aquí Databasus va mucho más allá del dump. A partir del PostgreSQL 17, que trajo backup incremental nativo a nivel de bloque (desarrollado por Robert Haas, con ayuda de David Steele, autor de pgBackRest), hace:
- full con
pg_basebackup, transmitido directo a Databasus; - incremental con
pg_basebackup --incremental: el servidor, consummarize_wal = on, sabe qué bloques cambiaron y solo ellos viajan; - WAL streaming continuo con
pg_receivewal, que cierra la cadena entre un backup y otro.
En el restore, el pg_combinebackup combina el full con los incrementales en un directorio de datos y PostgreSQL reaplica el WAL hasta el instante que elijas. Es PITR de verdad, con RPO cercano a cero. Todo mediante el protocolo de replicación, remoto, sin instalar nada en el servidor de la base.
En el servidor PostgreSQL, habilita el resumen de WAL y permite la replicación para el usuario del backup:
sudo -u postgres psql -c "ALTER SYSTEM SET summarize_wal = on;"
sudo -u postgres psql -c "SELECT pg_reload_conf();"
sudo -u postgres psql -c "CREATE ROLE databasus WITH LOGIN REPLICATION PASSWORD 'troque-esta-senha';"
# pg_hba.conf: host replication databasus 10.0.0.50/32 scram-sha-256
En las versiones 14 a 16, solo el backup lógico con pg_dump está disponible.
Una nota de historia: las versiones antiguas utilizaban un agente de backup instalado en el host de la base. El proyecto admite en la FAQ que fue un error (RTO largo, dos cosas para configurar, no funciona en RDS) y lo eliminó. Quien aún tiene backups de ese tipo puede quedarse en el v3.42.0, la última que las admite; la actualización avisa antes de tocar nada. El razonamiento está en ADR-0009.
Verificación de la restauración: la copia de seguridad probada de verdad
Una copia de seguridad que termina sin error no es una copia de seguridad que restaura. El checksum detecta un bit podrido en el archivo, pero no dice si el volcado está completo. El código de salida indica que el comando se ejecutó, pero no detecta un usuario sin permisos sobre un objeto, una extensión ausente o un tablespace diferente, casos en los que los objetos desaparecen del volcado en silencio.
A verificación de restauración lo resuelve restaurando de verdad. Un agente de verificación, un binario pequeño en Go que se ejecuta en una máquina tuya con Docker:
- toma la copia de seguridad más reciente de la cola de Databasus (conexión HTTPS saliente, no hay que abrir nada hacia dentro);
- levanta un contenedor de base de datos desechable en la misma versión principal;
- ejecuta la restauración con la herramienta nativa y comprueba el tamaño restaurado;
- cuenta las líneas de cada tabla;
- destruye el contenedor y envía el informe.
Límite actual: en el código del agente, la restauración solo está implementada para PostgreSQL (pg_restore, con imagen Docker solo de Postgres). Para MySQL y MariaDB, la prueba de restauración sigue siendo manual, como en la sección anterior.
Levantando el agente
En Settings → Verification agents → Create verification agent, pon un nombre (verificador-01) y copia el token, que solo aparece una vez. En la máquina de verificación:
curl -L -o verification-agent \
  "https://backup.exemplo.com.br/api/v1/system/verification-agent?arch=amd64" \
  && chmod +x verification-agent

./verification-agent start \
  --databasus-host=https://backup.exemplo.com.br \
  --agent-id=<AGENT_ID> \
  --token=<TOKEN> \
  --max-cpu=2 \
  --max-ram-mb=2048 \
  --max-disk-gb=20 \
  --max-concurrent-jobs=1
Sustituya amd64 por arm64 en ARM. Los --max-* son presupuestos totales, divididos entre los jobs simultáneos, con un mínimo de 1 CPU y 512 MB por job. El disco es lo que más falla: cada job necesita el tamaño de la copia de seguridad, más el tamaño de la base de datos restaurada, más un margen de hasta 5 GB. Databasus debe estar en https://; HTTP plano solo con --allow-insecure-http, para laboratorio.
O start se convierte en daemon y guarda las flags en databasus-verification.json. Para ejecutarlo bajo systemd, use run, que se ejecuta en primer plano y lee las mismas flags guardadas. Haga el primero start dentro de /opt/databasus-agent, para que el JSON quede allí:
# /etc/systemd/system/databasus-verification.service
[Unit]
Description=Databasus verification agent
After=docker.service network-online.target
Requires=docker.service

[Service]
WorkingDirectory=/opt/databasus-agent
ExecStart=/opt/databasus-agent/verification-agent run
Restart=on-failure

[Install]
WantedBy=multi-user.target
cd /opt/databasus-agent
./verification-agent stop # para o daemon criado pelo start
sudo systemctl daemon-reload
sudo systemctl enable --now databasus-verification
./verification-agent statusSi el systemd sigue siendo un territorio inexplorado, la publicación dedicada ayuda.
Programando
En la configuración de cada base de datos, active Scheduled verification y elija:
- After backup: cada copia de seguridad exitosa se verifica a continuación. La garantía más sólida. Si llega una copia de seguridad nueva antes de que termine la verificación anterior, la pendiente se cancela y solo la más reciente queda en la cola;
- por horas, diario, semanal, mensual con horario;
- cron en UTC, por ejemplo
0 4 * * 0(domingo a las 04:00 UTC).
Las notificaciones de éxito y de fallo son independientes. Active solo la de fallo para no generar ruido. Cada comprobación muestra línea de tiempo, código de salida, tamaño restaurado, número de esquemas y tablas y el recuento de filas por tabla.
Lo probé en el laboratorio
Antes de escribir, desplegué la v3.60.0 en contenedores locales: la imagen oficial y la compilada a partir del Dockerfile, apuntando a un MariaDB 11.8 y un MySQL 8.4 con tabla, vista, trigger y evento, usando el usuario con solo SELECT, SHOW VIEW, TRIGGER, EVENT. El resultado:
- la versión del servidor se detectó sola y los privilegios se registraron como
EVENT,SELECT,SHOW VIEW,TRIGGER; - backups de MariaDB y MySQL completados en menos de un segundo, con estado
COMPLETED; - en el almacenamiento local, el backup cifrado es un blob opaco, acompañado de un
.metadatacon salt e IV; sin cifrado, es un.zstcon el SQL legible; - la descarga por la interfaz ya sale descifrada (
.sql.zst); restaurado conzstd -dcen una base de datos nueva, volvieron las filas, la vista, el trigger en MariaDB y el evento en MySQL; - la imagen compilada localmente se comportó igual que la oficial.
Seguridad
- AES-256-GCM en los archivos de copia de seguridad y en los secretos guardados (contraseñas, tokens, cadenas de conexión), que no aparecen ni en mensajes de error;
- storage “zero trust”: el bucket solo recibe archivos cifrados, por lo que una filtración del S3 no entrega sus datos;
- usuario de solo lectura por defecto;
- workspaces con roles viewer, member, admin y owner, y registro de auditoría, exportable a través de OpenTelemetry;
- 2FA por código enviado por correo electrónico al iniciar sesión con contraseña; también se acepta el inicio de sesión con Google o GitHub.
En el lado del código, el pipeline ejecuta CodeQL, gitleaks, semgrep, Dependabot, Trivy sobre la imagen y el Dockerfile, y cada PR realiza ciclos completos de backup y restore contra contenedores reales de todas las versiones soportadas. El README también es transparente sobre la IA: el proyecto entró en los programas Claude for Open Source y Codex for Open Source en marzo de 2026, utiliza IA para revisión y búsqueda de fallos y rechaza los PRs “vibe code”.
No olvides la copia de seguridad del propio Databasus
Parece obvio, pero es el punto que derriba toda la estrategia. En /opt/databasus/databasus-data/ (o donde montaste el volumen):
secret.key: obligatorio. Solo con él ya se puede recuperar las copias de seguridad sin Databasus;pgdata/: configuraciones, programaciones e historial, necesario para reconstruir la interfaz;backups/: si usas almacenamiento local.
cd /opt/databasus
docker compose stop
tar czf /root/databasus-data-$(date +%F).tar.gz databasus-data/
docker compose start
Guárdelo secret.key en un gestor de contraseñas, como el Vaultwarden, fuera del servidor. Para migrar de máquina, basta recrear la carpeta databasus-data con esos archivos y levantar el contenedor. Si se pierde la contraseña de admin:
docker exec -it databasus ./main --list-admins
docker exec -it databasus ./main --new-password="NovaSenhaForte123" --email="admin@exemplo.com.br"
Cuándo usarlo, cuándo no
Merece la pena si tienes varias bases de datos pequeñas y medianas dispersas (WordPress, GLPI, Zabbix, sistemas internos) y hoy dependen de scripts con cron que nadie monitoriza. Databasus lo cambia por una pantalla con calendario, retención, cifrado, alertas e historial, y en PostgreSQL además ofrece restore probado automáticamente y, a partir de 17, PITR.
No sustituye o mariabackup/XtraBackup con binlog en MySQL/MariaDB grandes ni cuando el RPO necesita ser de segundos en esas bases. Tampoco es una herramienta de backup de archivos: para directorios y volúmenes, continúa con restic, borg o similares. Y, como toda pieza de backup, monitoriza el propio Databasus: el healthcheck del contenedor se integra fácilmente en Uptime Kuma o en Gatus.
El resumen: un backup que nunca se ha restaurado es esperanza, no backup. Databasus no lo resuelve todo, pero hace que el restore probado sea lo bastante barato como para convertirse en rutina.
Enlaces: GitHub · instalación · MySQL y MariaDB · verificación de restauración · FAQ · seguridad