
Tres Ubuntu, un Galera, SST con mariabackup. No es réplica asíncrona: cada nodo acepta escritura y la mayoría decide quién sigue en pie. Dos nodos no bastan: si cae uno, el otro queda solo, sin mayoría. A continuación, el clúster de tres del paquete galera_new_cluster, en Ubuntu 24.04 y en 26.04, con copia de seguridad en caliente y la recuperación de cuando todo se cae.
Tres nodos, un quórum
Galera, de la finlandesa Codership, entra en MariaDB como la biblioteca libgalera_smm.so (paquete galera-4, API wsrep 26.4.x). Cada commit se convierte en un writeset: los demás nodos lo reciben y certifican antes de que el commit regrese al cliente, y lo aplican inmediatamente después. Solo InnoDB; MyISAM en el clúster es dolor.
Cuando un nodo entra o vuelve, necesita los datos. Si ha estado fuera poco tiempo, solo recibe lo que perdió (IST, a partir de la caché gcache de un vecino). Si es nuevo o ha estado fuera mucho tiempo, recibe la base entera (SST). El SST por rsync bloquea al donante durante la copia; el mysqldump es lento. El mariabackup copia en caliente, envía el flujo por socat en el puerto 4444 y el donante continúa atendiendo. Por eso tres servidores y ese SST.
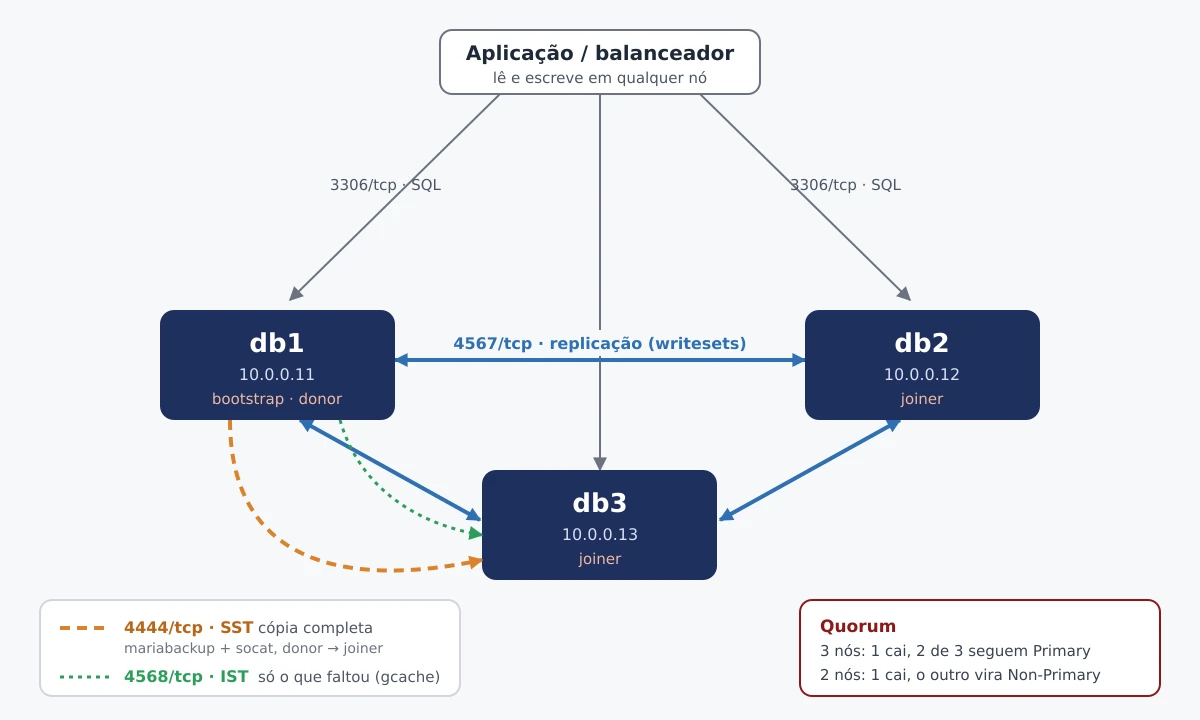
Las IP de este howto — cámbialas por las tuyas:
db1  10.0.0.11
db2  10.0.0.12
db3  10.0.0.13
Misma versión de MariaDB en los tres, mismo wsrep_cluster_name, reloj sincronizado (chrony) y disco local — datadir en NFS, no.
El mapa en septiembre de 2026
- Ubuntu 24.04 (noble): MariaDB 10.11.14 en
noble-updatesegalera-426.4.16 enuniverse. En mayo de 2026 MariaDB publicó correcciones de seguridad de Galera (10.6.27, 10.11.18, 11.4.12 y 11.8.8). Hasta el cierre de este post, la actualización de noble para la 10.11.18 aún no había salido (LP #2158958). Para clúster en producción en 24.04, usa el repositorio de MariaDB. - Ubuntu 26.04 (resolute): MariaDB 11.8.6 e
galera-426.4.25, ambos enmain. El paquete11.8.6-5ubuntu0.1ya incluye las correcciones de mayo. La 11.8 es LTS, con soporte de la comunidad hasta junio de 2028. - El repositorio de MariaDB también publica paquetes para 26.04, pero solo de la 11.8 en adelante; el script de instalación rechaza la 10.11 en resolute.
- Binario de backup:
mariadb-backup. El valor dewsrep_sst_methodcontinúamariabackup— el nombre antiguo. No los mezcles.
Quien vaya a poner PHP delante de la base de datos: Nginx y varias versiones de PHP. El GLPI es uno de los clientes típicos de este clúster.
Paquetes
En los tres nodos. Ubuntu 26.04, directamente desde la distro:
sudo apt update
sudo apt install -y mariadb-server mariadb-backup galera-4 socat
Ubuntu 24.04 con la 11.8 del repositorio de MariaDB (recomendado, por el parche de seguridad):
sudo apt install -y curl ca-certificates
curl -LsS https://r.mariadb.com/downloads/mariadb_repo_setup \
  | sudo bash -s -- --mariadb-server-version="11.8"
sudo apt update
sudo apt install -y mariadb-server mariadb-backup galera-4 socat
La biblioteca se encuentra en /usr/lib/libgalera_smm.so, con un enlace en /usr/lib/galera/libgalera_smm.so, tanto en el paquete de Ubuntu como en el de MariaDB. Cualquiera de los dos sirve en el wsrep_provider. Compruébalo en tu equipo:
dpkg -L galera-4 | grep libgalera_smm.so
La instalación ya dejó un MariaDB funcionando por sí solo. Detenlo antes de configurar:
sudo systemctl stop mariadb
sudo systemctl enable mariadb
El datadir cambió en 26.04: la instalación nueva usa /var/lib/mariadb; quien actualizó desde una versión anterior sigue en /var/lib/mysql (vía 99-legacy-datadir.cnf). En 24.04 es /var/lib/mysql. Compruébelo con mariadbd --help --verbose | grep ^datadir.
Red, cortafuegos y AppArmor
Galera usa cuatro puertos. Ábrelos solo entre las tres IP, nunca hacia el mundo:
3306/tcp— cliente SQL4567/tcp— replicación (y UDP, solo si usas multicast)4568/tcp— IST4444/tcp— SST de mariabackup/socat
NET=10.0.0.0/24
for p in 3306 4567 4568 4444; do
  sudo ufw allow proto tcp from "$NET" to any port "$p"
done
sudo ufw reload
En el /etc/hosts de las tres:
10.0.0.11  db1
10.0.0.12  db2
10.0.0.13  db3
AppArmor en 26.04. El paquete pasó a traer el perfil /etc/apparmor.d/mariadbd en modo enforce, y no tiene reglas para los scripts de SST (wsrep_sst_mariabackup, socat, mariadb-backup). Si el joiner falla y el dmesg mostrar apparmor="DENIED", ponga el perfil en modo de queja:
sudo apt install -y apparmor-utils
sudo aa-complain /etc/apparmor.d/mariadbd
sudo dmesg -T | grep -i apparmor | tail
En 24.04 el perfil del paquete viene vacío, sin confinamiento; no hay nada que hacer.
El timeout de systemd no molesta: el mariadb.service ya trae TimeoutStartSec=900, y durante el SST el propio servidor avisa a systemd cada 60 s para ampliar el plazo. No hace falta un drop-in.
60-galera.cnf
Ubuntu ya trae /etc/mysql/mariadb.conf.d/60-galera.cnf, todo comentado. Sustituya el contenido por este. Entre los nodos solo cambian wsrep_node_name e wsrep_node_address.
En db1:
[galera]
wsrep_on=ON
wsrep_provider=/usr/lib/galera/libgalera_smm.so
wsrep_cluster_name="linuxpro"
wsrep_cluster_address="gcomm://10.0.0.11,10.0.0.12,10.0.0.13"
wsrep_node_name=db1
wsrep_node_address=10.0.0.11
wsrep_sst_method=mariabackup
wsrep_sst_auth=mariabackup:troque-esta-senha
wsrep_provider_options="gcache.size=1G;gcache.recover=yes"

binlog_format=ROW
default_storage_engine=InnoDB
innodb_autoinc_lock_mode=2
bind-address=0.0.0.0
En db2 y db3, copie el archivo y cambie solo el nombre y la IP. El gcomm:// lista los tres en todos — Galera ignora la propia dirección. Nunca deje gcomm:// vacío en el archivo: esto crea un clúster nuevo en cada arranque.
O gcache.size define cuánto historial guarda cada nodo para IST. Cuanto mayor, más tiempo puede estar un nodo fuera y aún así volver solo con lo que perdió, en lugar de un SST completo.
En el 50-server.cnf, comenta el bind-address = 127.0.0.1. El 60 se lee después y gana, pero no dependas del orden.
Usuario del SST
El donante ejecuta el mariadb-backup localmente y necesita un usuario con estos privilegios:
CREATE USER 'mariabackup'@'localhost' IDENTIFIED BY 'troque-esta-senha';
GRANT RELOAD, PROCESS, LOCK TABLES, BINLOG MONITOR ON *.* TO 'mariabackup'@'localhost';
BINLOG MONITOR es el nombre desde la 10.5; REPLICATION CLIENT sigue valiendo como alias. El usuario solo conecta en localhost, no lo abras a la red.
En la 11.8 (26.04, o 24.04 con el repositorio de MariaDB) hay un atajo: sin wsrep_sst_auth en el cnf, el servidor crea y elimina por su cuenta un usuario temporal para cada SST (MDEV-31809, desde la 11.6). En ese caso, elimina la línea wsrep_sst_auth de los tres archivos y sáltate el CREATE USER. En la 10.11 el usuario es obligatorio.
Bootstrap y los dos joiners
Los tres están detenidos, con el cnf en disco. Solo el primer nodo crea el clúster:
# em db1
sudo galera_new_cluster
Es un wrapper que arranca el mariadbd con --wsrep-new-cluster. Comprueba:
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size';
SHOW GLOBAL STATUS LIKE 'wsrep_local_state_comment';
SHOW GLOBAL STATUS LIKE 'wsrep_ready';
Esperado: size 1, Synced, ON. Cree ahora el usuario del SST en db1 (sección anterior) — se replica a los demás cuando se unan. Después:
# em db2; quando ele estiver Synced, em db3
sudo systemctl start mariadb
El joiner solicita el SST al donante. Acompañe con journalctl -u mariadb -f. Durante la transferencia, el datadir recibe mariabackup.backup.log (en el donante) y mariabackup.prepare.log / mariabackup.move.log (en el joiner) — ahí está el motivo cuando falla el SST. Los archivos mantienen el nombre antiguo, aunque el binario sea mariadb-backup, y los de transferencias anteriores se compactan a /tmp/sst_log_archive. En el laboratorio de este post, con la base pequeña, cada joiner tardó Synced unos 20 segundos.
Con los tres dentro:
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_size';      -- 3
SHOW GLOBAL STATUS LIKE 'wsrep_cluster_status';    -- Primary
SHOW GLOBAL STATUS LIKE 'wsrep_incoming_addresses';
Prueba real: CREATE DATABASE teste_galera; en db1 y SHOW DATABASES; en db3. Si apareció, el writeset pasó.
HAProxy delante del clúster
Con tres nodos, la aplicación necesita una sola dirección, que siga funcionando cuando un nodo cae. HAProxy se encarga de ello en TCP. Y hay un motivo para no repartir las escrituras: Galera acepta escritura en cualquier nodo, pero dos transacciones que tocan la misma fila en nodos distintos generan conflicto de certificación, y una de ellas vuelve con error de interbloqueo en COMMIT. La disposición más segura es escribir en un nodo a la vez y leer de los tres.
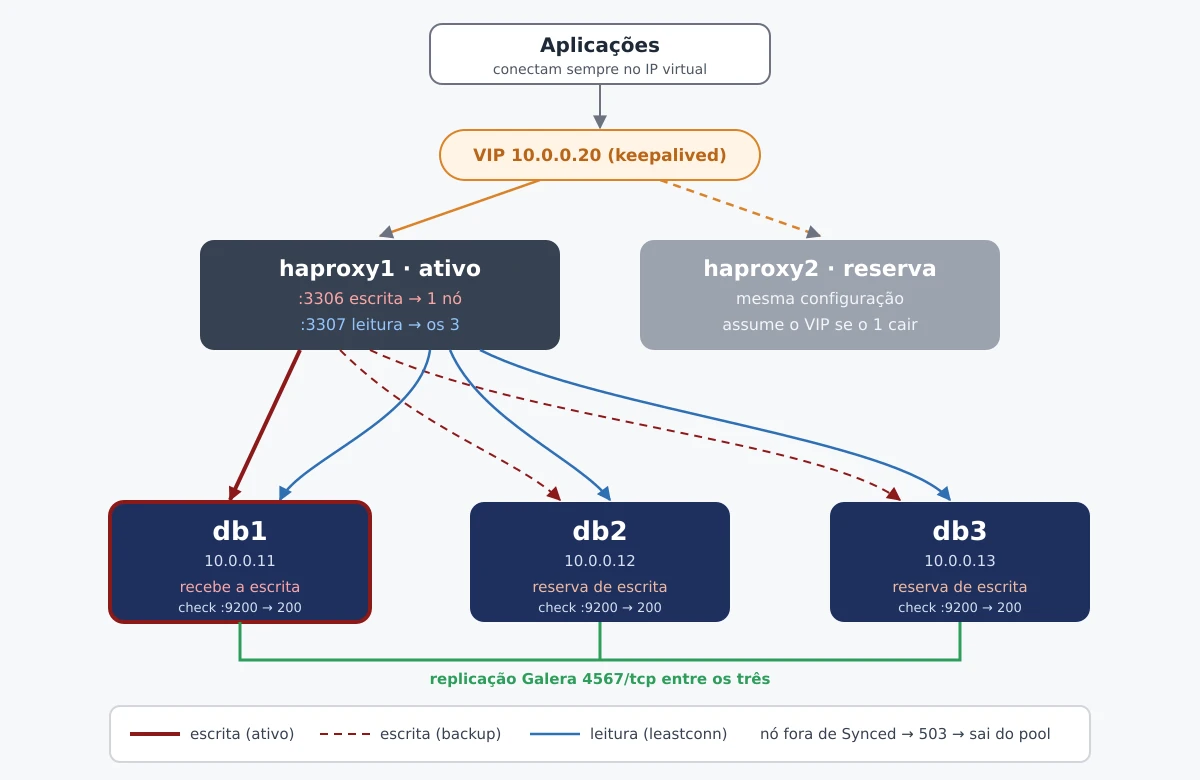
HAProxy expone dos puertos: 3306 para escritura, que envía todo a db1 y usa db2 y db3 solo si cae, y 3307 para lectura, distribuida entre los tres. Si la aplicación no separa lectura de escritura, use solo la 3306.
Health check: TCP no basta
Un nodo en Donor/Desynced, aún sincronizando o fuera del quórum acepta conexiones TCP normalmente — solo que no sirve datos fiables. El check debe preguntarle a Galera. Este script responde HTTP 200 cuando wsrep_local_state es 4 (Synced) y 503 en cualquier otro caso. En los tres nodos:
sudo tee /usr/local/bin/galera-check >/dev/null <<'EOF'
#!/bin/bash
# Responde HTTP 200 só quando o nó está Synced (wsrep_local_state = 4).
# Lê o pedido até a linha em branco; fechar sem ler faz o kernel mandar RST.
while read -r -t 2 line; do [ -z "${line%$'\r'}" ] && break; done
state=$(mariadb -N -s -e "SHOW GLOBAL STATUS LIKE 'wsrep_local_state'" 2>/dev/null | cut -f2)
if [ "$state" = "4" ]; then
  printf 'HTTP/1.1 200 OK\r\nContent-Type: text/plain\r\nConnection: close\r\n\r\nSynced\r\n'
else
  printf 'HTTP/1.1 503 Service Unavailable\r\nContent-Type: text/plain\r\nConnection: close\r\n\r\nNot synced (%s)\r\n' "${state:-down}"
fi
EOF
sudo chmod 755 /usr/local/bin/galera-check
sudo useradd -r -s /usr/sbin/nologin galera-check
El script se conecta sin contraseña: el usuario de MariaDB se autentica por el usuario del sistema (unix_socket) y no necesita ningún privilegio para leer el estado. Créelo una vez, en cualquier nodo — se replica:
CREATE USER 'galera-check'@'localhost' IDENTIFIED VIA unix_socket;
El systemd escucha el puerto 9200 y ejecuta el script en cada conexión. En los tres nodos, /etc/systemd/system/galera-check.socket:
[Unit]
Description=Health check HTTP do Galera (porta 9200)

[Socket]
ListenStream=9200
Accept=yes

[Install]
WantedBy=sockets.target
e /etc/systemd/system/galera-check@.service:
[Unit]
Description=Health check HTTP do Galera

[Service]
User=galera-check
ExecStart=/usr/local/bin/galera-check
StandardInput=socket
StandardOutput=socket
StandardError=journal
sudo systemctl daemon-reload
sudo systemctl enable --now galera-check.socket
curl -s http://127.0.0.1:9200/      # Synced
Abra la 9200 solo para las IPs de los HAProxy (sudo ufw allow proto tcp from 10.0.0.21 to any port 9200, y lo mismo para el .22).
El haproxy.cfg
En las máquinas del HAProxy (fuera de los nodos de la base de datos):
sudo apt install -y haproxy
Añade al /etc/haproxy/haproxy.cfg, manteniendo el bloque global del paquete:
defaults galera
    mode    tcp
    log     global
    option  tcplog
    timeout connect 5s
    timeout client  8h
    timeout server  8h

# Escrita: um nó só por vez; os outros dois assumem se ele cair
frontend galera_escrita from galera
    bind *:3306
    default_backend galera_escrita

backend galera_escrita from galera
    option httpchk GET /
    http-check expect status 200
    default-server port 9200 inter 2s fall 3 rise 2 on-marked-down shutdown-sessions
    server db1 10.0.0.11:3306 check
    server db2 10.0.0.12:3306 check backup
    server db3 10.0.0.13:3306 check backup

# Leitura: os três, quem tiver menos conexões
frontend galera_leitura from galera
    bind *:3307
    default_backend galera_leitura

backend galera_leitura from galera
    balance leastconn
    option httpchk GET /
    http-check expect status 200
    default-server port 9200 inter 2s fall 3 rise 2 on-marked-down shutdown-sessions
    server db1 10.0.0.11:3306 check
    server db2 10.0.0.12:3306 check
    server db3 10.0.0.13:3306 check

listen estatisticas from galera
    mode http
    bind 127.0.0.1:8404
    stats enable
    stats uri /
    stats refresh 5s
sudo haproxy -c -f /etc/haproxy/haproxy.cfg
sudo systemctl reload haproxy
Los detalles que importan:
fall 3coninter 2s: un nodo sale del pool después de tres checks fallidos, unos 6 segundos.rise 2exige dos buenos para volver.on-marked-down shutdown-sessionstira las conexiones abiertas en el nodo que cayó, para que la aplicación reconecte en el siguiente en lugar de quedarse colgada.timeout client/server 8hacompaña elwait_timeoutestándar de MariaDB (28800 s). Con un timeout menor, HAProxy corta conexiones ociosas del pool antes que la base de datos.- Los usuarios de la aplicación pasan a llegar con la IP del HAProxy: créelos como
'app'@'10.0.0.%', no con la IP de la aplicación.
Pruebe por el balanceador:
mariadb -h 10.0.0.21 -P 3306 -u app -p -e 'SELECT @@hostname'   # sempre db1
mariadb -h 10.0.0.21 -P 3307 -u app -p -e 'SELECT @@hostname'   # alterna entre os três
En el laboratorio de esta entrada, con el db1 caído, la escritura pasó al db2 en menos de 10 segundos y, por INSERT el puerto 3306 entró con normalidad. Cuando el db1 volvió (por IST, solo con las transacciones que perdió), el HAProxy devolvió la escritura a él. Para ver el estado de los backends: ssh -L 8404:127.0.0.1:8404 en la máquina del HAProxy y abre http://127.0.0.1:8404/.
Un HAProxy por sí solo se convierte en el nuevo punto único de fallo. En producción, ejecute dos, con la misma configuración, y el keepalived manteniendo una IP virtual (VRRP) entre ellos, como en el diagrama; la aplicación apunta a esa IP.
Copia de seguridad en caliente
La copia de seguridad del cluster es copia de seguridad de un nodo. Preferiblemente, saque ese nodo del balanceador, porque se vuelve más lento durante la copia:
sudo mkdir -p /backup    # o mariadb-backup não cria o diretório pai
sudo mariadb-backup --backup --galera-info \
  --target-dir=/backup/full-$(date +%F) \
  --user=mariabackup --password='troque-esta-senha'
sudo mariadb-backup --prepare --target-dir=/backup/full-$(date +%F)
No hace falta SET GLOBAL wsrep_desync=ON: en Galera, el mariadb-backup ya se desincroniza y pausa el nodo solo en la fase de bloqueo. El nodo sigue en el cluster, recibe los writesets en una cola y la vacía después — no hay IST. El --galera-info guarda la posición del cluster en el archivo xtrabackup_galera_info, y es lo que permite usar ese backup para reconstruir un nodo.
O --prepare deja el backup consistente. Sin él, el directorio no sirve para restaurar.
Cuando se cae el clúster entero
Si los tres caigan juntos, el cluster acabó — los datos no. En cada nodo, mire el grastate.dat en el datadir:
sudo cat /var/lib/mysql/grastate.dat # ou /var/lib/mariadb no 26.04
Apagado limpio: el nodo con safe_to_bootstrap: 1 (el último en salir) es el que arranca primero. Caída brusca: todos se quedan con seqno: -1 e safe_to_bootstrap: 0. Descubra la posición real en cada uno:
sudo galera_recovery
El nodo con el número más alto después de : es el más avanzado. Solo en él, edite el grastate.dat para safe_to_bootstrap: 1 y:
sudo galera_new_cluster          # no nó mais avançado
sudo systemctl start mariadb     # nos outros dois, um de cada vez
Nunca ejecute galera_new_cluster con algún nodo aún en marcha: nace un clúster nuevo con otro UUID y tendrá dos bases de datos divergiendo (split-brain).
Actualizando la versión mayor
Quien está en la 10.11 del 24.04 y va a la 11.8: el SST por mariabackup no funciona entre algunas versiones mayores, porque el formato del redo log cambió en la 10.5 y en la 10.8 (MDEV-27437). Durante la migración use wsrep_sst_method=rsync, que cruza versiones, o detenga los tres, actualice todos y haga el bootstrap de nuevo.
Lo que suele romperse
wsrep_sst_method=mariadb-backup— nombre incorrecto. Esmariabackup; no existe scriptwsrep_sst_mariadb-backup.- AppArmor en el 26.04 denegando el SST; el registro de MariaDB solo dice “SST failed”. Vea el
dmesg. socatausente en el donante o en el joiner.- Puerto 4444 cerrado en el firewall: el joiner espera y el SST muere por timeout.
- Dos nodos: uno cae y el otro se convierte
Non-Primaryy deja de aceptar escritura. Use tres, o dos más un árbitrogarbd. bind-address=127.0.0.1aún activo: los demás no conectan.- Tabla MyISAM o sin clave primaria: replica mal o ni siquiera replica. Conviértala a InnoDB y cree la PK.
Referencias: código del provider en github.com/codership/galera · Getting Started · SST con mariadb-backup · Configuring MariaDB Galera Cluster · paquetes DEB.